Conversão de tipos em Go: estouro, strings, runes e strconv
Go não converte tipos sozinho. Veja por que um int8 guarda 300 como 44, como texto vira bytes e runes e como strconv devolve erros.
iniciantePublicada em · 30 min de leitura
Pense numa tábua de passar roupa e numa caixa de sapatos. A tábua entra na caixa se você dobrar as pontas, e a caixa não reclama de nada. Só que a tábua que saiu já não tem o mesmo formato da que entrou, e a caixa não avisa. Converter um valor de um tipo para outro em Go é parecido: a linguagem faz a operação que você pediu, o resultado pode não representar mais o valor original, e na maioria das vezes ninguém mostra erro na tela. O trabalho de quem programa é saber quando isso acontece antes que aconteça em produção.
Esta aula é a segunda da fase de fundamentos da Trilha de Go. Ela responde quatro perguntas. Por que Go não converte tipos sozinho, mesmo quando parece óbvio. O que acontece com um número quando ele é convertido para um tipo menor ou para um tipo de ponto flutuante. Como um texto se comporta quando vira bytes ou runes, e por que essas duas palavras não são sinônimos. E como ler e escrever números a partir de texto, com a biblioteca strconv e seus erros.
Pré-requisitos: é útil ter visto Bits e binário, porque a conta de overflow depende de quantos bits cabem num tipo, e Inteiros, complemento de dois e overflow, que explica o sinal de um inteiro. Para a parte de texto, Texto, ASCII, Unicode e UTF-8 mostra de onde vêm os bytes de um caractere acentuado. A parte de ponto flutuante usa a ideia de Ponto flutuante. Se você não viu nada disso, dá para acompanhar, mas os números vão parecer mágica em vez de consequência.
Todos os programas desta aula foram rodados com a toolchain go1.27.2 darwin/arm64, instalada em /opt/homebrew/bin/go, em 3 de novembro de 2026. As saídas abaixo são copiadas da execução, e o que não foi possível conferir aparece na seção sobre o que não foi confirmado.
Mapa da aula
A aula segue a ordem em que os problemas aparecem na prática. Começa pela regra que mais surpreende quem vem de outras linguagens, a de que Go não converte nada por conta própria. Depois vem a conversão explícita, escrita como T(x), e as duas situações que mais geram bug: reduzir um inteiro, que dá a volta sem aviso, e misturar inteiro com ponto flutuante, que descarta a parte fracionária. Em seguida vêm texto, bytes e runes, a biblioteca strconv para ler e escrever números, os tipos que você define, e o que acontece quando um valor é convertido para uma interface. Fecham a aula os erros comuns, as boas práticas, exercícios com resposta, o glossário, a lista do que não foi confirmado, as fontes e os relacionados.
1. Go não converte tipos sozinho
Na vida real você mistura coisas sem pensar. Some um número inteiro com um decimal e obtém um decimal, e ninguém precisa explicar a conta. Muitas linguagens fazem esse ajuste por baixo dos panos, convertendo um dos lados para o outro para a operação funcionar. Go decidiu não fazer isso. Quando os tipos são diferentes, o compilador recusa o código, e a conta só passa a existir depois que você escreve a conversão de forma explícita.
O exemplo mais simples é atribuir um int32 a uma variável do tipo int64:
package main

import "fmt"

func main() {
	var a int32 = 7
	var b int64 = a
	fmt.Println(b)
}
Saída real do go build, que não gera binário porque o código não compila:
# conversao/e01
e01/main.go:7:16: cannot use a (variable of type int32) as int64 value in variable declaration
Isso parece burocracia, mas tem um motivo. Quando você escreve int64(a), a conversão fica visível para quem lê o código, inclusive quem revisa daqui a seis meses. Se a linguagem fizesse a troca sozinha, o mesmo trecho esconderia uma mudança de tamanho ou de representação que ninguém procurou. Go prefere o aborrecimento de escrever a conversão a uma surpresa silenciosa.
A regra tem uma exceção pequena, e ela é a que costuma confundir. Uma constante sem tipo, como o 2 escrito direto no código, assume o tipo que o contexto pede, desde que o valor caiba nesse tipo. Por isso var f float64 = 2 funciona. Mas a constante 1.5 não cabe em int, e a expressão abaixo é recusada:
package main

import "fmt"

func main() {
	var x int = 3
	var y float64 = x * 1.5
	fmt.Println(y)
}
# conversao/e06
e06/main.go:7:22: 1.5 (untyped float constant) truncated to intO compilador não tenta arredondar o 1.5 para int. Ele percebe que a multiplicação mistura um int com um valor que não tem representação inteira, e para. A mensagem diz exatamente o problema, o que é um bom sinal: o erro de compilação é o caso mais barato de conversão errada que você vai encontrar.
2. A conversão explícita T(x)
Para converter um valor, você escreve o nome do tipo de destino seguido do valor entre parênteses, T(x). Não há biblioteca para importar nem método para chamar. A forma T(x) é uma operação da própria linguagem, com o mesmo peso de um +, e o compilador a verifica junto com o resto do código.
A especificação define quando uma conversão é permitida para um valor que não é constante. Em resumo, o valor precisa ser atribuível ao tipo de destino, ou os dois tipos precisam ter o mesmo tipo subjacente, que é a forma de representação por trás de um tipo definido. Para inteiros e floats, há regras adicionais de conversão numérica, que vêm nas próximas seções. Veja um caso em que a conversão é segura e outro em que ela muda o valor:
package main

import "fmt"

func main() {
	var a int32 = 7
	var b int64 = int64(a)
	var c float64 = float64(b) / 2
	fmt.Println(b, c)
}
Saída real:
7 3.5O int32 para int64 preserva o valor porque o tipo de destino é maior, e nenhum bit se perde. O float64(b) / 2 é o padrão que você vai ver em código de verdade: converte antes de dividir. Sem a conversão, a divisão seria entre inteiros, e o resultado ficaria truncado, como você verá na seção 4. A conversão muda a conta que acontece, e não apenas a forma como ela aparece no código.
Repare que a conversão para um tipo maior costuma ser inofensiva, e a conversão para um tipo menor é onde a história fica interessante. A próxima seção trata desse caso.
3. Reduzir inteiro: o estouro que não avisa
Quando você converte um inteiro para um tipo com menos bits, Go mantém os bits de baixo e descarta o resto. Não há erro, não há exceção e não há valor especial para dizer que algo saiu do intervalo. O resultado é outro número, válido no tipo novo, e é isso que a especificação quer dizer quando afirma que a conversão “sempre produz um valor válido, sem indicação de overflow”.
O programa abaixo mostra o efeito com variáveis, que é o caso que de fato acontece em produção:
package main

import "fmt"

func main() {
	n := 300
	fmt.Println("int8(300) =", int8(n))
	m := 200
	fmt.Println("int8(200) =", int8(m))

	var a, b int8 = 100, 100
	fmt.Println("100 + 100 em int8 =", a+b)

	var contador int8 = 127
	contador++
	fmt.Println("127 + 1 em int8 =", contador)
}
Saída real:
int8(300) = 44
int8(200) = -56
100 + 100 em int8 = -56
127 + 1 em int8 = -128
Três números saíram errados, e nenhum deles gerou mensagem. O int8(300) virou 44. O int8(200) virou -56. E a soma 100 + 100 também deu a volta, porque o overflow de soma funciona do mesmo jeito que o da conversão: o resultado é calculado módulo 2 elevado ao tamanho do tipo, e depois lido no formato com sinal. A especificação diz que, para inteiros com sinal, estouro em +, -, *, / e << não causa panic em tempo de execução, e o valor resultante é determinado pela representação.
Para entender o 300, pense nos bits. Em 16 bits ele é 0000 0001 0010 1100. Um int8 só tem 8 bits, então o que sobra são os 8 de baixo, 0010 1100, que valem 44. O bit de valor 256 simplesmente deixou de existir no tipo de destino. O 200 mostra o segundo efeito. Em 16 bits ele é 0000 0000 1100 1000, e os 8 de baixo são 1100 1000. Num int8, o bit mais alto é o sinal, e esse padrão lê como -56, que é 200 menos 256. A especificação resume a regra: um inteiro com sinal é estendido com sinal até a precisão infinita, depois truncado para o tamanho do tipo de destino. Em tradução livre, a mesma passagem diz que a conversão sempre produz um valor válido e não indica overflow.
Os dois casos estão na figura abaixo, com os bytes desenhados. A ideia é que o truncamento corta a parte de cima e o bit de sinal passa a mandar no resultado.
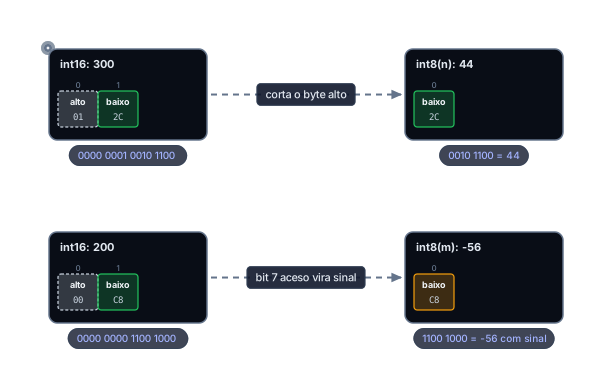
Olhe primeiro a metade de cima, com o int16 de 300. O byte alto, marcado como reservado e tracejado, é o que a conversão joga fora. O byte baixo, em verde, é o único que sobrevive e vira o int8 de 44. Na metade de baixo, o byte baixo do 200 tem o bit 7 aceso, marcado em âmbar, e é esse bit que transforma o mesmo padrão em -56 quando o tipo tem sinal. A figura não mostra a soma que dá a volta, mas o mecanismo é o mesmo.
Quando a constante é conhecida na compilação, o compilador já percebe o problema e recusa o código. Isso acontece com int8(300) escrito direto, e também com uma declaração var x int8 = 300:
package main

import "fmt"

func main() {
	fmt.Println(int8(300))
}
# conversao/e15
e15/main.go:6:19: constant 300 overflows int8Com um inteiro sem sinal, a constante negativa também é recusada, mas uma variável negativa passa sem reclamar:
package main

import (
	"fmt"
	"math"
)

func main() {
	grande := 1e30
	fmt.Println("int64(1e30) =", int64(grande))
	nan := math.NaN()
	fmt.Println("int64(NaN) =", int64(nan))
	n := -1
	fmt.Println("uint8(-1) =", uint8(n))
}
Saída real na arquitetura arm64:
int64(1e30) = 9223372036854775807
int64(NaN) = 0
uint8(-1) = 255
O último número é o que mais vale a pena guardar. Converter -1 para uint8 com a variável n não dá erro e resulta em 255, o padrão de oito bits que todos os bits acesos formam. Com a constante uint8(-1) escrita direto, o compilador recusa com constant -1 overflows uint8. A diferença entre o caso com constante e o caso com variável é a fonte de muita confusão, porque o mesmo código de conversão passa ou não passa dependendo de onde o valor veio.
Um erro comum é achar que uma conversão de tamanho menor só acontece em código de baixo nível. Ela acontece sempre que um valor vindo de fora, como um campo de JSON, um parâmetro de rota ou uma linha de banco, é guardado em um tipo mais estreito para economizar memória. Sem nenhum aviso, o número que chega pode ser outro.
4. Entre inteiros e floats: truncamento e arredondamento
Inteiros e floats guardam números de jeitos bem diferentes. Um inteiro não tem parte fracionária. Um float tem, mas com precisão limitada. Quando você converte de um para o outro, a pergunta passa a ser o que fazer com a parte que não cabe. Go tem uma resposta fixa para a conversão de float para inteiro, e essa resposta é truncar.
A especificação diz que, ao converter um número de ponto flutuante para inteiro, a fração é descartada, com truncamento em direção ao zero. Isso significa que 2,9 vira 2, e que -2,9 vira -2, porque o zero está entre o -2,9 e o -2. Veja o programa e a saída:
package main

import (
	"fmt"
	"math"
)

func main() {
	f := 2.9
	g := -2.9
	fmt.Println("int(2.9) =", int(f))
	fmt.Println("int(-2.9) =", int(g))
	fmt.Println("int(f + 0.5) =", int(f+0.5))
	fmt.Println("math.Round(2.5) =", math.Round(2.5))
	fmt.Println("math.RoundToEven(2.5) =", math.RoundToEven(2.5))
	fmt.Println("math.Round(-2.5) =", math.Round(-2.5))
	fmt.Println("math.Floor(-2.9) =", math.Floor(g))
	fmt.Println("math.Trunc(-2.9) =", math.Trunc(g))

	x := 7
	fmt.Println("float64(x) / 2 =", float64(x)/2)
	fmt.Println("x / 2 com inteiros =", x/2)
}
Saída real:
int(2.9) = 2
int(-2.9) = -2
int(f + 0.5) = 3
math.Round(2.5) = 3
math.RoundToEven(2.5) = 2
math.Round(-2.5) = -3
math.Floor(-2.9) = -3
math.Trunc(-2.9) = -2
float64(x) / 2 = 3.5
x / 2 com inteiros = 3
Aqui aparece uma armadilha que quase todo mundo encontra uma vez. Somar 0,5 antes de converter parece arredondar, e para 2,9 ele dá 3, que é o resultado certo. Só que a técnica depende do sinal: para um número negativo, somar 0,5 e truncar não produz o arredondamento esperado. Por isso existe o pacote math, com funções nomeadas para cada intenção. math.Round arredonda para o inteiro mais próximo e, em caso de empate, afasta do zero: 2,5 vira 3, e -2,5 vira -3. math.RoundToEven faz o arredondamento para o par mais próximo, o que dá 2 para 2,5. math.Floor vai para baixo e math.Trunc corta em direção ao zero. Escolher a função certa vale mais do que tentar adivinhar a aritmética da conversão.
A última linha mostra a divisão de inteiros. Com x / 2, o resultado é 3, porque a divisão entre inteiros descarta o resto. Com float64(x) / 2, a conta acontece em ponto flutuante e dá 3,5. A conversão para float veio antes da divisão, e isso mudou a operação inteira. Quem esquece essa ordem gasta uma tarde procurando um bug de arredondamento que não existe.
A conversão de inteiro para float tem outra limitação, e ela é de precisão. Um float64 guarda inteiros exatos até 2 elevado a 53. Acima disso, nem todo inteiro tem representação. O programa a seguir testa o limite:
package main

import "fmt"

func main() {
	a := int64(1<<53 + 1)
	fmt.Println("int64 2^53+1 =", a)
	fmt.Println("de volta por float64:", int64(float64(a)))
	b := int64(1<<53 + 2)
	fmt.Println("int64 2^53+2 =", b, "-> float64 ->", int64(float64(b)))
	var f32 float32 = float32(16777217)
	fmt.Println("float32(16777217) =", f32)
	x := 16777217
	fmt.Println("float32(x) =", float32(x), "| int(float32(x)) =", int(float32(x)))
}
Saída real:
int64 2^53+1 = 9007199254740993
de volta por float64: 9007199254740992
int64 2^53+2 = 9007199254740994 -> float64 -> 9007199254740994
float32(16777217) = 1.6777216e+07
float32(x) = 1.6777216e+07 | int(float32(x)) = 16777216
O número 2 elevado a 53 mais 1 perde o último bit quando passa por float64 e volta como 2 elevado a 53. O 2 elevado a 53 mais 2 sobrevive, porque é representável. No float32 o limite é menor: 16777217 vira 16777216. Essas perdas não geram erro. Se você guarda um identificador numérico grande em float64, ele pode mudar sem que ninguém perceba, e é por isso que IDs costumam ficar em inteiros ou em texto.
Existe ainda o caso de um valor de ponto flutuante fora da faixa do inteiro de destino, como 1e30 convertido para int64. A especificação deixa esse resultado a critério de cada implementação. Na toolchain que rodamos, em arm64, o valor saturou em 9223372036854775807, e NaN virou 0. Essa escolha é do processador e do compilador, e o mesmo código pode dar outro número em outra arquitetura. Não tente depender desse valor. Valide a faixa antes de converter.
Pergunta de entrevistaO que acontece quando você converte um int grande para int8?
Não há erro. O valor é truncado, e 300 vira 44, porque só os 8 bits menos significativos ficam. Por isso, antes de reduzir um inteiro, verifico o intervalo de forma explícita, ou uso strconv, que devolve erro quando o valor não cabe. Em código de dinheiro ou de identificador, esse estouro silencioso é um bug difícil de achar.
5. string, []byte e []rune: bytes, runes e cópia
Texto é o tipo de conversão que mais confunde porque parece simples. Em Go, uma string é uma sequência de bytes, e não uma sequência de caracteres. Quase sempre os bytes representam texto em UTF-8, e uma letra acentuada ocupa mais de um byte. Isso significa que len conta bytes, e que indexar uma string com s[i] devolve um byte, não uma letra.
Para trabalhar com caracteres, Go oferece a conversão para []rune. Um rune é um apelido para int32, e representa um code point Unicode, que é o número atribuído a cada caractere. Um []byte é um slice de bytes, sem nenhuma noção de caractere. Os dois existem porque às vezes você precisa do armazenamento (bytes) e às vezes precisa da letra (runes). O programa abaixo mostra as duas leituras da mesma palavra, héllo, com o é ocupando dois bytes:
package main

import (
	"fmt"
	"unicode/utf8"
)

func main() {
	s := "héllo"
	fmt.Println("len(s) =", len(s))
	fmt.Println("utf8.RuneCountInString(s) =", utf8.RuneCountInString(s))
	fmt.Println("[]byte(s) =", []byte(s))
	fmt.Println("[]rune(s) =", []rune(s))
	fmt.Printf("s[1] = %d (%x)\n", s[1], s[1])
	fmt.Println("string([]rune(s)[1]) =", string([]rune(s)[1]))

	b := []byte(s)
	b[0] = 'H'
	fmt.Println("s =", s, "| string(b) =", string(b))

	for i, r := range s {
		fmt.Printf("%d:%c(U+%04X) ", i, r, r)
	}
	fmt.Println()
}
Saída real:
len(s) = 6
utf8.RuneCountInString(s) = 5
[]byte(s) = [104 195 169 108 108 111]
[]rune(s) = [104 233 108 108 111]
s[1] = 195 (c3)
string([]rune(s)[1]) = é
s = héllo | string(b) = Héllo
0:h(U+0068) 1:é(U+00E9) 3:l(U+006C) 4:l(U+006C) 5:o(U+006F)
Os números contam a história. len(s) dá 6, porque são seis bytes. A contagem de runes dá 5, porque são cinco caracteres. O []byte mostra o é como 195 e 169, que são os dois bytes de UTF-8 para esse caractere em hexadecimal, c3 e a9. O []rune mostra o é como 233, que é 0xE9, o code point de U+00E9. O s[1] devolve 195, o primeiro byte do é, e não a letra. O range sobre a string, ao contrário, anda por runes e entrega o índice de cada byte onde cada caractere começa: 0, 1, 3, 4 e 5, com o pulo de 1 para 3 causado pelos dois bytes do é.
A figura abaixo mostra a mesma palavra nas duas leituras, com o é destacado em âmbar para lembrar que ele ocupa mais de uma posição de byte.
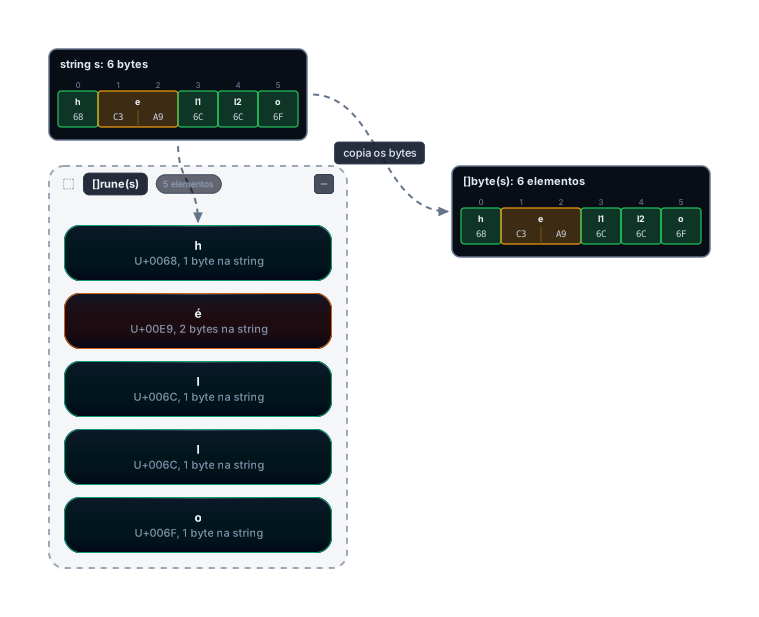
O quadro de cima é a string, com seis bytes na ordem em que estão na memória. O é aparece com os dois bytes C3 e A9 lado a lado, e é por isso que o comprimento não coincide com a contagem de letras. Os dois quadros de baixo partem da mesma string. Com []byte(s), a conversão copia os bytes, e o resultado tem os mesmos seis elementos. Com []rune(s), a conversão decodifica o UTF-8, e cada caractere vira um elemento de 4 bytes, então o é fica com um único valor, E9, e o conjunto cabe em cinco elementos.
Repare em outro detalhe do programa. Depois de b := []byte(s) e b[0] = 'H', a string s continua héllo. A conversão copia. A especificação diz que o resultado dessa conversão é um slice cujos elementos são os bytes da string. Daí segue que mudar o slice não muda a string, porque a string é imutável e o slice é um objeto novo. A cópia tem custo de memória, e vale a pena lembrar disso em loops que convertem o mesmo texto várias vezes.
Existe ainda a conversão string(b), que faz o caminho inverso e também copia. E há a forma de converter um único inteiro para string, que funciona porque a especificação a mantém por razões históricas. O programa a seguir mostra que a conversão de um byte isolado segue a mesma regra de code point, e que o resultado nem sempre é o que você esperava:
package main

import "fmt"

func main() {
	t := "héllo"
	fmt.Println("string(t[1]) =", string(t[1]))
	fmt.Printf("%q\n", string(t[1]))
}
Saída real:
string(t[1]) = Ã
"Ã"
O byte 195 foi lido como o code point U+00C3, que é a letra Ã. O é inteiro é formado por dois bytes, e nenhum deles, sozinho, basta para formar a letra. Esse é o erro típico de quem indexa texto achando que indexa caracteres, porque o é ocupa dois bytes e o índice enxerga só um deles. Para pegar a letra, use []rune(t)[1], como no primeiro programa, ou o range.
6. strconv: transformando texto em número e de volta
Para converter texto em número e número em texto, Go não usa T(x). A conversão de string para int precisa lidar com um caso que a conversão de tipo nunca trata: o texto pode não ser um número. Por isso a biblioteca strconv devolve um par de valores, o resultado e um erro. A função mais usada é strconv.Atoi, que é equivalente a ParseInt(s, 10, 0) com o resultado convertido para int. Para a direção inversa existe strconv.Itoa. Para tamanhos explícitos, existe strconv.ParseInt, que recebe a base e o tamanho em bits, e strconv.ParseFloat, para decimais.
O programa abaixo passa por todos os casos que aparecem no dia a dia, incluindo os erros:
package main

import (
	"errors"
	"fmt"
	"strconv"
)

func main() {
	n, err := strconv.Atoi("42")
	fmt.Println(n, err)

	n, err = strconv.Atoi("4x2")
	fmt.Println(n, err)

	n, err = strconv.Atoi(" 42")
	fmt.Println(n, err)

	fmt.Println(strconv.Itoa(-17) + "!")

	v, err := strconv.ParseInt("300", 10, 8)
	fmt.Println(v, err)

	u, err := strconv.ParseInt("ff", 16, 64)
	fmt.Println(u, err)

	f, err := strconv.ParseFloat("3.5", 64)
	fmt.Println(f, err)

	big, err := strconv.Atoi("99999999999999999999")
	fmt.Println(big, err)
	fmt.Println("errors.Is(err, strconv.ErrRange):", errors.Is(err, strconv.ErrRange))

	_, err = strconv.Atoi("abc")
	var numErr *strconv.NumError
	if errors.As(err, &numErr) {
		fmt.Printf("Func=%s Num=%q Err=%v\n", numErr.Func, numErr.Num, numErr.Err)
	}
}
Saída real:
42 <nil>
0 strconv.Atoi: parsing "4x2": invalid syntax
0 strconv.Atoi: parsing " 42": invalid syntax
-17!
127 strconv.ParseInt: parsing "300": value out of range
255 <nil>
3.5 <nil>
9223372036854775807 strconv.Atoi: parsing "99999999999999999999": value out of range
errors.Is(err, strconv.ErrRange): true
Func=Atoi Num="abc" Err=invalid syntax
Dois detalhes do resultado merecem atenção. O primeiro é que o espaço em " 42" faz a conversão falhar. strconv não remove espaços por conta própria, e quem recebe texto de formulário ou de um arquivo precisa chamar strings.TrimSpace antes. O segundo é que, nos dois casos de faixa, o valor devolvido não é zero. ParseInt("300", 10, 8) devolve 127, o maior valor de um int8, e Atoi com um número gigante devolve o maior int. A documentação do pacote diz isso com todas as letras: se o valor não cabe, o retorno é o valor máximo da faixa, com o sinal correto, e o erro é ErrRange. Quem usa o número sem olhar o erro pega o 127 e segue a vida, como se o usuário tivesse digitado 127.
O erro que strconv devolve tem o tipo *strconv.NumError, com três campos: Func diz qual função falhou, Num guarda o texto que foi recusado, e Err diz o motivo. Os motivos são sentinelas, como strconv.ErrSyntax e strconv.ErrRange, e por isso errors.Is os encontra mesmo dentro do erro embrulhado. Se você precisa do campo Num para escrever uma mensagem melhor, errors.As extrai o *NumError da cadeia. Para o tratamento de erros em geral, vale a leitura de Tratamento de Erros Idiomático.
A figura abaixo transforma essas regras em um fluxo. O caminho do erro é o que mais importa, porque o valor devolvido nele não serve para nada.
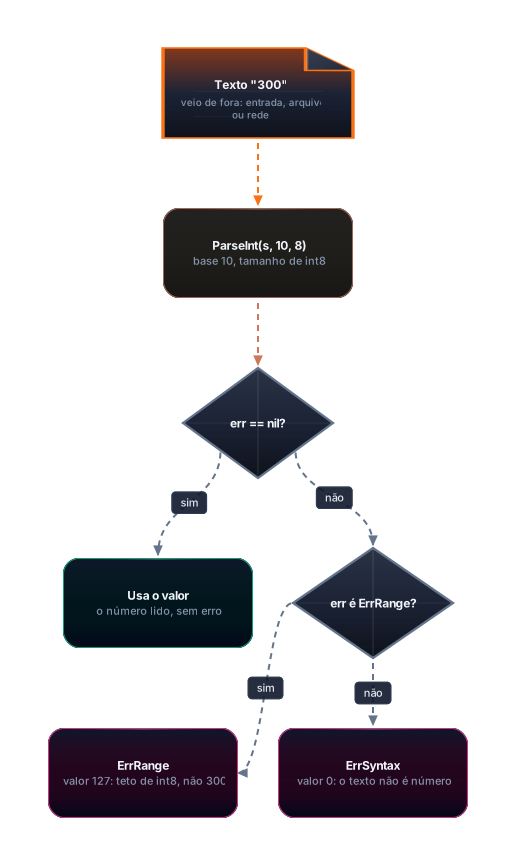
O fluxo começa no texto, que veio de fora do programa e por isso não tem garantia nenhuma. Ele passa pelo ParseInt com 8 bits, e o losango pergunta se o erro é nil. Pelo ramo do sim, o número é usado. Pelo ramo do não, outro losango separa a faixa do erro de sintaxe. No caminho de ErrRange, o número 127 está na caixa, mas a caixa é marcada como valor que não deve ser usado, porque o 300 original não existe mais no resultado. A lição do desenho é a ordem: verifique o erro antes de olhar o número.
Um erro de quem começa, que aparece em código de revisão toda semana, é usar string para converter inteiro:
package main

import "fmt"

func main() {
	codigo := 65
	fmt.Println(string(codigo))
	fmt.Println(string(rune(codigo)))
}
Saída real do go run:
A
A
O string(65) não produz o texto "65". Produz o caractere de code point 65, que é A. Como a conversão continua válida para a linguagem, o compilador não reclama, mas o go vet marca o trecho:
e13/main.go:7:14: conversion from int to string yields a string of one rune, not a string of digitsO comando go vet saiu com código 1, e é por isso que ele vale a pena no fluxo de trabalho. Para transformar o número em texto, o caminho certo é strconv.Itoa(codigo), que devolve "65".
7. Conversões entre tipos definidos pelo usuário
Quando você declara um tipo novo com base num existente, como type Celsius float64, o tipo novo é diferente para o compilador, mesmo que a representação seja a mesma. Entre dois tipos definidos que têm o mesmo tipo subjacente, a conversão é permitida, mas precisa ser escrita. O tipo subjacente é o que está por trás do nome: para Celsius, é float64. Como Celsius e Fahrenheit têm float64 por baixo, Fahrenheit(c) é uma conversão válida. Quando os tipos subjacentes são numéricos e diferentes, valem as regras de conversão numérica das seções 3 e 4. Um teste rápido confirmou que um int pode virar Celsius diretamente, com Celsius(n) imprimindo 5. O programa abaixo mostra o caso que funciona e um método que não atravessa a conversão:
package main

import (
	"fmt"
	"strconv"
)

type Celsius float64
type Fahrenheit float64

type Metros int

func (m Metros) String() string { return strconv.Itoa(int(m)) + " m" }

type Jardas int

func main() {
	c := Celsius(100)
	f := Fahrenheit(c*9/5 + 32)
	fmt.Println("c =", c, "| f =", f)

	m := Metros(10)
	fmt.Println("Metros:", m)

	j := Jardas(m)
	fmt.Println("Jardas(m):", j)
}
Saída real:
c = 100 | f = 212
Metros: 10 m
Jardas(m): 10
O Fahrenheit(c*9/5 + 32) funciona porque c*9/5 + 32 é uma conta com Celsius, que tem tipo subjacente float64, e o resultado é convertido explicitamente para Fahrenheit. Repare que a conversão é obrigatória para o próprio resultado. Mas o mesmo cuidado vale quando os dois lados já são tipos definidos e a operação mistura os dois. O programa seguinte tenta somar os dois diretamente:
package main

import "fmt"

type Celsius float64
type Fahrenheit float64

func main() {
	c := Celsius(100)
	f := Fahrenheit(212)
	fmt.Println(c + f)
}
# conversao/e10
e10/main.go:11:14: invalid operation: c + f (mismatched types Celsius and Fahrenheit)Mesmo que os dois tipos subjacentes sejam float64, a soma é recusada. Com tipos definidos, a identidade do tipo conta, e a soma entre eles precisa de uma conversão explícita de um dos lados. O segundo ponto do programa anterior é o mais útil no dia a dia: Jardas(m) copia o valor 10 para um tipo novo, mas o método String que Metros tem não vem junto. Jardas é outro tipo, que por acaso tem o mesmo tipo subjacente de Metros. A conversão leva o número, mas deixa os métodos para trás, e o fmt.Println imprime o número cru, sem a unidade.
Na prática, isso significa que converter um tipo definido para outro é uma operação sobre o valor, e não sobre o comportamento. Se o método era importante, ele precisa ser definido no tipo de destino.
8. Conversão para interface: quase sempre implícita
Interfaces são o caso em que a palavra “conversão” engana. Quando um valor concreto é atribuído a uma variável de tipo interface, Go não exige a sintaxe T(x). A atribuição é válida porque o valor implementa a interface, e a especificação trata isso como uma regra de atribuição: um valor de tipo V é atribuível a uma interface T quando V implementa T. O valor guarda, junto de si, o tipo concreto que ele tinha. Nenhum bit é alterado.
O programa abaixo cria uma interface vazia, any, e mostra como o valor sai dela:
package main

import "fmt"

func main() {
	var x int = 42
	var v any = x
	fmt.Println(v)
	fmt.Printf("%T\n", v)

	n := v.(int)
	fmt.Println(n + 1)

	s, ok := v.(string)
	fmt.Printf("%q %v\n", s, ok)

	w := any(x)
	fmt.Printf("%T\n", w)
}
Saída real:
42
int
43
"" false
int
A linha var v any = x não tem conversão, e é a forma usual de guardar um valor numa interface. A expressão any(x) também é válida, mas ela não faz nada além de escrever o que a atribuição já faz, então quase ninguém a usa. Para voltar ao tipo concreto, a operação é outra: a asserção de tipo v.(int), que pergunta à interface qual é o tipo dela e extrai o valor. A forma com dois resultados, s, ok := v.(string), responde sem entrar em pânico, e devolve false quando o tipo não bate.
Quando a asserção sem a forma de dois resultados falha, o programa para. O exemplo abaixo mostra o que acontece:
package main

import "fmt"

func main() {
	var v any = 42
	s := v.(string)
	fmt.Println(s)
}
Saída real, primeira linha do panic, seguida do rastro de pilha que o Go imprime em seguida:
panic: interface conversion: interface {} is int, not stringA mensagem diz o tipo que a interface guardava e o tipo que você pediu. Ela também mostra o rastro de goroutine e sai com código 2. O assunto de asserções e de switch sobre tipos é mais amplo e merece uma aula própria. Ele aparece na aula 1.7 da trilha, sobre interfaces e composição, que ainda não foi escrita. Por ora, guarde a regra: entrar numa interface é implícito, e sair dela é uma asserção que pode falhar.
Erros comuns e boas práticas
O erro mais caro é imaginar que a conversão de tamanho menor é segura porque o compilador não reclamou. Ele reclama só das constantes. Com variável, o valor é truncado em silêncio, e o programa segue com 44 no lugar de 300. Todo lugar em que um valor de fora, como um campo JSON, um parâmetro de URL ou uma linha de banco, é guardado num tipo mais estreito merece uma checagem de faixa antes da conversão. Se a conta não fecha, o erro precisa aparecer no código, e não na contabilidade do mês seguinte.
Outro erro é tratar string(i) como se fosse o jeito de escrever o número i. Ele produz o caractere de code point i, e por isso string(65) é A. O go vet avisa, mas quem não roda o vet no pipeline não ouve o aviso. Use strconv.Itoa para números e fmt.Sprint quando quiser formatar qualquer valor.
O terceiro erro é ignorar o retorno de strconv. Ele tem uma tradição longa: o código ignora o erro, usa o valor devolvido, e o valor devolvido é zero ou o máximo da faixa. A tela mostra um número plausível e ninguém desconfia. A regra prática é verificar err antes de qualquer uso do resultado, e não depois. A figura da seção 6 deixa isso claro.
Também vale desconfiar da divisão entre inteiros. Ela descarta o resto sem reclamar, e o resultado parece correto até alguém passar um valor ímpar. Se a conta precisa de decimais, converta antes de dividir, como em float64(x) / 2.
O quinto erro é indexar uma string achando que você pega uma letra. Você pega um byte. Com texto em português, a diferença aparece em toda palavra com acento, e o bug costuma ser descoberto quando o usuário escreve um nome. Para caracteres, converta para []rune ou itere com range.
Por último, a conversão de []byte para string e de volta faz cópias, o que tem custo quando é feita em laço. Não é um problema enquanto o volume é pequeno. Ele aparece quando o mesmo conteúdo é convertido milhares de vezes por segundo, e aí a solução é reaproveitar o buffer ou manter o dado no tipo que a operação usa. Esta aula não mediu esse custo, e a afirmação vale como princípio e não como número.
As boas práticas que cobrem esses erros são poucas. Converta na fronteira do programa, onde o dado entra, e não no meio da lógica. Valide a faixa antes de reduzir um inteiro. Trate o erro de strconv imediatamente, com if err != nil logo depois da chamada. Use math.Round, math.Floor ou math.Trunc quando a intenção é arredondar, e deixe claro qual dos três você escolheu, porque a conversão direta só trunca. E ao declarar um tipo novo com base num existente, decida se os métodos precisam ir junto. Se precisam, escreva-os de novo no tipo de destino.
Exercícios com resposta de referência
Os exercícios abaixo usam o que a aula mostrou. Tente responder antes de olhar a resposta, e rode o código para conferir. As respostas estão logo depois de cada enunciado, com a justificativa.
Exercício 1. Qual é o resultado de int8(n) quando n vale -129? Resposta: 127. Em 16 bits, -129 é o padrão que vale 127 quando lido com módulo 256, porque -129 + 256 = 127, e o int8 pega esse resultado. A execução de referência imprimiu int8(-129) = 127.
Exercício 2. O que strconv.Atoi("abc12") devolve, e qual é o campo Err do erro? Resposta: devolve 0 e um erro do tipo *strconv.NumError, com Err igual a strconv.ErrSyntax, porque o texto contém letras. A execução de referência imprimiu 0 strconv.Atoi: parsing "abc12": invalid syntax.
Exercício 3. Quantos bytes e quantos runes tem a string "naïve"? Resposta: 6 bytes e 5 runes. O ï é o code point U+00EF e ocupa dois bytes em UTF-8. A execução de referência imprimiu len(naïve) = 6 | runas = 5.
Exercício 4. Qual é o resultado de string(t[1]) quando t vale "héllo"? Resposta: Ã, não é. O t[1] é o primeiro byte do é, valor 195, e a conversão lê esse byte como o code point U+00C3. A execução de referência imprimiu "Ã".
Exercício 5. O que strconv.ParseInt("-129", 10, 8) devolve? Resposta: -128, com erro ErrRange. O menor valor de um int8 é -128, e o valor devolvido é esse limite, não o número digitado. A execução de referência imprimiu -128 strconv.ParseInt: parsing "-129": value out of range.
Exercício 6. Para x igual a 3, quanto valem x / 2 e float64(x) / 2? Resposta: 1 e 1,5. A divisão entre inteiros trunca em direção ao zero, e a conversão para float64 antes da divisão mantém a parte fracionária. O exemplo da seção 4 mostrou o mesmo comportamento com x igual a 7, que dá 3 e 3,5. A execução de referência com x igual a 3 imprimiu x / 2 = 1 e float64(x) / 2 = 1.5.
Glossário
Conversão explícita: escrita de um valor no formato de outro tipo com a sintaxe T(x). Em Go, é a única forma de mudar o tipo de um valor não constante, com a exceção de atribuição a interface.
Truncamento: descarte da parte que não cabe no tipo de destino. Para float, é a fração; para inteiro, são os bits de cima.
Estouro (overflow): situação em que o resultado não cabe no tipo. Em Go, o inteiro dá a volta sem erro, e a soma também.
Extensão de sinal: cópia do bit de sinal para as posições novas ao converter um inteiro com sinal para um tipo maior.
Tipo subjacente: o tipo que está por trás de um tipo definido. Dois tipos definidos só são conversíveis entre si quando têm o mesmo tipo subjacente.
Byte: unidade de armazenamento de 8 bits. Em Go, byte é um apelido de uint8.
Rune: um code point Unicode. Em Go, rune é um apelido de int32.
Code point: o número atribuído a um caractere no padrão Unicode, como U+00E9 para o é.
UTF-8: codificação que representa cada code point com um a quatro bytes. Caracteres do ASCII ocupam um byte, e o é ocupa dois.
Asserção de tipo: operação que extrai o valor concreto de uma interface, escrita como v.(T). Pode entrar em pânico ou, na forma de dois resultados, devolver false.
strconv: pacote da biblioteca padrão com funções para converter entre texto e números, como Atoi, Itoa, ParseInt e ParseFloat.
NumError: tipo de erro devolvido por strconv, com os campos Func, Num e Err.
O que não foi confirmado
O comportamento de uma conversão de ponto flutuante fora da faixa do inteiro foi rodado só em arm64. A especificação diz que o resultado depende da implementação, e não foi possível executar o mesmo programa em amd64 nesta máquina, porque o binário não roda aqui. Se você for depender desse caso em outra arquitetura, meça lá.
As mensagens de erro do compilador e do strconv são as da toolchain go1.27.2. Elas podem mudar de redação em outras versões, por isso a comparação deve ser feita pelo tipo do erro e não pelo texto.
A cópia de []byte tem custo, mas a aula não mediu esse custo com benchmark. A afirmação de que a conversão copia os dados vem da especificação e do exemplo de execução, não de uma medição de desempenho.
A redação da especificação foi conferida na cópia local que acompanha a toolchain, não na versão pública online. Se a página pública trouxer uma redação mais nova, ela deve ser a referência.
Fontes
Consultadas em 3 de novembro de 2026.
Especificação da linguagem Go, seções sobre conversões, atribuibilidade, tipos numéricos, tipos de string e a regra de conversão de inteiros para string, em https://go.dev/ref/spec. A cópia local usada na conferência é a da toolchain go1.27.2, em /opt/homebrew/Cellar/go/1.27.2/libexec/doc/go_spec.html.
Documentação do pacote strconv, consultada com go doc strconv.Atoi, go doc strconv.ParseInt e go doc strconv.NumError na toolchain go1.27.2, e disponível em https://pkg.go.dev/strconv.
Rob Pike, “Strings, bytes, runes and characters in Go”, publicado em 23 de outubro de 2013, em https://go.dev/blog/strings. O artigo define o rune como alias de int32 e explica que indexar uma string acessa bytes e não caracteres. Conferido em 3 de novembro de 2026.