Garbage collector do Go: alcançabilidade, pausas e GOGC
Como o coletor de lixo do Go decide o que ainda está vivo, por que as pausas são curtas e como GOGC e GOMEMLIMIT controlam o ritmo da coleta.
Publicada em · 33 min de leitura
Todo programa cria objetos e, mais cedo ou tarde, para de usar alguns deles. Em C, quem alocou a memória precisa lembrar de devolvê-la com free, e uma linha esquecida vira vazamento. Em Go essa tarefa fica com o . O garbage collector (GC) percorre os objetos, descobre quais ainda podem ser alcançados pelo programa e reaproveita a memória dos demais. Você não escreve free e, na maior parte do tempo, nem pensa nisso. Mesmo assim, o coletor gasta CPU e, às vezes, faz o programa parar por um instante. Entender onde esse custo aparece é o objetivo desta aula.
Mapa da aula
| Parte | Seções | O que você vai aprender |
|---|---|---|
| 1. Ideia e motivação | 1 a 2 | O que é coleta de lixo e por que o Go escolheu um coletor concorrente |
| 2. Como o coletor encontra o lixo | 3 a 5 | , raízes, e , e a |
| 3. Controle de ritmo e de memória | 6 a 8 | O que são as pausas, GOGC e GOMEMLIMIT |
| 4. Medição e erros | 9 a 11 | GODEBUG=gctrace=1, runtime/metrics, MemStats, erros comuns e boas práticas |
| 5. Prática e consolidação | 12 a 15 | Exercícios com resposta de referência, glossário, o que não foi confirmado e fontes |
Pré-requisitos: Heap e Stack, para saber onde os objetos vivem, e Preempção, porque a duração das pausas depende de conseguir parar as goroutines. A aula também usa Ponteiros. Esta aula fica na fase 4 da Trilha de Go, depois do scheduler e da preempção.
1. Coleta de lixo para quem nunca ouviu falar
Imagine uma república de estudantes com uma geladeira compartilhada. Cada pote tem uma etiqueta com o nome de quem o colocou lá. Em algum momento a geladeira fica cheia, e alguém precisa decidir o que jogar fora. A etiqueta com o nome não ajuda muito, porque o pote de um morador que já se mudou continua com o nome dele escrito. O que conta é quem ainda segura o pote, ou quem segura uma sacola que tem o pote dentro. Se ninguém alcança o pote, ele vai para o lixo.
O coletor do Go faz essa pergunta para cada objeto da memória. As pessoas da república são as raízes, que são variáveis globais e as variáveis locais das goroutines. As sacolas são os ponteiros. Um objeto que ninguém consegue alcançar seguindo sacolas a partir das raízes é lixo, e a memória dele pode ser reutilizada. Em nenhum momento o coletor precisa saber o que o objeto “significa” para o programa. Ele só olha a estrutura de referências.
Essa definição tem uma consequência que surpreende: dois objetos que apontam um para o outro, mas nenhuma alcança nenhum deles, são lixo. Um coletor que contasse referências não pegaria esse caso, porque cada objeto ainda tem uma referência viva (a do outro). Veremos o exemplo na seção 3.
2. Por que Go escolheu um coletor concorrente
Gerenciar memória à mão tem um custo de atenção que cresce com o tamanho do programa. Os coletores tradicionais resolvem esse problema, mas cada um escolhe o que sacrificar. Alguns coletores priorizam a vazão total e fazem pausas grandes para compactar a memória de uma vez. Para uma API que precisa responder em poucos milissegundos, uma pausa de centenas de milissegundos é o tipo de problema que aparece no painel de latência, e não no de CPU.
O Go escolheu outra troca. O coletor roda em paralelo com o programa sempre que possível, e as paradas completas, chamadas de stop-the-world (), são mantidas curtas. As notas de versão deixam essa intenção clara. Na versão 1.5 a documentação diz que o coletor passou a ser concorrente e que a fase STW “quase sempre” fica abaixo de 10 ms. Na versão 1.8, a eliminação do rescan de pilhas em STW reduziu as pausas para algo que as notas descrevem como “usually under 100 microseconds”. A troca tem preço: enquanto a marcação roda, o coletor usa uma fatia da CPU. O guia oficial diz que a marcação consome cerca de 25% dos recursos de processamento, e o runtime usa a constante gcBackgroundUtilization = 0.25 para planejar isso.
O custo continua existindo, e as seções 6 e 10 mostram onde ele aparece. A diferença é que ele deixa de ser uma parada única e passa a ser uma fatia de CPU espalhada pelo tempo.
3. Alcançabilidade: raízes, ponteiros e o grafo de objetos
A pergunta central do coletor é de alcançabilidade. Um objeto está vivo se existe um caminho de ponteiros que sai de uma raiz e chega até ele. Esses caminhos formam um grafo: os objetos são os nós e os ponteiros são as arestas. A marcação é uma busca em largura ou em profundidade que começa nas raízes e segue as arestas.
As raízes são os pontos de entrada que o programa segue usando sem precisar de nenhum ponteiro para chegar a eles. Elas são de três tipos: variáveis globais, as variáveis locais e argumentos de cada goroutine (guardados nas pilhas delas) e alguns registradores e estruturas do próprio runtime. Se uma variável local de uma função em execução aponta para um objeto, esse objeto está vivo, mesmo que nenhuma outra parte do programa saiba dele.
A figura abaixo mostra o grafo com as duas situações que mais confundem: um objeto alcançado por uma raiz e um ciclo sem raiz.
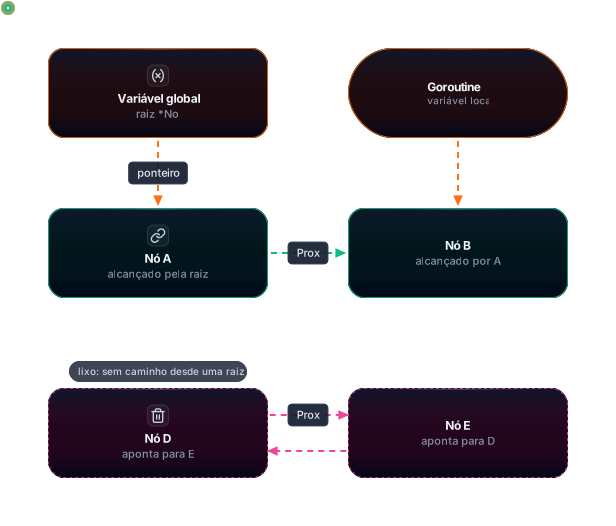
Na figura, A e B continuam vivos porque a variável global e a goroutine seguram o caminho até eles. D e E formam um ciclo, e nenhuma raiz chega até eles. O coletor não precisa desfazer a referência de D para E, porque a marcação nunca chega até D. Os dois ficam sem marca e são varridos.
O programa abaixo verifica isso na prática. Ele usa runtime.AddCleanup, disponível desde o Go 1.24, para ser avisado quando um objeto é coletado. O cleanup não toca no objeto, só recebe um rótulo.
package main

import (
	"fmt"
	"runtime"
	"time"
)

type No struct {
	Nome  string
	Prox  *No
	Dados []byte
}

// raiz: variável global que mantém a cadeia viva
var raiz *No

// criarCiclo cria dois nós que apontam um para o outro e os solta ao retornar.
// Nenhuma raiz alcança D nem E depois do retorno, mesmo com a referência cruzada.
func criarCiclo() {
	d := &No{Nome: "D", Dados: make([]byte, 1<<20)}
	e := &No{Nome: "E", Dados: make([]byte, 1<<20)}
	d.Prox = e
	e.Prox = d
	runtime.AddCleanup(d, func(s string) { fmt.Println("  coletado:", s) }, "D (ciclo)")
	runtime.AddCleanup(e, func(s string) { fmt.Println("  coletado:", s) }, "E (ciclo)")
}

func esperarGC() {
	runtime.GC()
	time.Sleep(50 * time.Millisecond)
}

func main() {
	// Caso 1: A -> B, com A guardado na variável global
	raiz = &No{Nome: "A", Dados: make([]byte, 1<<20)}
	raiz.Prox = &No{Nome: "B", Dados: make([]byte, 1<<20)}
	runtime.AddCleanup(raiz, func(s string) { fmt.Println("  coletado:", s) }, "A")
	runtime.AddCleanup(raiz.Prox, func(s string) { fmt.Println("  coletado:", s) }, "B")

	// Caso 2: ciclo D <-> E sem nenhuma raiz
	criarCiclo()

	fmt.Println("1) GC com A na raiz global (B alcançável por A, D e E não):")
	esperarGC()

	fmt.Println("2) Solto a ligação raiz.Prox, então B deixa de ser alcançável:")
	raiz.Prox = nil
	esperarGC()

	fmt.Println("3) Solto a raiz, então A também deixa de ser alcançável:")
	raiz = nil
	esperarGC()
}
Saída real, executada com Go 1.27.2 em um Apple M1 Max:
1) GC com A na raiz global (B alcançável por A, D e E não):
  coletado: D (ciclo)
  coletado: E (ciclo)
2) Solto a ligação raiz.Prox, então B deixa de ser alcançável:
  coletado: B
3) Solto a raiz, então A também deixa de ser alcançável:
  coletado: A
Duas leituras importantes. A primeira: B não foi coletado no passo 1, mesmo sem ninguém segurar B diretamente, porque A aponta para B e A está na raiz. A segunda: a ordem de D e E muda de uma execução para outra. A documentação de AddCleanup diz que não há ordem especificada, mesmo para objetos em ciclo. Não escreva código que dependa dela.
4. Marcação e varredura, em três cores
Com o grafo na cabeça, o próximo passo é entender o algoritmo. O Go usa marcação e varredura (mark-sweep) com a abstração tricolor. Cada objeto recebe uma das três cores em um dado instante:
- Branco: ainda não foi visitado. No fim da marcação, o que continua branco é lixo.
- Cinza: o coletor já achou o objeto, mas ainda não examinou os ponteiros dele. Cinza é a fila de trabalho.
- Preto: o objeto está vivo e todos os ponteiros dele já foram examinados.
O ciclo começa com uma parada curta (STW) em que o runtime prepara a marcação e ativa a barreira de escrita, que explico na seção 5. Depois vêm as raízes, que são pintadas de cinza. Os trabalhadores do coletor retiram objetos cinzas, marcam os alvos dos ponteiros deles como cinzas e pintam o próprio objeto de preto. Quando a fila de cinzas esvazia, a marcação termina com outra parada curta. A varredura vem depois: ela percorre a memória e devolve ao alocador tudo que não ficou marcado. Pelo guia oficial, o Go tem um coletor não compactante, ou seja, os objetos não se mudam de lugar, então um ponteiro continua válido enquanto o objeto estiver vivo.
A figura abaixo mostra as fases e o que cada parte do programa faz em cada uma.
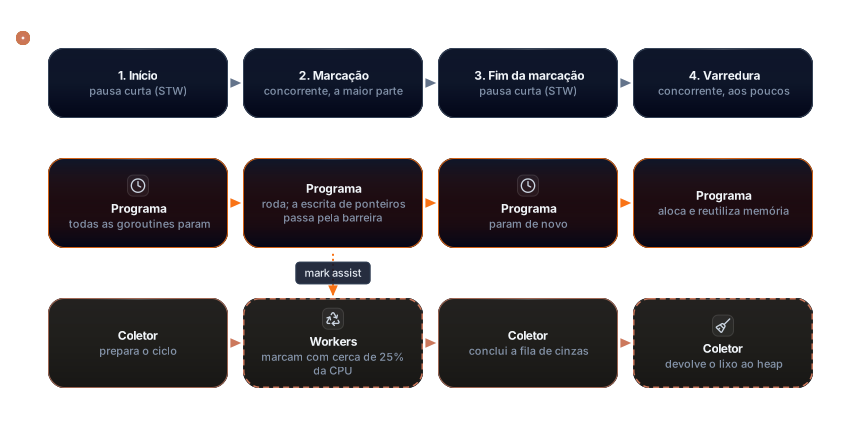
A figura mostra o que a leitura dos números do gctrace depois vai confirmar. Os blocos laranjas são as pausas, e o programa para inteiro nelas. Os blocos da linha de baixo rodam ao mesmo tempo que o programa, e é ali que o trabalho pesado acontece. A seta pontilhada representa o : quando uma goroutine aloca muito enquanto a marcação está em andamento, o runtime pode fazê-la ajudar no trabalho de marcação. Eu não medi o assist separadamente nesta aula, então trate essa seta como mecanismo descrito, não como número.
5. Barreira de escrita: o problema que a concorrência cria
Se o programa continua rodando enquanto o coletor marca, ele pode mexer nos ponteiros no meio da busca. E é aí que um coletor concorrente pode errar feio. Considere três objetos: A já foi marcado como preto, B está cinza e ainda não foi examinado, e C é branco, mas vivo, porque B aponta para ele. Uma goroutine pega uma referência para C na pilha, grava essa referência dentro de A e depois apaga o campo de B que apontava para C.
Sem nenhuma proteção, o resultado é desastroso. A é preto e não será examinado de novo. A pilha já foi varrida, então a referência que está lá não será vista. B perdeu o caminho. Quando a marcação termina, C continua branco e é varrido, embora esteja sendo usado. Esse é o erro que o coletor precisa impedir, e a solução tem o nome de barreira de escrita.
A barreira de escrita é um pequeno trecho de código que o compilador insere antes de cada gravação de ponteiro no heap, e ela só fica ativa durante a fase de marcação. O comentário do arquivo runtime/mbarrier.go descreve o mecanismo híbrido usado pelo Go:
writePointer(slot, ptr):
    shade(*slot)
    if current stack is grey:
        shade(ptr)
    *slot = ptr
Aqui shade significa pintar o objeto de cinza para que o coletor o examine. A primeira linha pinta o valor antigo do campo, que é o que está sendo apagado. A condição sobre a pilha cuida do valor novo, e ela só é necessária enquanto a pilha da goroutine ainda não foi examinada. O comentário também explica por que as duas partes trabalham juntas: a primeira impede a goroutine de esconder um objeto mexendo no heap, e a segunda impede que ela o esconda movendo o ponteiro da pilha para um objeto preto.
A proposta de design que introduziu essa barreira, a 17503 do repositório golang/proposal, é assinada por Austin Clements e Rick Hudson, e menciona o Go 1.8. A figura compara o mesmo cenário com e sem a barreira.
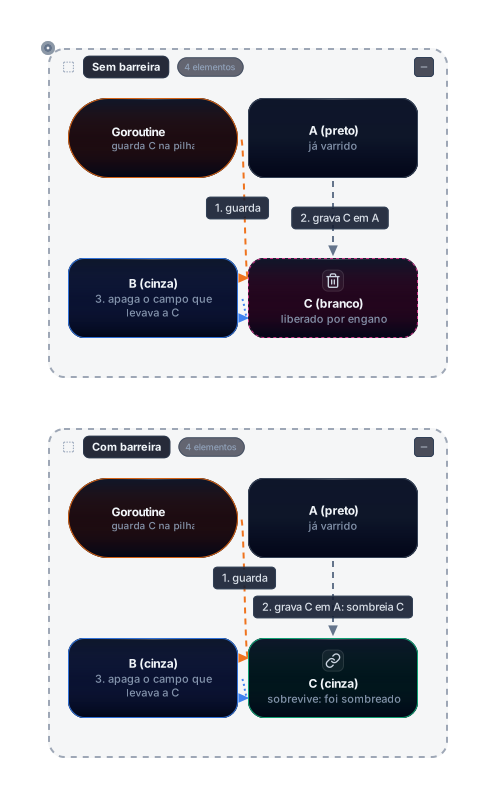
Na parte de cima, C fica branco e é apagado, mesmo estando em uso. Na parte de baixo, a escrita em A pinta C de cinza, e a marcação o alcança antes do fim. O custo da barreira é pago pelo programa em cada gravação de ponteiro durante a marcação, e essa é uma das razões pelas quais a marcação concorrente não é gratuita para o programa.
Pergunta de entrevistaComo funciona o coletor de lixo do Go?
O Go usa marcação e varredura com a abstração tricolor, de forma concorrente. Os objetos são brancos, quando ainda não foram visitados, cinzas, quando já foram achados mas seus ponteiros não foram examinados, ou pretos, quando estão vivos e já examinados. A marcação parte das raízes pintadas de cinza e segue até a fila de cinzas esvaziar. O que continua branco é lixo. O ciclo tem duas pausas curtas, e a maior parte do trabalho roda ao mesmo tempo que o programa, com a barreira de escrita ativa para não perder objetos que mudam durante a marcação. O trade-off é que o coletor consome CPU junto com a aplicação, e uma goroutine que aloca muito pode ser chamada a ajudar, o chamado mark assist.
6. Pausas curtas não são pausa zero
Uma pausa STW é um instante em que o programa inteiro está parado. No ciclo da seção 4 existem duas delas, uma no início e outra no fim da marcação. O guia oficial chama essas pausas de “brief” e diz que, na maior parte das vezes, a duração delas é dominada pelo tempo que o runtime leva para parar as goroutines que estão rodando. Esse detalhe liga a pausa à preempção, que você estudou antes: se uma goroutine não aceita ser interrompida a tempo, a pausa espera por ela.
Eu medi três execuções em cada uma de três configurações, em um Apple M1 Max com 10 processadores lógicos e Go 1.27.2. O programa de teste é o da seção 9, com 200 mil registros vivos e três milhões de buffers descartados. Os tempos abaixo são de relógio, lidos do campo clock do .
| Configuração | Ciclos (faixa) | STW inicial, média (máximo) | Marcação concorrente, média (máximo) | STW final, média (máximo) |
|---|---|---|---|---|
GOGC=100 (padrão) | 31 a 33 | 0,50 a 0,89 ms (até 9,3 ms) | 8,3 a 14,6 ms (até 200 ms) | 0,22 a 0,67 ms (até 7,2 ms) |
GOMEMLIMIT=40MiB | 117 a 122 | 0,46 a 1,13 ms (até 33 ms) | 6,6 a 10,9 ms (até 136 ms) | 0,15 a 0,49 ms (até 17 ms) |
GOGC=off e GOMEMLIMIT=40MiB | 116 a 122 | 0,11 a 0,49 ms (até 4,5 ms) | 3,7 a 8,2 ms (até 90 ms) | 0,06 a 0,23 ms (até 16 ms) |
A tabela mostra duas coisas. A média fica sempre na casa das frações de milissegundo, mas o máximo sobe para vários milissegundos e, em alguns ciclos, para dezenas. Isso aconteceu numa máquina de desenvolvimento com outros processos rodando, e não tenho como garantir o comportamento em produção. Nenhuma das fontes oficiais que consultei dá um número garantido para a pausa, e a nota antiga desta aula dizia “menos de 1 milissegundo” sem fonte. Trate “curta” como o que o guia promete, sem dar um teto numérico. Quem precisa de um teto deve medir no seu próprio ambiente.
Repare também na coluna da marcação concorrente. Cada ciclo ocupa alguns milissegundos de relógio, e durante esse tempo o programa continua rodando, mas dividindo a CPU com o coletor e pagando a barreira em cada escrita de ponteiro. Pausa e custo são coisas diferentes, e a seção 10 mostra o erro de confundi-las.
7. : o ritmo proporcional
Antes de decidir quando coletar, o coletor precisa de uma meta de tamanho. A variável GOGC controla essa meta como uma porcentagem sobre a memória viva. O guia oficial escreve a meta assim:
Target heap memory = Live heap + (Live heap + GC roots) * GOGC / 100Com o padrão GOGC=100, o heap pode crescer até o dobro da memória viva depois da última coleta, mais as raízes. O guia observa que as raízes entram na conta desde o Go 1.18, e que existe um piso de 4 MiB para o heap total. Se o programa termina um ciclo com 200 MB vivos e não há raízes grandes, o próximo ciclo acontece perto dos 400 MB.
O valor de GOGC é uma troca direta entre memória e CPU. Subir o valor faz o coletor rodar menos vezes, com mais memória ocupada. O mesmo programa da seção 9 mostrou isso:
| Configuração | Ciclos (2 execuções) | Pico do heap no início de um ciclo | Memória total do runtime |
|---|---|---|---|
GOGC=100 | 30 e 35 | 52 e 84 MB | 74 e 117 MB |
GOGC=400 | 7 e 8 | 147 e 154 MB | 181 e 324 MB |
GOGC=off | 0 | sem coleta | 855 MB |
Com GOGC=off o coletor não roda nunca, e a memória cresce com todo o lixo gerado pelo programa. Na prática, o GOGC=off só serve para medir ou para processos muito curtos. A variável também pode ser alterada em tempo de execução com runtime/debug.SetGCPercent.
O problema de GOGC sozinho aparece em contêineres. A meta cresce com a memória viva, e a memória viva pode crescer muito mais do que o limite de RAM do contêiner. Quando isso acontece, o kernel mata o processo antes que o coletor perceba que precisava rodar. Foi esse problema que motivou o próximo controle.
8. : o teto flexível
Desde o Go 1.19, GOMEMLIMIT define um limite de memória para o runtime. O guia oficial afirma que esse limite é “soft”, ou seja, flexível: o runtime tenta mantê-lo, mas não o garante quando o programa precisa de mais memória do que o limite permite. A documentação do GOMEMLIMIT define que o limite inclui o heap do Go e toda outra memória gerenciada pelo runtime, e exclui memória externa, como o próprio binário e a memória de bibliotecas em C. O valor é um número em bytes com sufixo B, KiB, MiB, GiB ou TiB, todos na base 2. O padrão é math.MaxInt64, que desativa o limite.
Quando o consumo se aproxima do limite, o passa a disparar coletas com mais frequência, mesmo que GOGC não tenha pedido isso. O guia também descreve uma proteção contra o efeito contrário: se o coletor passar muito tempo rodando, o runtime limita o tempo de CPU gasto com GC a cerca de 50%, numa janela de 2 vezes GOMAXPROCS segundos de CPU, e por isso o programa desacelera no máximo cerca de duas vezes. Essa proteção é a razão pela qual o limite não vira um laço infinito de coletas.
O uso combinado mais útil é GOGC=off com um GOMEMLIMIT. Sem GOGC, o coletor só roda quando a memória se aproxima do teto. A figura abaixo mostra a decisão que o runtime toma em cada alocação.
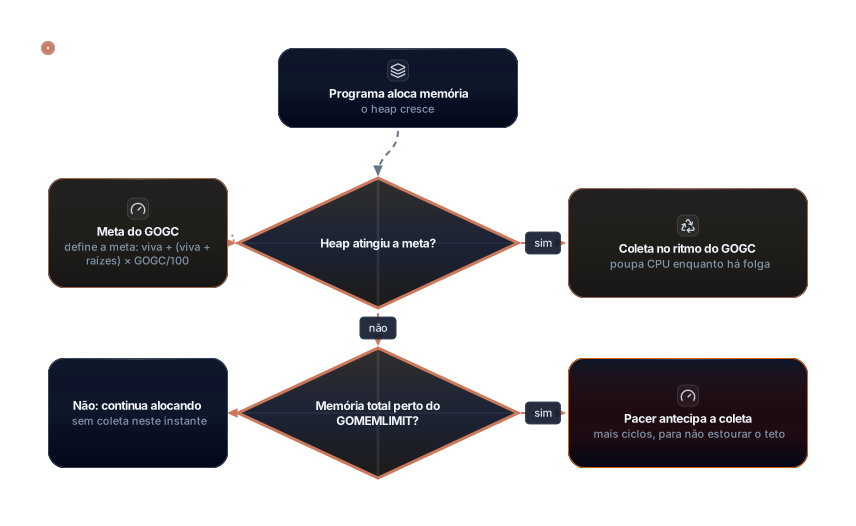
Os dois testes abaixo usam o mesmo programa, com um conjunto vivo de cerca de 30 MB. Eles mostram o que acontece quando o limite fica abaixo do conjunto vivo:
| Configuração | Ciclos | Memória total do runtime | Tempo de parede | Fração de CPU do GC |
|---|---|---|---|---|
GOGC=off sem limite | 0 | 855 MB | 0,48 a 1,13 s | 0 |
GOGC=off com GOMEMLIMIT=40MiB | 116 a 118 | 48 a 61 MB | 2,1 a 2,8 s | 0,12 a 0,14 |
GOMEMLIMIT=40MiB com GOGC padrão | 122 a 130 | 52 a 53 MB | 3,4 a 3,7 s | 0,11 a 0,21 |
O limite funcionou: a memória total ficou perto de 50 MB, e o GOGC=off sem limite chegou a 855 MB. Mas o preço foi alto. Com o conjunto vivo quase encostado no limite, o coletor passou a rodar mais de cem vezes e a ocupar uma fração grande da CPU. Esse é o efeito de thrashing que o guia descreve. A regra prática é dar folga acima do conjunto vivo. Eu não encontrei na documentação oficial um percentual fixo para o limite de um contêiner. A nota antiga sugeria 85% a 90% da cota, mas não consegui confirmar esse número nas fontes, e por isso ele aparece na seção 14 como não confirmado.
Pergunta de entrevistaPara que serve o GOGC e quais os trade-offs de alterá-lo?
O GOGC define a meta de tamanho do heap como uma porcentagem sobre a memória viva. Com o padrão 100, o heap pode chegar a cerca do dobro da memória viva da última coleta antes do próximo ciclo, então 200 MB vivos levam o próximo ciclo para perto de 400 MB. É uma troca direta entre memória e CPU: subir o valor faz o coletor rodar menos vezes e ocupa mais memória, e descer faz o contrário. Na aula, GOGC=400 reduziu os ciclos de cerca de 30 para cerca de 7 no mesmo programa, com mais memória usada. O GOGC=off só serve para medir ou para processos muito curtos. Em contêiner eu também uso GOMEMLIMIT, porque só o GOGC pode deixar o kernel matar o processo.
9. Medir: gctrace, runtime/metrics e
Antes de ajustar qualquer coisa, meça. O primeiro instrumento é a variável GODEBUG=gctrace=1, que imprime uma linha por ciclo no erro padrão. A documentação do runtime define o formato assim, e avisa que ele pode mudar:
gc # @#s #%: #+#+# ms clock, #+#/#/#+# ms cpu, #->#-># MB, # MB goal, # MB stacks, #MB globals, # PO programa abaixo é o banco de testes usado nas seções 6, 7 e 8. Ele cria um conjunto vivo, faz um churn de buffers descartados e, no fim, imprime métricas e estatísticas.
package main

import (
	"fmt"
	"runtime"
	"runtime/metrics"
	"time"
)

type Registro struct {
	ID    int
	Nome  string
	Dados []byte
}

// raiz global: tudo o que estiver em sink é alcançável e fica vivo
var sink []*Registro

// descartavel é global para forçar a alocação no heap (o compilador
// não consegue provar que o buffer morre dentro da função)
var descartavel []byte

func main() {
	inicio := time.Now()

	// Conjunto vivo: 200 mil registros que continuam alcançáveis pela raiz global
	for i := 0; i < 200_000; i++ {
		sink = append(sink, &Registro{ID: i, Nome: "registro", Dados: make([]byte, 64)})
	}

	// Churn: 3 milhões de buffers de 256 bytes que morrem na iteração seguinte
	for i := 0; i < 3_000_000; i++ {
		descartavel = make([]byte, 256)
		descartavel[0] = byte(i)
	}

	fmt.Printf("vivos=%d tempo=%s\n", len(sink), time.Since(inicio).Round(time.Millisecond))

	amostras := []metrics.Sample{
		{Name: "/gc/cycles/total:gc-cycles"},
		{Name: "/gc/heap/live:bytes"},
		{Name: "/gc/heap/goal:bytes"},
		{Name: "/memory/classes/total:bytes"},
		{Name: "/cpu/classes/gc/total:cpu-seconds"},
		{Name: "/gc/pauses:seconds"},
	}
	metrics.Read(amostras)
	for _, a := range amostras {
		switch a.Value.Kind() {
		case metrics.KindUint64:
			fmt.Printf("%-40s %d\n", a.Name, a.Value.Uint64())
		case metrics.KindFloat64:
			fmt.Printf("%-40s %.4f\n", a.Name, a.Value.Float64())
		case metrics.KindFloat64Histogram:
			h := a.Value.Float64Histogram()
			var n uint64
			for _, c := range h.Counts {
				n += c
			}
			fmt.Printf("%-40s pausas=%d\n", a.Name, n)
		}
	}

	var ms runtime.MemStats
	runtime.ReadMemStats(&ms)
	fmt.Printf("MemStats NumGC=%d PauseTotal=%.3fms HeapAlloc=%.1fMiB NextGC=%.1fMiB GCCPUFraction=%.4f\n",
		ms.NumGC, float64(ms.PauseTotalNs)/1e6, float64(ms.HeapAlloc)/(1<<20),
		float64(ms.NextGC)/(1<<20), ms.GCCPUFraction)
}
Compilado e executado com GODEBUG=gctrace=1, esta é uma parte real da saída. A execução completa tem 35 linhas de gc, e mostro as primeiras, uma do meio e as últimas:
gc 1 @0.002s 4%: 0.052+7.7+0.26 ms clock, 0.52+0.29/1.5/0+2.6 ms cpu, 3->5->4 MB, 4 MB goal, 0 MB stacks, 0 MB globals, 10 P
gc 2 @0.013s 4%: 0.019+2.0+0.039 ms clock, 0.19+0.088/2.1/0+0.39 ms cpu, 7->8->7 MB, 8 MB goal, 0 MB stacks, 0 MB globals, 10 P
...
gc 14 @0.222s 7%: 0.064+4.5+0.028 ms clock, 0.64+0.084/10/0+0.28 ms cpu, 49->50->24 MB, 56 MB goal, 0 MB stacks, 0 MB globals, 10 P
...
gc 34 @0.512s 6%: 0.065+6.3+0.22 ms clock, 0.65+0.097/9.8/1.1+2.2 ms cpu, 48->54->28 MB, 53 MB goal, 0 MB stacks, 0 MB globals, 10 P
gc 35 @0.529s 6%: 0.069+4.1+0.010 ms clock, 0.69+0.62/6.7/1.0+0.10 ms cpu, 51->55->27 MB, 57 MB goal, 0 MB stacks, 0 MB globals, 10 P
vivos=200000 tempo=532ms
/gc/cycles/total:gc-cycles               34
/gc/heap/live:bytes                      30070160
/gc/heap/goal:bytes                      60334442
/memory/classes/total:bytes              74275096
/cpu/classes/gc/total:cpu-seconds        0.3934
/gc/pauses:seconds                       pausas=69
MemStats NumGC=35 PauseTotal=11.725ms HeapAlloc=54.7MiB NextGC=54.5MiB GCCPUFraction=0.0692
A linha gc 14 é a que decodifico na figura abaixo. Os campos são: o número do ciclo (gc 14), o instante em segundos desde o início do processo (@0.222s), a fração do tempo gasta em GC desde o início (7%), as três fases em relógio (0.064+4.5+0.028 ms clock), as três fases em CPU (0.64+0.084/10/0+0.28 ms cpu), o heap no início, no fim da marcação e o heap vivo (49->50->24 MB), a meta do pacer (56 MB goal), a pilha e os globais varridos, e o número de processadores (10 P).
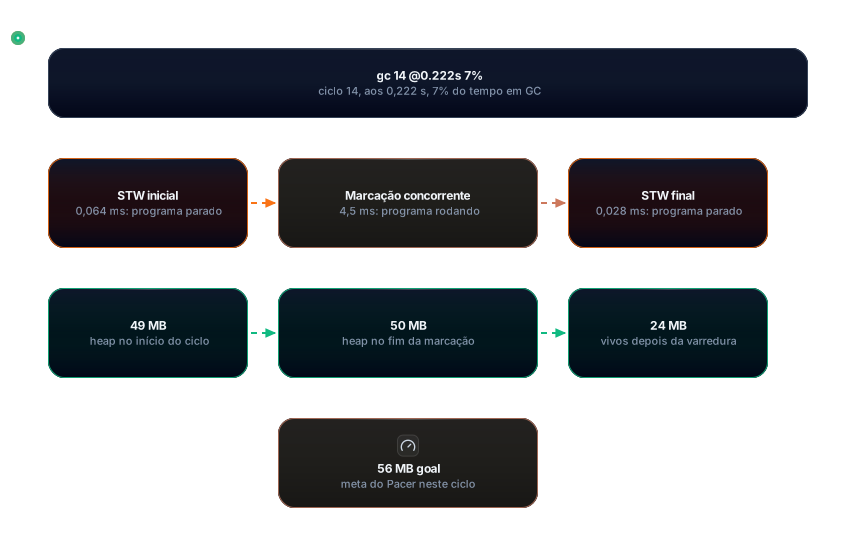
A linha do gctrace descreve o trabalho do coletor, e não o que o programa sentiu. Para o programa, o que importa é a combinação de pausa, tempo de marcação e CPU dividida. A segunda forma de medir é a biblioteca runtime/metrics, que a própria documentação do gctrace cita como equivalente a cada campo. As métricas que usei são /gc/cycles/total:gc-cycles, /gc/heap/live:bytes, /gc/heap/goal:bytes, /memory/classes/total:bytes, /cpu/classes/gc/total:cpu-seconds e o histograma /gc/pauses:seconds. Essa API é a que você deve preferir para exportar métricas, porque cada métrica tem nome, tipo e unidade explícitos.
A terceira forma é runtime.MemStats. A documentação diz que ele reflete o estado do alocador até o momento da chamada, diferente do perfil de heap, que é uma fotografia do fim do último ciclo. Os campos mais úteis são NumGC, PauseTotalNs, HeapAlloc, NextGC e GCCPUFraction. A doc de GCCPUFraction diz que ele é a fração do tempo de CPU disponível que o GC usou desde o início do programa. No teste, o valor de 0,0692 bate com os 6% a 7% que o gctrace imprimiu durante o programa.
10. Erros comuns
O erro mais frequente é culpar o coletor pelo que é, na verdade, custo de alocação. Ele aparece quando o programa cria um objeto por requisição, a latência sobe, e alguém ajusta GOGC esperando resolver. Para ver o efeito, rodei um benchmark com duas versões de uma função que processa um corpo de 4 KiB. Uma aloca um buffer novo por chamada, e a outra reaproveita buffers de um sync.Pool:
package aula

import (
	"sync"
	"testing"
)

var sinkBuf []byte

// Aloca um buffer novo de 4 KiB a cada chamada. Como o buffer escapa para
// a variável global, cada chamada gera lixo para o coletor.
func processaSemPool(entrada []byte) {
	buf := make([]byte, 4096)
	copy(buf, entrada)
	sinkBuf = buf
}

var pool = sync.Pool{New: func() any { return make([]byte, 4096) }}

// Reutiliza buffers do sync.Pool: em regime estável quase nada novo é alocado.
func processaComPool(entrada []byte) {
	buf := pool.Get().([]byte)
	copy(buf, entrada)
	sinkBuf = buf
	pool.Put(buf)
}

var entrada = []byte("corpo de uma requisição de exemplo")

func BenchmarkSemPool(b *testing.B) {
	b.ReportAllocs()
	for i := 0; i < b.N; i++ {
		processaSemPool(entrada)
	}
}

func BenchmarkComPool(b *testing.B) {
	b.ReportAllocs()
	for i := 0; i < b.N; i++ {
		processaComPool(entrada)
	}
}
Saída real, em Apple M1 Max:
BenchmarkSemPool-10    	  406797	      5651 ns/op	    4096 B/op	       1 allocs/op
BenchmarkComPool-10    	26527104	       106.1 ns/op	      24 B/op	       1 allocs/op
A versão com pool ficou entre 40 e 50 vezes mais rápida, e ainda aloca 24 bytes por operação. Esse resto vem de colocar o slice dentro de uma interface{} ao chamar Put, e não de alocação de buffer. Depois, rodei só a versão sem pool com perfil de CPU e olhei as funções acumuladas. mallocgc ficou com cerca de 0,19 s, e o varredor em background (bgsweep) com 0,17 s. A marcação (gcBgMarkWorker) apareceu com 0,04 s, porque quase nada do lixo estava vivo na hora da marcação. A conclusão é que o custo estava na alocação e na varredura, e ajustar GOGC não muda a alocação. O custo, portanto, está espalhado pelo runtime. O perfil também mostra frames de madvise, que é o runtime devolvendo memória ao sistema, e eu não os li como custo de marcação. A solução é alocar menos. O sync.Pool existe por isso: a documentação diz que ele serve para guardar itens alocados e não usados, “relieving pressure on the garbage collector”.
O segundo erro é manter uma referência longa. Um slice é uma janela sobre um array, e a janela segura o array inteiro. O programa abaixo guarda só 16 bytes, mas segura um array de 50 MiB:
package main

import (
	"fmt"
	"runtime"
	"runtime/metrics"
)

// trechoRuim devolve só 16 bytes, mas o slice aponta para o array de 50 MiB inteiro
func trechoRuim() []byte {
	grande := make([]byte, 50<<20)
	grande[0] = 1
	return grande[:16]
}

// trechoBom copia os 16 bytes para um array novo e deixa o grande morrer
func trechoBom() []byte {
	grande := make([]byte, 50<<20)
	grande[0] = 1
	copia := make([]byte, 16)
	copy(copia, grande[:16])
	return copia
}

var guardado []byte

func vivoMiB() float64 {
	runtime.GC()
	amostra := []metrics.Sample{{Name: "/gc/heap/live:bytes"}}
	metrics.Read(amostra)
	return float64(amostra[0].Value.Uint64()) / (1 << 20)
}

func main() {
	fmt.Printf("antes de guardar nada:               live=%.2f MiB\n", vivoMiB())

	guardado = trechoRuim()
	fmt.Printf("guardei trechoRuim (16 bytes):        live=%.2f MiB\n", vivoMiB())

	guardado = nil
	fmt.Printf("soltei o slice:                       live=%.2f MiB\n", vivoMiB())

	guardado = trechoBom()
	fmt.Printf("guardei trechoBom (cópia de 16 bytes): live=%.2f MiB\n", vivoMiB())
}
antes de guardar nada: live=0.21 MiB
guardei trechoRuim (16 bytes): live=50.22 MiB
soltei o slice: live=0.22 MiB
guardei trechoBom (cópia de 16 bytes): live=0.22 MiBO mesmo vale para um mapa que nunca remove entradas, um cache sem limite, ou uma goroutine bloqueada que segura um canal e os dados ligados a ele. No último caso, a goroutine está viva, e a pilha dela é raiz. A partir do Go 1.27, o perfil goroutineleak do pprof (que está em disponibilidade geral, segundo as notas de versão) ajuda a encontrar essas goroutines. Veja Memory Leaks para o caso geral.
O terceiro erro é confundir pausa com latência. Uma pausa de 0,1 ms não diz nada sobre a latência de uma requisição que passou por uma marcação concorrente de 10 ms, durante a qual o programa dividiu a CPU com o coletor e pagou a barreira. O gctrace mostra as duas pausas, mas não mostra o percentil 99 de uma API. Se a latência subiu, meça a latência de ponta a ponta antes de culpar o coletor, e depois compare com o tempo de CPU gasto pelo GC em /cpu/classes/gc/total:cpu-seconds.
Um quarto erro, menos técnico, é chamar runtime.GC() para “limpar a memória” dentro de um caminho de requisição. Isso força um ciclo completo naquele instante. O que você ganha em memória, perde em latência, e o ciclo forçado não resolve um problema de alocação. Use a chamada em testes e ferramentas de diagnóstico.
11. Boas práticas e os motivos
A primeira prática é medir antes de ajustar. Um GOGC diferente só faz sentido depois de você ver o número de ciclos, a fração de CPU e a latência com o padrão. Sem essa linha de base, a mudança é um palpite.
A segunda é reduzir a taxa de alocação nos caminhos quentes. Menos objetos novos significam menos marcação, menos varredura e menos barreira. A forma mais direta é reaproveitar buffers com sync.Pool, como na seção 10, desde que o objeto reutilizado seja zerado antes do uso. O motivo é que o pool pode descartar itens a qualquer momento, então ele é um cache, e não um armazenamento.
A terceira é dar ao processo um GOMEMLIMIT abaixo do limite do contêiner, com folga para o binário, as pilhas e o que não passa pelo heap. A folga exata depende do seu programa, e a seção 8 mostrou o custo de apertá-la demais.
A quarta é tratar referências longas como dívida. Ao extrair uma parte pequena de um dado grande, copie a parte. Ao guardar um objeto dentro de um cache, pense em quando ele deixa de ser necessário e remova a referência.
A quinta é olhar a fração de CPU do GC junto com a latência. Se a fração ficou alta e a latência também, o problema é de alocação ou de memória viva grande. Se a fração ficou baixa e a latência ficou alta, procure outra causa antes de mexer no coletor.
12. Exercícios com resposta de referência
Exercício 1. Um contêiner tem uma cota de 512 MiB. Escolha um valor para GOMEMLIMIT e justifique. Não existe um percentual oficial, então a sua resposta deve dizer por que escolheu a folga.
Resposta de referência: uma escolha razoável é reservar 15% da cota, o que dá 512 × 0,85 = 435,2, então GOMEMLIMIT=435MiB. A justificativa é que o limite inclui o heap e as pilhas das goroutines, mas não o binário nem a memória de bibliotecas externas, então é preciso deixar uma margem para eles e para picos de alocação. Esse número é uma escolha de engenharia, e a documentação não o prescreve. Um valor de 100% da cota deixaria o processo sem margem para as memórias que o limite não controla.
Exercício 2. Antes de rodar, diga quais objetos sobrevivem a um ciclo do coletor:
package main

type Nó struct {
	Valor int
	Próx  *Nó
}

var cabeça *Nó

func main() {
	a := &Nó{Valor: 1}
	b := &Nó{Valor: 2}
	a.Próx = b
	b.Próx = a
	cabeça = b
	a = nil
	b = nil
	// ponto de observação
}
Resposta de referência: cabeça é uma raiz global que aponta para b, e b aponta para a. Logo, os dois sobrevivem, mesmo com as variáveis locais a e b zeradas. O ciclo não é o problema aqui, porque a raiz alcança os dois. Se você trocar cabeça = b por cabeça = nil, os dois se tornam lixo, apesar de ainda se apontarem.
Exercício 3. Use a linha abaixo, do gctrace real da seção 9, para responder: (a) qual fase é uma pausa STW, (b) quanto de heap ao final da marcação não é vivo, e (c) qual foi a meta do pacer.
gc 14 @0.222s 7%: 0.064+4.5+0.028 ms clock, 0.64+0.084/10/0+0.28 ms cpu, 49->50->24 MB, 56 MB goal, 0 MB stacks, 0 MB globals, 10 PResposta de referência: (a) as fases STW são a primeira (0,064 ms) e a última (0,028 ms), e a do meio (4,5 ms) é concorrente. (b) O heap ao fim da marcação era 50 MB e o heap vivo é 24 MB, então 26 MB do heap não estavam marcados como vivos e serão devolvidos pela varredura. Essa conta usa a definição de cada campo na documentação, e não é o total liberado, que depende da varredura. (c) A meta do pacer neste ciclo foi 56 MB.
Exercício 4. Corrija o código abaixo para que ele não segure o array inteiro, sem mudar a assinatura da função.
func cabecalho(corpo []byte) []byte {
	return corpo[:8]
}
Resposta de referência: a função devolve um slice que aponta para o array de corpo, então quem guardar o cabeçalho segura todo o corpo. A correção é copiar os 8 bytes para um array novo:
func cabecalho(corpo []byte) []byte {
	copia := make([]byte, 8)
	copy(copia, corpo[:8])
	return copia
}
Se corpo tiver menos de 8 bytes, a versão original entra em pânico, e a versão corrigida também. Para o caso seguro, verifique o tamanho antes.
13. Glossário
- Alcançabilidade: propriedade de um objeto que pode ser atingido por um caminho de ponteiros a partir de uma raiz.
- Raiz: ponto de entrada da marcação, que são variáveis globais, variáveis locais das goroutines em execução e estruturas do runtime.
- Marcação: fase em que o coletor percorre o grafo a partir das raízes e marca os objetos vivos.
- Varredura: fase em que o coletor devolve ao alocador a memória dos objetos que não foram marcados.
- Tricolor: abstração que divide os objetos em branco (não visitado), cinza (fila de trabalho) e preto (vivo e já examinado).
- Barreira de escrita: trecho de código inserido antes de cada gravação de ponteiro durante a marcação, para que o coletor não perca objetos vivos.
- STW (stop-the-world): pausa em que todas as goroutines do programa param.
- Mark assist: quando uma goroutine aloca muito durante a marcação, o runtime pode fazê-la ajudar no trabalho de marcação.
- Pacer: componente do runtime que decide quando disparar a coleta, para que ela termine a tempo da meta de memória.
- Live heap: memória do heap que sobreviveu à última marcação.
GOGC: variável que define a porcentagem de crescimento do heap, sobre a memória viva, antes de uma nova coleta.GOMEMLIMIT: limite flexível de memória gerenciada pelo runtime, com sufixos na base 2.- gctrace: saída de diagnóstico ativada por
GODEBUG=gctrace=1, com uma linha por ciclo. runtime/metrics: API estável para ler métricas do runtime, com nomes como/gc/heap/live:bytes.MemStats: estrutura com estatísticas do alocador, lida comruntime.ReadMemStats.
14. O que não foi confirmado
- Pausa “menor que 1 milissegundo” ou “sub-milissegundo” como garantia. As notas do Go 1.5 e 1.8 dão limites e tendências (“almost always under 10 milliseconds”, “usually under 100 microseconds”), e o guia oficial diz “brief”. Nas minhas medições, a média ficou em frações de milissegundo, mas o máximo chegou a dezenas de milissegundos numa máquina de desenvolvimento. Não há teto garantido.
- Percentual de 85% a 90% da cota do contêiner para
GOMEMLIMIT. A nota antiga afirmava isso, mas não encontrei a afirmação nas fontes oficiais. Não a repito como regra. - Redução de 15% nas alocações de objetos pequenos no Go 1.27, citada na nota antiga. As notas de versão descrevem chamadas de alocação especializadas por tamanho, com ganho de “up to 30%” em alocações pequenas e “~1%” no conjunto dos programas, e não mencionam o número de 15% nem um redesenho do alocador. Removi a afirmação.
- Randomização do heap como defesa contra ataques de ROP. As notas do Go 1.26 falam de randomização da base do heap “to make it harder for attackers to predict memory addresses”, com ênfase no cgo, e não descrevem o ataque citado na nota antiga. Não a uso como argumento.
- Ganho de desempenho do Green Tea GC. A documentação oficial estima entre 10% e 40% de redução do custo do GC em programas reais, e não medi isso aqui. O Green Tea é o padrão desde o Go 1.26, o que confirmei nas notas de versão.
- Ordem de execução dos cleanups de objetos em ciclo. A documentação diz que a ordem não é especificada, e a minha execução mostrou ordens diferentes em rodadas distintas.
- Comportamento do mark assist isolado. Descrevo o mecanismo, mas não medi o tempo gasto nele.
- Os números desta aula vêm de uma única máquina (Apple M1 Max, 10 processadores lógicos, Go 1.27.2). Eles servem para mostrar tendências, e não para comparar com outro ambiente.
- O guia oficial de GC declara que descreve o coletor “as of Go 1.19”. Os comportamentos de versões posteriores que citei vêm das notas de versão e do código do runtime, e não do guia.
- Formato do gctrace. A documentação diz que o formato “is subject to change”, então um campo pode mudar em uma versão futura.
15. Fontes
Consultadas em 2026-11-03.
- A Guide to the Go Garbage Collector, guia oficial de GC do Go (com a nota de que descreve o comportamento “as of Go 1.19”).
- Go 1.26 Release Notes, para o Green Tea GC padrão, a randomização da base do heap e o goroutineleak experimental.
- Go 1.27 Release Notes, para o goroutineleak em disponibilidade geral e a especialização de alocações pequenas.
- Go 1.5 Release Notes e Go 1.8 Release Notes, para a concorrência do coletor e as pausas.
- Proposta 17503, Eliminate stop-the-world stack re-scanning, para a barreira híbrida e a autoria.
- pkg.go.dev/runtime, para o formato do gctrace,
GOGC,GOMEMLIMIT,MemStatseAddCleanup. - pkg.go.dev/runtime/metrics, para os nomes das métricas.
- pkg.go.dev/runtime/debug, para
SetMemoryLimit. - pkg.go.dev/sync, para o
sync.Pool. - Código-fonte do runtime, mbarrier.go, para o comentário da barreira híbrida.
- Toolchain local go1.27.2, com
go doce o código deruntime/mgcpacer.goeruntime/mgclimit.go, para as constantes de 25% e 50%.
Relacionados
- Heap
- Stack
- Call Stack
- Preempção
- Scheduler
- Thread
- Goroutine
- Memory Leaks
- PProf
- Ponteiros
- Ponteiros, Memória e Escape Analysis
- Trilha de Go