Arquitetura de software · parte 7 de 7
Monólito, monólito modular e microsserviços: o guia definitivo de arquitetura
Aprenda a anatomia, vantagens, desvantagens e trade-offs operacionais entre monólito clássico, monólito modular e microsserviços.
intermediárioRevisada em · 22 min de leitura
Imagine que você decidiu abrir uma padaria com dois amigos. No primeiro mês, todos trabalham na mesma bancada: um sova a massa, outro cuida do forno e o terceiro atende o balcão. Se alguém precisa de farinha ou de troco, basta esticar o braço ou falar em voz alta. A comunicação leva meio segundo e o custo de coordenação é zero. Isso é um monólito. Conforme o negócio cresce, os três decidem dividir a bancada com divisórias de madeira e gavetas identificadas: ninguém mexe no dinheiro do caixa sem pedir, e o padeiro não joga farinha nos pães prontos, mas todos continuam sob o mesmo teto, compartilhando a mesma conta de luz. Isso é um monólito modular. Meses depois, encantados com histórias de grandes redes industriais, vocês decidem alugar três galpões em bairros diferentes da cidade, um só para a farinha, outro só para assar e o terceiro para vender, contratando uma frota de motoboys para levar massa crua e dinheiro de um lado para o outro o dia inteiro. Se chover, se um pneu furar ou se o motoboy esquecer o troco, o cliente não recebe o pão quente. Isso são microsserviços.
A discussão sobre como estruturar sistemas corporativos costuma ser dominada por modismos. Por anos, o monólito foi tratado como um pecado de nascença, um sinônimo injusto de código bagunçado. Da mesma forma, microsserviços foram vendidos como a solução mágica para qualquer gargalo, ignorando que dividir um sistema em dezenas de processos remotos troca a complexidade de código pela complexidade de rede e infraestrutura. No meio desse fogo cruzado, o monólito modular ressurgiu como a resposta mais pragmática e eficiente para a grande maioria das empresas: a organização lógica de serviços independentes, mas sem o imposto cobrado pela rede e pela consistência distribuída.
Esta aula disseca esses três modelos arquiteturais. Começamos pela topologia de cada um, analisamos as vantagens reais e as armadilhas operacionais, examinamos como o código e o banco de dados se comportam na prática, detalhamos a mecânica de transações em memória contra sagas distribuídas, e encerramos com uma matriz de decisão objetiva para você escolher a ferramenta certa para o estágio real do seu time.
mapa da aula
- O espectro arquitetural: desmistificando código e infraestrutura.
- Monólito tradicional: simplicidade de desenvolvimento e o risco da lama.
- Monólito modular: fronteiras estritas de domínio sob o mesmo processo.
- Microsserviços: autonomia organizacional, escala assimétrica e o imposto da rede.
- Transações e consistência: o salto de ACID em memória para sagas distribuídas.
- A e a dinâmica de equipes.
- Árvore de decisão prática: quando usar cada modelo.
- Como migrar com segurança: a regra do monólito primeiro.
- Erros comuns e antipadrões clássicos.
- Exercícios reflexivos e glossário técnico.
1. o espectro arquitetural
A arquitetura de um software não é uma escolha binária entre o passado arcaico e o futuro brilhante. Ela é um espectro de distribuição física e lógica. Em uma ponta do espectro está o monólito simples, onde todo o código roda dentro de um único processo de sistema operacional e conversa com um banco de dados unificado. Na outra ponta estão os microsserviços, onde o sistema é estilhaçado em múltiplos processos autônomos, hospedados em máquinas ou containers isolados, comunicando-se exclusivamente por protocolos de rede como HTTP, gRPC ou filas de mensageria, com bancos de dados estritamente segregados.
Entre esses dois extremos vive o monólito modular. Ele compartilha com o monólito simples a virtude do processo único de execução e do deploy atômico. Porém, ele adota dos microsserviços o rigor de isolamento: o código é dividido em módulos com contratos públicos explícitos, impedindo que um módulo acesse as classes internas ou o armazenamento do outro.
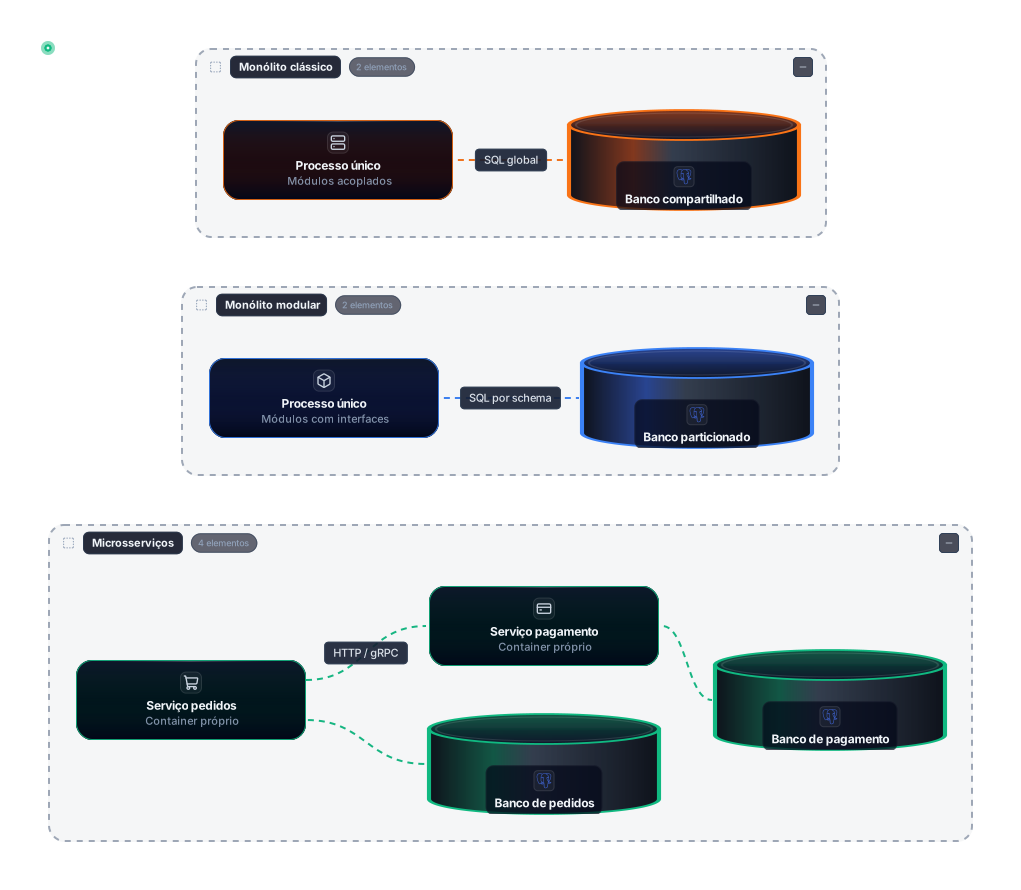
A figura acima resume essa topologia. À esquerda, o monólito clássico agrupa todos os domínios em um único bloco de execução que executa consultas SQL em um banco com tabelas globais. No centro, o monólito modular preserva o deploy único, mas estabelece fronteiras internas: a comunicação entre pedidos e pagamentos ocorre em nanossegundos dentro da própria memória da aplicação, e o banco é particionado em schemas lógicos que respeitam cada domínio. À direita, os microsserviços separam pedidos e pagamentos em servidores diferentes, forçando cada chamada a atravessar a rede e obrigando cada serviço a gerenciar seu próprio banco dedicado.
Compreender esse espectro exige separar dois conceitos que frequentemente são confundidos: arquitetura de software (como o código se organiza logicamente) e arquitetura de implantação (como os binários rodam na infraestrutura). Um monólito pode ser extraordinariamente bem arquitetado, limpo e desacoplado. Da mesma forma, um conjunto de microsserviços pode ser um amontoado espaguete de chamadas circulares e tabelas compartilhadas, criando o pior dos mundos: o monólito distribuído.
2. monólito tradicional
O monólito tradicional é o formato padrão da indústria desde a criação do software comercial. Em termos de infraestrutura, ele é elegante em sua simplicidade: você compila um único executável (um binário em Go, um arquivo JAR em Java ou uma pasta de scripts Node.js), faz o deploy em um servidor ou container e aponta a aplicação para uma instância de banco de dados relacional.
O grande trunfo do monólito clássico é a produtividade no início do projeto. A experiência de desenvolvimento local (DX) é imbatível. Um novo engenheiro clona o repositório, roda um comando e a aplicação inteira está rodando na sua máquina. A depuração com breakpoints é direta, permitindo inspecionar uma requisição desde a camada web até a execução da query SQL sem precisar de ferramentas complexas de telemetria distribuída. Além disso, as refatorações são triviais: se uma regra de cobrança muda de assinatura, a IDE altera todas as chamadas no projeto em três segundos com garantia estrita do compilador.
O outro benefício monumental é a local. Se um cliente fecha uma compra, a aplicação inicia uma transação no banco de dados (BEGIN), insere a linha na tabela de pedidos, decrementa a quantidade na tabela de estoque, grava a fatura e confirma tudo de forma atômica com um COMMIT. Se a energia cair ou se o saldo for insuficiente, o banco de dados executa um rollback perfeito. O sistema nunca fica em um estado inconsistente onde o estoque foi baixado mas o pedido não foi criado.
A desvantagem do monólito tradicional não é técnica em sua origem, mas entrópica e organizacional. Sem ferramentas rigorosas de contenção, a conveniência de ter tudo no mesmo processo vira uma armadilha. Um desenvolvedor pressionado por um prazo faz um JOIN direto entre a tabela de usuários e a tabela de pagamentos dentro de um controller de catálogo. Em poucos meses, os limites de domínio deixam de existir, transformando o sistema naquilo que Brian Foote e Joseph Yoder batizaram em 1997 de “Big Ball of Mud” (a grande bola de lama): um emaranhado onde qualquer alteração em uma linha causa efeitos colaterais imprevisíveis em módulos aparentemente não relacionados.
O segundo problema é o raio de explosão (blast radius). Como todos os componentes compartilham a mesma memória e os mesmos threads do sistema operacional, uma falha catastrófica em um relatório pesado que causa falta de memória (Out Of Memory) derruba o processo inteiro, paralisando tanto o checkout quanto o login dos usuários.
3. monólito modular
O monólito modular é a aplicação intencional dos princípios do Domain-Driven Design (DDD) dentro de uma única unidade de implantação. Em vez de permitir que o código vire uma teia de dependências caóticas, a aplicação é dividida em módulos independentes que refletem os Bounded Contexts (contextos delimitados) do negócio.
Cada módulo funciona como se fosse um microsserviço conceitual, possuindo duas áreas bem definidas:
- API Pública (Contrato): Um conjunto enxuto de interfaces, DTOs (Data Transfer Objects) e eventos de domínio que o módulo exporta para o restante do sistema.
- Implementação Privada (Internals): Todas as entidades, casos de uso, repositórios, controllers e regras de negócio internas que ficam estritamente ocultas. Nenhum código de fora do módulo tem permissão de importar ou instanciar essas classes.
A barreira não fica apenas no código; ela se estende aos dados. No monólito modular, múltiplos módulos podem rodar sobre a mesma instância física do PostgreSQL, mas cada módulo é dono absoluto do seu próprio schema de banco de dados (por exemplo, pedidos.ordem, catalogo.produto, pagamento.fatura). Fazer um JOIN SQL cruzando tabelas de schemas diferentes é uma violação grave de arquitetura. Se o módulo de pedidos precisa saber o nome de um produto, ele solicita essa informação pela API pública do catálogo ou mantém uma projeção local atualizada por eventos.
Como garantir que os desenvolvedores não violem essas fronteiras no calor do dia a dia? A resposta está nos linters de arquitetura e na estrutura de compilação. Em Java ou Kotlin, bibliotecas como ArchUnit verificam nos testes unitários se alguma classe do pacote billing.internal foi importada por orders. No ecossistema TypeScript, ferramentas como Nx ou ESLint com regras de limites de módulos impedem a importação. Em Go, o próprio sistema de pacotes internos (/internal) impede compilações ilegais.
A maior vantagem do monólito modular é oferecer 90% dos benefícios atribuídos aos microsserviços (organização limpa, baixo acoplamento, alta coesão e facilidade de manutenção por times diferentes) sem cobrar o pedágio brutal da infraestrutura distribuída. O deploy continua sendo um único artefato, a infraestrutura continua sendo um servidor simples e os testes automatizados continuam rodando em segundos. Caso um módulo específico realmente precise de escala independente no futuro, extraí-lo para um microsserviço é uma operação quase cirúrgica, porque a fronteira lógica já está 100% pronta.
4. microsserviços
A arquitetura de microsserviços é a distribuição física e organizacional do sistema. Cada serviço é uma aplicação autônoma completa, responsável por uma única capacidade de negócio, operando em seu próprio ciclo de vida, com seu próprio pipeline de integração contínua (CI/CD) e seu próprio banco de dados isolado (Database per Service).
A principal força motriz por trás dos microsserviços é a autonomia organizacional de grandes empresas, um reflexo direto da Lei de Conway. Quando uma empresa atinge centenas de engenheiros, colocar todos para commitar no mesmo repositório e disputar o mesmo pipeline de deploy gera filas, bloqueios e reuniões intermináveis de homologação. Com microsserviços, a equipe responsável pelo serviço de recomendações pode fazer dez deploys por dia sem pedir autorização ou coordenar janelas de manutenção com a equipe de pagamentos.
Outra vantagem genuína é a escalabilidade assimétrica. Se a sua plataforma de streaming tem 500 mil requisições por segundo na busca de vídeos, mas apenas 20 requisições por segundo na alteração de planos de assinatura, você pode alocar 200 réplicas do serviço de busca e manter apenas 2 réplicas do serviço de faturamento. Em um monólito tradicional, você seria forçado a escalar a aplicação inteira, desperdiçando memória com códigos que não recebem carga.
Porém, essa autonomia tem um custo elevadíssimo que frequentemente é omitido em palestras de tecnologia. O momento em que você divide uma chamada de função em duas pontas de rede é o momento em que você ingressa no universo dos sistemas distribuídos e se depara com algumas das falácias da computação distribuída, listadas por Peter Deutsch e James Gosling:
- A rede não é confiável (pacotes são descartados, conexões caem).
- A latência não é zero (uma chamada em memória leva cerca de 10 nanossegundos; um round-trip numa rede local leva da ordem de 0,1 a 1 milissegundo, de 10 mil a 100 mil vezes mais).
- A largura de banda não é infinita.
- A topologia da rede muda constantemente.
Além disso, a complexidade operacional dispara. Para manter um ecossistema de microsserviços saudável em produção, a empresa precisa de orquestradores como Kubernetes, service meshes ou API gateways, rastreamento distribuído (OpenTelemetry/Jaeger) para conseguir descobrir em qual dos 40 serviços uma requisição falhou, agregação centralizada de logs e contratos estritos de API (usando gRPC, Protobuf ou OpenAPI com testes de contrato via Pact). Se a organização não possui um time de engenharia de plataforma maduro, os microsserviços drenam a energia dos desenvolvedores, que passam mais tempo depurando infraestrutura do que entregando valor de negócio.
Pergunta de entrevistaO que é um monólito modular e como você garante que as fronteiras entre módulos sejam respeitadas?
É a aplicação intencional dos princípios de DDD dentro de uma única unidade de implantação: a aplicação é dividida em módulos que refletem os contextos delimitados do negócio. Cada módulo tem uma API pública, com interfaces, DTOs e eventos, e uma implementação privada que nenhum código de fora pode importar. A barreira também vale para os dados: os módulos podem usar a mesma instância do PostgreSQL, mas cada um é dono do seu schema, e um JOIN entre schemas de módulos diferentes é uma violação. Para impedir que as fronteiras sejam quebradas no dia a dia, uso linters de arquitetura, como o ArchUnit em Java ou Kotlin, rodando nos testes. O ganho é parte dos benefícios dos microsserviços sem o custo de operar vários serviços distribuídos.
5. transações e consistência
A diferença mais profunda entre sistemas monolíticos e distribuídos não está na linguagem ou no container, mas na forma como eles lidam com a verdade dos dados.
No monólito (inclusive no modular), a integridade dos dados repousa sobre as garantias ACID (Atomicidade, Consistência, Isolamento e Durabilidade) oferecidas pelo mecanismo do banco de dados relacional. Quando um cliente clica em “Finalizar Pedido”, a aplicação executa o fluxo em um bloco atômico. Se o pagamento for recusado, a exceção dispara o rollback e nenhum registro de pedido orfão permanece no sistema.
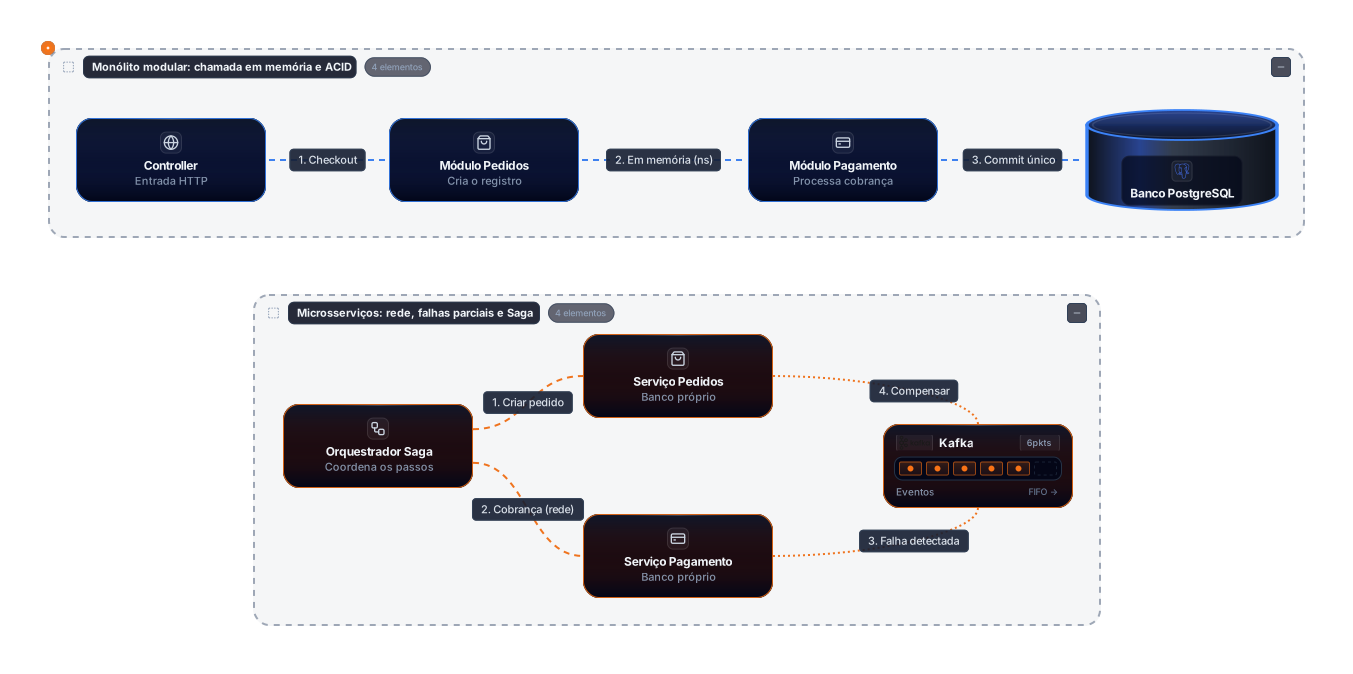
A ilustração acima detalha esse contraste crucial. No painel superior, o monólito modular recebe a requisição HTTP no controller, delega para o módulo de pedidos que invoca o módulo de pagamentos diretamente na memória da máquina e conclui a operação com um único commit atômico no PostgreSQL. No painel inferior, os microsserviços precisam de um coordenador de Saga. O orquestrador chama o serviço de pedidos pela rede e em seguida chama o serviço de pagamentos. Se a chamada de cobrança falhar ou estourar o timeout, o pedido já foi gravado no banco de pedidos. O sistema é obrigado a publicar uma mensagem em um tópico do Kafka para que o serviço de pedidos consuma o evento de compensação e altere o status daquele pedido para cancelado.
Em microsserviços, o modelo de banco de dados exclusivo por serviço aniquila a possibilidade de transações ACID globais (o antigo Two-Phase Commit é inviável na internet moderna por causar gargalos extremos de concorrência e pontos únicos de falha). O arquiteto é forçado a abraçar a e o Teorema CAP (que dita que, em presença de partição de rede, é preciso escolher entre consistência estrita ou disponibilidade).
O padrão mais utilizado para gerenciar transações de negócio em microsserviços é a Saga. Uma saga é uma sequência de transações locais em cada serviço. Para cada passo que altera dados, o engenheiro precisa obrigatoriamente escrever uma transação compensatória: uma ação semântica de desfazimento. Se você reservou o quarto de hotel no passo 1 e a reserva do voo falhou no passo 2, a saga precisa executar a compensação de cancelar o quarto. Escrever, testar e monitorar sagas com casos extremos (como mensagens duplicadas, mensagens fora de ordem e falhas na própria compensação) é uma das tarefas mais complexas da engenharia de software.
6. a lei de conway e a dinâmica de equipes
Em 1968, o programador Melvin Conway enunciou uma observação sociotécnica que se tornou uma lei imutável da indústria de software:
“Organizações que projetam sistemas são forçadas a produzir projetos que são cópias das estruturas de comunicação dessas organizações.”
A Lei de Conway explica por que tantas migrações de arquitetura fracassam miseravelmente. Se uma empresa possui 8 desenvolvedores sentados na mesma sala (ou na mesma chamada do Slack) e decide adotar 25 microsserviços porque uma gigante do Vale do Silício faz assim, esses 8 desenvolvedores passarão metade do tempo administrando conflitos de branches em repositórios separados e criando versões de bibliotecas compartilhadas. A arquitetura física não reflete a estrutura humana.
Microsserviços são, antes de tudo, uma ferramenta de escala humana, e não apenas técnica. Eles fazem sentido quando uma empresa tem dezenas de squads independentes (geralmente acima de 50 a 100 engenheiros) onde a comunicação direta entre todos se tornou impossível. O limite do serviço vira a fronteira da equipe: o time de busca cuida do serviço de busca e define seu próprio roadmap.
Se a sua equipe tem menos de 20 ou 30 engenheiros, o monólito modular é a estrutura que espelha perfeitamente a organização. Ele permite que subtimes cuidem de módulos específicos dentro da mesma base de código sem sofrer com a sobrecarga de gerenciar pipelines, deploys e redes distribuídas separadas.
Pergunta de entrevistaComo a consistência de dados muda ao sair de um monólito para microsserviços?
No monólito, inclusive no modular, a integridade dos dados repousa nas garantias ACID do banco. Um checkout roda num bloco atômico: se o pagamento é recusado, a exceção dispara o rollback e nenhum registro órfão permanece. Em microsserviços, com banco exclusivo por serviço, não há transação ACID global, e o two-phase commit é tratado como inviável por causar gargalos de concorrência e pontos únicos de falha. O arquiteto passa a lidar com consistência eventual e com o teorema CAP. O padrão mais usado para transações de negócio é a saga: uma sequência de transações locais, cada uma com uma compensação para desfazer o passo se algo falhar depois. O trade-off é a complexidade das compensações, em troca da autonomia entre os serviços.
7. árvore de decisão prática
Para escapar de debates ideológicos, a escolha da arquitetura deve ser guiada por critérios objetivos e mensuráveis. Três variáveis fundamentais determinam a decisão: o número de equipes autônomas, a maturidade do domínio de negócio e a existência de gargalos operacionais assimétricos.
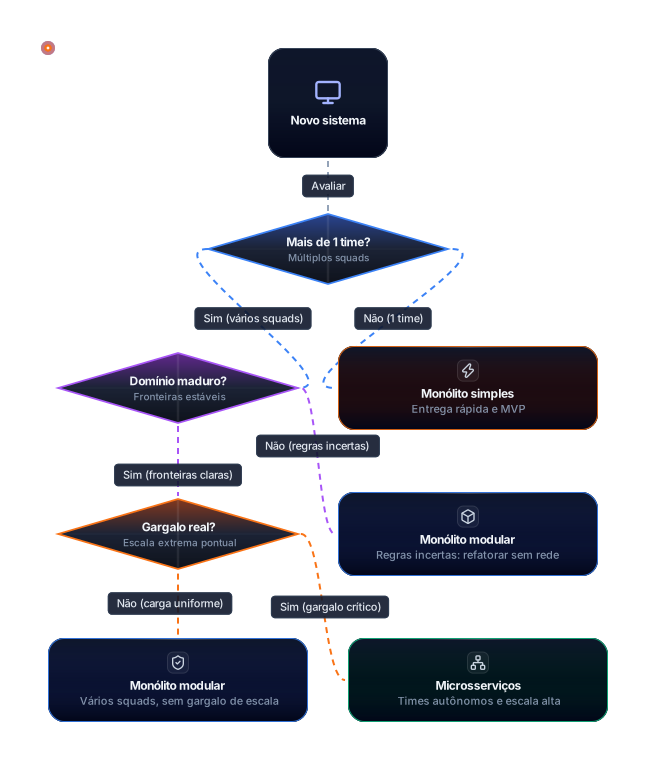
A árvore de decisão acima sintetiza esse caminho racional. A primeira pergunta é organizacional: se o projeto é tocado por um único time enxuto, o monólito clássico ou modular é a escolha que garante a maior velocidade de entrega, permitindo validar o produto no mercado antes que o dinheiro acabe.
A segunda pergunta avalia a estabilidade do domínio. Se você está construindo um produto novo ou explorando um mercado incerto, as regras de negócio mudam semanalmente. Mudar os limites entre dois módulos dentro de um monólito modular é uma refatoração de código que leva horas. Mudar os limites entre dois microsserviços que já possuem bancos separados, contratos de API e pipelines em produção leva semanas ou meses. Portanto, se o domínio ainda está sendo descoberto, permaneça no monólito modular, mesmo que você tenha múltiplos times.
A terceira pergunta avalia a escala e a especialização técnica. Somente quando os limites de negócio já estão consolidados e existem requisitos reais e comprovados de escala extrema ou tecnologias incompatíveis (por exemplo, um motor de processamento em Rust convivendo com um backend de cadastro em TypeScript) é que a extração de microsserviços específicos se justifica.
| Critério de Comparação | Monólito Tradicional | Monólito Modular | Microsserviços |
|---|---|---|---|
| Complexidade operacional | Muito baixa | Baixa | Muito alta |
| Latência entre componentes | Nanossegundos (memória) | Nanossegundos (memória) | Milissegundos (rede) |
| Integridade transacional | ACID local nativo | ACID local nativo | Consistência eventual / Sagas |
| Custo de infraestrutura | Muito baixo | Baixo | Alto a muito alto |
| Facilidade de refatoração | Alta | Média-Alta | Muito baixa |
| Autonomia de deploy por squad | Baixa (fila única) | Média (depende do CI) | Totalmente independente |
| Risco de acoplamento cego | Muito alto (Big Ball of Mud) | Muito baixo (com linters) | Baixo (fronteira física) |
| Tamanho ideal de time | 1 a 10 desenvolvedores | 10 a 50 desenvolvedores | Acima de 50 desenvolvedores |
8. como migrar com segurança: o monólito primeiro
Martin Fowler cunhou o termo “MonolithFirst” para descrever uma estratégia quase infalível observada em projetos de sucesso: comece sempre construindo um monólito, aprenda com o domínio real em produção e só extraia serviços quando a dor da escala organizacional for palpável.
Quase todas as histórias de sucesso com microsserviços que você lê em blogs de tecnologia (como Netflix e Uber) começaram como grandes monólitos. Essas empresas migraram para microsserviços quando atingiram centenas de engenheiros e milhões de usuários ativos, impulsionadas por necessidades reais de organização. Por outro lado, vários projetos que começaram diretamente com microsserviços voltaram a um monólito, porque as fronteiras desenhadas no papel estavam erradas.
O caminho seguro de evolução arquitetural segue três passos claros:
- Comece com um monólito modular bem desenhado: Isole o código por pacotes de domínio, crie APIs públicas para cada módulo e garanta que cada módulo tenha suas próprias tabelas ou schemas.
- Monitore os pontos de pressão reais: Em produção, meça quais módulos sofrem com gargalos de CPU/memória ou quais equipes enfrentam atritos constantes nos deploys.
- Faça a extração cirúrgica pelo Estrangulador (Strangler Fig Pattern): Quando um módulo se tornar um candidato claro a microsserviço (como o processamento de pagamentos ou o envio de notificações), crie o novo serviço externamente, aponte as novas chamadas para ele e gradualmente desligue o módulo antigo no monólito. Como o monólito já era modular, a interface pública do módulo vira quase diretamente a especificação da API do microsserviço.
9. erros comuns e antipadrões
Na hora de desenhar ou migrar essas arquiteturas, certas armadilhas aparecem com frequência previsível:
O primeiro antipadrão é o banco de dados compartilhado entre microsserviços. Se você dividiu a aplicação em dez serviços Node.js, mas todos eles conectam na mesma instância do PostgreSQL e fazem queries cruzadas nas tabelas uns dos outros, você não tem microsserviços. Você tem um monólito distribuído: o pior cenário da computação moderna, combinando a lentidão e a fragilidade da rede com o acoplamento do banco compartilhado. Qualquer alteração em uma coluna do banco quebra cinco serviços simultaneamente.
O segundo erro é a modularidade de fachada no monólito. Criar pastas bonitas como /modulos/pedidos e /modulos/faturamento, mas permitir que a classe de pedidos faça uma importação direta de classes de domínio privadas de faturamento, destrói a modularidade. Sem testes de arquitetura automatizados no pipeline de CI, o monólito modular degrada silenciosamente e volta a ser um monólito clássico acoplado em menos de seis meses.
O terceiro erro é usar chamadas síncronas em cascata em microsserviços. Quando a requisição do usuário chega ao serviço A, que faz um POST HTTP no serviço B, que faz um GET síncrono no serviço C, que consulta o serviço D. Se a taxa de disponibilidade de cada serviço for de 99,5%, a disponibilidade total da cadeia é a multiplicação das quatro probabilidades:
$$0{,}995 \times 0{,}995 \times 0{,}995 \times 0{,}995 \approx 0{,}980 \text{ (98%)}$$
Isso significa que a sua aplicação ficará fora do ar quatro vezes mais tempo do que ficaria se fosse um monólito. Serviços distribuídos devem preferir comunicação assíncrona orientada a eventos para reduzir o acoplamento temporal.
10. prática e glossário
exercícios reflexivos
- Você é o líder técnico de uma fintech iniciante com 5 desenvolvedores, capital para 12 meses e a missão de lançar uma conta digital e emissão de cartões. Qual das três arquiteturas você escolheria no primeiro dia? Justifique considerando custo operacional, velocidade de validação e capacidade de refatoração.
- Imagine um e-commerce construído como monólito modular onde o módulo de checkout precisa verificar se um produto está disponível no módulo de catálogo. Desenhe mentally ou em código como seria essa interação respeitando a regra de nunca fazer queries SQL diretas no schema do outro módulo.
- Um arquiteto propõe que, para migrar um sistema legado para microsserviços, a primeira etapa seja criar 15 repositórios no GitHub e copiar partes do código para cada um, mantendo todos apontados para o mesmo banco de dados Oracle. Aponte os três maiores riscos dessa abordagem e como você a corrigiria com o padrão Strangler Fig.
glossário técnico
- Bounded Context: Conceito do Domain-Driven Design que define a fronteira linguística e lógica explícita onde um determinado modelo de domínio se aplica e tem significado unívoco.
- Transação ACID: Conjunto de propriedades (Atomicidade, Consistência, Isolamento e Durabilidade) garantidas pelo banco de dados que asseguram que operações financeiras ou cadastrais sejam executadas com integridade absoluta.
- Saga Pattern: Mecanismo arquitetural para gerenciar transações de longa duração em sistemas distribuídos sem bloqueios globais, composto por transações locais e transações de compensação.
- Consistência Eventual: Modelo de consistência em sistemas distribuídos onde os nós podem divergir temporariamente, mas convergirão para o mesmo estado se nenhum novo update for enviado.
- Outbox Pattern: Padrão de integração que garante que uma alteração no banco e a publicação de um evento no broker de mensageria ocorram de forma atômica, salvando o evento na mesma transação local do banco antes do envio.
- Lei de Conway: Princípio publicado em 1968 que demonstra que a arquitetura dos sistemas de software reproduz fielmente as estruturas de comunicação das equipes que os constroem.
fontes consultadas
- Fowler, Martin. MonolithFirst. martinfowler.com, 2015. Consulta em 2026-11-03.
- Newman, Sam. Building Microservices: Designing Fine-Grained Systems. O’Reilly Media, 2ª edição, 2021.
- Evans, Eric. Domain-Driven Design: Tackling Complexity in the Heart of Software. Addison-Wesley, 2003.
- Foote, Brian; Yoder, Joseph. Big Ball of Mud. 4th Conference on Pattern Language of Programming, 1997.
- Conway, Melvin E. How Do Committees Invent?. Datamation, abril de 1968.
- Deutsch, Peter; Gosling, James. The Eight Fallacies of Distributed Computing. Sun Microsystems, 1994.