pprof em Go: perfil de CPU, memória e goroutines
Como coletar perfis de CPU, heap e goroutines com pprof em Go, ler o resultado com top e list e medir antes de mudar o código.
intermediárioPublicada em · 29 min de leitura
Imagine um restaurante em que o cliente reclama que o prato demora. O gerente, sem entrar na cozinha, manda trocar o fogão, contratar mais um cozinheiro e reorganizar as panelas. Duas semanas depois a reclamação continua, porque o atraso estava numa etapa que ninguém cronometrou: o forno do pão, que só aquecia de hora em hora. Profiling é o cronômetro colocado em cada estação da cozinha enquanto o serviço acontece, para descobrir onde o tempo (e o gás, e a paciência) realmente vai embora.
Em Go, a ferramenta se chama pprof. Ela vem com a toolchain (go tool pprof) e lê arquivos que o próprio runtime sabe produzir: quanto tempo de CPU cada função gastou, quanta memória foi alocada e de onde veio, quantas goroutines existem e onde estão paradas, e onde o programa ficou esperando por uma trava. Esta aula começa do zero, mostra três formas de coletar esses dados, ensina a ler o que volta e fecha com um exemplo em que o perfil aponta a linha exata que aloca demais.
Todos os comandos desta aula foram rodados em 3 de novembro de 2026, com Go 1.27.2, num Apple M1 Max de 10 núcleos e 32 GB de memória. A máquina estava com carga média entre 100 e 120 durante as medições, o que deixou os tempos de execução ruidosos. Por isso a aula confia mais nas contagens de alocação, que se repetiram quase iguais em todas as rodadas, do que nos nanossegundos.
O mapa da aula
| Parte | Seções | O que você vai aprender |
|---|---|---|
| 1. Fundamentos | 1 e 2 | O que é profiling e o que cada perfil do pprof mede |
| 2. Como coletar | 3 a 5 | go test -cpuprofile e -memprofile, net/http/pprof num servidor (com cuidado) e runtime/pprof num programa comum |
| 3. Como ler | 6 e 7 | top, list, peek e a visualização no navegador, e a diferença entre inuse_space e alloc_space |
| 4. Um exemplo que aloca demais | 8 e 9 | Um relatório montado com += e o perfil que aponta a linha culpada |
| 5. Fluxo de trabalho | 10 e 11 | Medir, achar, mudar, medir de novo, e os erros que mais atrapalham |
Pré-requisitos: Benchmarking e Profiling de Testes, porque o benchmark é a forma mais simples de gerar carga controlada, e Memory Leaks, porque boa parte da leitura de perfis de memória é separar o que continua vivo do que é lixo, e essa distinção depende de entender o que é vazamento.
Parte 1: fundamentos
1. O que é profiling, para o leigo
Profiling é medir um programa enquanto ele roda, sem alterar o código, para descobrir onde ele gasta um recurso. O recurso pode ser tempo de processador, memória, espera ou número de tarefas simultâneas. O nome vem de “perfil” no sentido de contorno: o profiler desenha um retrato aproximado de onde a execução passou mais tempo ou mais bytes.
Esse retrato é estatístico. O profiler não observa cada instrução. Ele interrompe o programa em intervalos regulares, olha a pilha de chamadas que estava ativa naquele instante e soma a contagem. Uma função que aparece em muitas amostras estava no caminho quente com frequência. Daí sai uma consequência prática que volta várias vezes nesta aula: um perfil curto tem poucas amostras, e poucas amostras dão um retrato borrado. Meio segundo de CPU, a cerca de 100 amostras por segundo, dá umas 50 fotos. Tomar decisão com isso é possível, mas só se o retrato for nítido o bastante, o que nem sempre acontece.
2. O que o pprof mede
O pprof não é uma ferramenta de uma coisa só. É um formato de arquivo e um visualizador, e o runtime de Go sabe gerar vários perfis predefinidos, cada um respondendo a uma pergunta diferente. Esta seção descreve cada um, e as seções seguintes mostram os que a aula usa de fato.
O perfil de CPU responde onde o tempo de processador foi gasto enquanto o programa executava. Tempo em que a goroutine dormia ou esperava I/O não entra nele. Segundo o artigo histórico do blog do Go, de 2011, o programa era interrompido cerca de 100 vezes por segundo para coletar uma amostra. Esse número vem de 2011, e a aula não o trata como constante do runtime atual.
O perfil de heap responde quanta memória está viva agora e de onde ela veio. A amostragem é por bytes: segundo a documentação de runtime.MemProfileRate, o runtime registra em média uma alocação a cada 512 KiB alocados, e esse é o valor padrão. Logo, os números de heap são estimativas, não contagens exatas, e um programa de vida curta pode nem ter alocações suficientes para aparecer bem.
O perfil de alocações (allocs) usa o mesmo mecanismo de amostragem, mas o índice padrão passa a ser o total alocado desde o início do processo, incluindo o que o coletor de lixo já devolveu. A diferença entre os dois é o assunto da seção 7, porque é ela que decide se você está olhando para lixo de vida curta ou para retenção de verdade.
O perfil de goroutines responde quantas existem agora e em qual pilha está cada uma. É o primeiro lugar para olhar quando um serviço cresce sem parar em número de goroutines, que costuma ser sintoma de vazamento, como explica Memory Leaks.
Os perfis de bloqueio (block) e de contenção de trava (mutex) respondem onde goroutines ficaram esperando por sincronização. O primeiro registra tempo parado em sync.Mutex, sync.WaitGroup, sync.Cond e operações de canal. O segundo registra disputa pela trava. Nenhum dos dois vem ligado por padrão: é preciso chamar runtime.SetBlockProfileRate ou runtime.SetMutexProfileFraction. Esta aula não exercita esses dois com programa próprio. Eles aparecem nos endpoints do servidor da seção 4, zerados, porque ninguém os ligou.
A toolchain local (Go 1.27.2) também lista um perfil goroutineleak, com as pilhas das goroutines vazadas. Esta aula não o usou, e a seção “O que não foi confirmado”, no fim, explica o motivo.
Parte 2: como coletar
Há três caminhos para gerar um perfil, e os três entregam o mesmo tipo de arquivo. A figura mostra os caminhos e o único que expõe uma porta. As seções 3 a 5 percorrem um de cada vez.
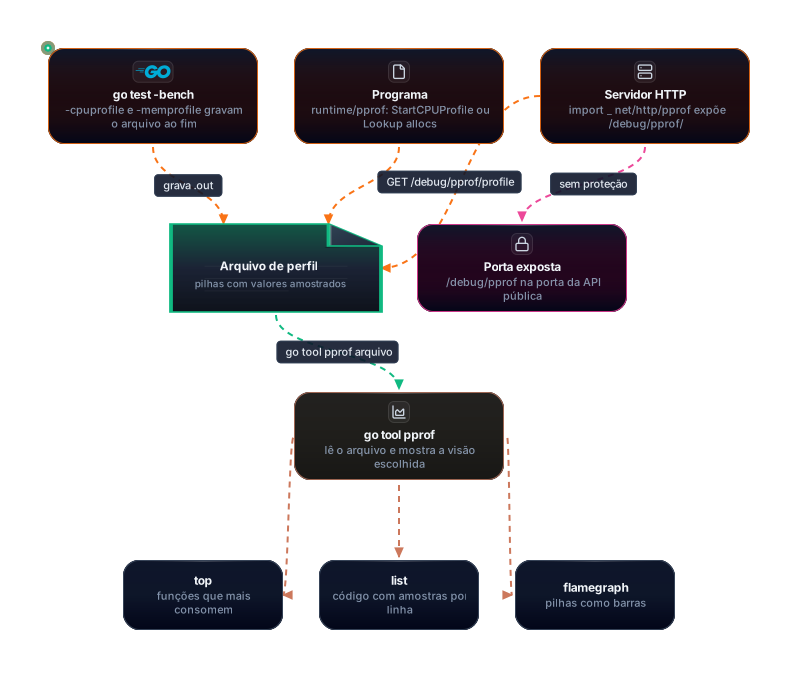
Pela esquerda entram o go test, o servidor com net/http/pprof e um programa com runtime/pprof. Os três param num arquivo de perfil, que o go tool pprof lê em qualquer das visões da seção 6. A seta rosa é o caminho que a seção 4 pede para não deixar aberto: o endpoint de diagnóstico na mesma porta que atende o público.
O exemplo de todas as seções seguintes é um pacote pequeno, relatorio, que monta um texto com duas funções. Ele está no módulo pproflab, e a função Naive é a que aloca demais:
package relatorio

import (
	"fmt"
	"strings"
)

// Naive monta o relatório com += dentro do laço. Cada += cria uma string
// nova e copia nela tudo o que já estava escrito antes.
func Naive(linhas []string) string {
	var s string
	for i, l := range linhas {
		s += fmt.Sprintf("%05d %s\n", i, l)
	}
	return s
}

// Otimizado reserva o espaço total de uma vez e escreve no mesmo buffer.
// Cada linha ocupa len(l) bytes, mais 5 dígitos, um espaço e a quebra de linha.
func Otimizado(linhas []string) string {
	total := 0
	for _, l := range linhas {
		total += len(l) + 7
	}
	var b strings.Builder
	b.Grow(total)
	for i, l := range linhas {
		fmt.Fprintf(&b, "%05d %s\n", i, l)
	}
	return b.String()
}
Os dois têm que devolver o mesmo texto, e um teste confirma isso antes de qualquer medição. Comparar a saída antes de medir a velocidade é a ordem certa, porque um atalho que muda o resultado não serve, por mais rápido que seja.
=== RUN   TestMesmaSaida
--- PASS: TestMesmaSaida (0.00s)
PASS
ok  	pproflab/relatorio	0.204s
3. Coletando com go test: -cpuprofile e -memprofile
O pacote testing já sabe gerar perfis. As flags que interessam, segundo go help testflag, são -cpuprofile, -memprofile, -blockprofile, -mutexprofile e -trace, todas gravando arquivos no diretório atual. O -memprofile grava o perfil de alocações (allocs), e não o de heap, por isso o índice padrão que você verá ao abrir o arquivo é alloc_space.
O benchmark do pacote é o que já está na aula de Benchmarking e Profiling de Testes, com o b.ReportAllocs() para ver as alocações por operação:
func BenchmarkNaive(b *testing.B) {
	entrada := entradaDeTeste(2000)
	b.ReportAllocs()
	b.ResetTimer()
	var s string
	for i := 0; i < b.N; i++ {
		s = Naive(entrada)
	}
	resultado = s
}
O comando abaixo roda só o BenchmarkNaive por três segundos e grava os dois perfis:
go test ./relatorio -run='^$' -bench=BenchmarkNaive -benchmem -benchtime=3s -count=1 \
  -cpuprofile cpu-naive.out -memprofile mem-naive.out
Saída real:
pkg: pproflab/relatorio
cpu: Apple M1 Max
BenchmarkNaive-10        	     202	  22136821 ns/op	32099737 B/op	    7786 allocs/op
PASS
ok  	pproflab/relatorio	6.707s
Repare em duas coisas. A primeira: o go test deixa o binário do teste no diretório (relatorio.test). Ele é necessário para o pprof associar endereços de memória a nomes de função, e apagá-lo antes de abrir o perfil estraga a leitura. A segunda: o -run='^$' desliga os testes normais, para que só o benchmark entre no perfil.
4. Coletando com net/http/pprof num servidor
Para um serviço que roda por horas, o caminho mais prático é importar o pacote net/http/pprof. A importação só com _ não faz nada visível, exceto registrar handlers de HTTP sob /debug/pprof/. O servidor do exemplo mostra o padrão:
import (
	"net/http"
	_ "net/http/pprof" // registra /debug/pprof/ no DefaultServeMux
)

func main() {
	http.HandleFunc("/relatorio", relatorioHandler)
	http.HandleFunc("/acumula", acumulaHandler)
	log.Fatal(http.ListenAndServe("127.0.0.1:6061", nil))
}
Os handlers do pprof vão para o DefaultServeMux, o mesmo que o http.HandleFunc usou acima. Esse detalhe é a origem do cuidado que a seção pede. O servidor foi iniciado em 127.0.0.1:6061 e o índice respondeu com a lista de perfis:
/debug/pprof/
Set debug=1 as a query parameter to export in legacy text format
Types of profiles available:
CountProfile
3allocs
0block
0cmdline
3goroutine
0goroutineleak
3heap
0mutex
0profile
0symbol
5threadcreate
0trace
Os números são a contagem de cada perfil no momento da consulta. Os zeros em block e mutex confirmam o que a seção 2 disse: sem SetBlockProfileRate, nada é registrado.
Para olhar o perfil de goroutines em texto, sem ferramenta alguma, basta curl no endpoint com debug=1. No momento da consulta havia três goroutines, e este é o começo da saída:
goroutine profile: total 3
1 @ 0x10480bf0c 0x10484b4a4 0x1049e31c4 0x1049e2e70 0x1049e06d4 0x1049f4e54 0x1049f5680 0x1049c5288 0x1049c6994 0x1049ccac0 0x1049c3c80 0x104853714
Os perfis ao vivo usam go tool pprof apontando para a URL do endpoint. O de heap, com gc=1, aparece completo na seção 7. O de CPU, com ?seconds=5, aparece na seção 11, onde o tamanho da amostra importa.
O cuidado: não exponha isso
A documentação oficial de diagnósticos (consultada em 3 de novembro de 2026) diz que é seguro perfilar programas em produção, mas avisa que alguns perfis, como o de CPU, custam desempenho, e que colher perfis ao mesmo tempo pode atrapalhar uns aos outros. Essa mesma página não traz nenhum alerta sobre expor os endpoints. O alerta de segurança desta seção é uma conclusão minha, não algo que a documentação diz.
O motivo é concreto. Os endpoints vivem no mesmo mux que as rotas da aplicação. Se a porta pública da API serve DefaultServeMux, qualquer pessoa que chegue até ela consegue baixar o perfil. Nesta mesma máquina, a consulta a /debug/pprof/cmdline devolveu o nome e os argumentos do processo (./servidor-bin), e um argumento com senha ou token na linha de comando sairia pela mesma porta. Os perfis também revelam nomes de funções e caminhos de arquivos, que ajudam quem está procurando uma falha.
O caminho seguro é separar o mux de diagnóstico e prendê-lo a uma interface que só a equipe alcança. O trecho abaixo segue a documentação local, que diz que, sem DefaultServeMux, é preciso registrar os handlers no mux que se usa. Ele não foi executado nesta aula; os nomes das funções são os que a documentação local lista.
mux := http.NewServeMux()
mux.HandleFunc("/debug/pprof/", pprof.Index)
mux.HandleFunc("/debug/pprof/cmdline", pprof.Cmdline)
mux.HandleFunc("/debug/pprof/profile", pprof.Profile)
mux.HandleFunc("/debug/pprof/symbol", pprof.Symbol)
mux.HandleFunc("/debug/pprof/trace", pprof.Trace)
go http.ListenAndServe("127.0.0.1:6060", mux)
Se o serviço precisa ser perfilado a partir de outra máquina, a porta de diagnóstico deve ficar numa rede privada, atrás de autenticação, e não na mesma porta da API. Com o mux separado, a API pública continua sem nenhuma rota de diagnóstico.
5. Coletando com runtime/pprof num programa comum
Nem todo programa é um servidor, e nem sempre é prático abrir uma porta para medir uma ferramenta de linha de comando. Para esses casos, o pacote runtime/pprof escreve os arquivos direto no disco. O programa abaixo tem duas flags, uma para CPU e outra para alocações, e roda o mesmo Naive trezentas vezes:
var cpuprofile = flag.String("cpuprofile", "", "escreve o perfil de CPU neste arquivo")
var memprofile = flag.String("memprofile", "", "escreve o perfil de alocações neste arquivo")

func main() {
	flag.Parse()

	if *cpuprofile != "" {
		f, err := os.Create(*cpuprofile)
		if err != nil {
			log.Fatal("não consegui criar o arquivo de CPU: ", err)
		}
		defer f.Close()
		if err := pprof.StartCPUProfile(f); err != nil {
			log.Fatal("não consegui iniciar o perfil de CPU: ", err)
		}
		defer pprof.StopCPUProfile()
	}

	// ... carga de trabalho ...

	if *memprofile != "" {
		f, err := os.Create(*memprofile)
		if err != nil {
			log.Fatal("não consegui criar o arquivo de memória: ", err)
		}
		defer f.Close()
		runtime.GC()
		if err := pprof.Lookup("allocs").WriteTo(f, 0); err != nil {
			log.Fatal("não consegui escrever o perfil de memória: ", err)
		}
	}
}
A CPU usa StartCPUProfile e StopCPUProfile, porque ela é gravada em fluxo enquanto o programa roda. A memória é um instantâneo, escrito de uma vez. A chamada a runtime.GC() antes dela, segundo a documentação, serve para ter estatísticas atualizadas. Os defer executam em ordem inversa: o StopCPUProfile roda antes do f.Close(), e isso é o que se quer.
Saída real da execução:
2026/11/03 07:18:57 bytes gerados: 6600000Ao abrir o perfil de alocações, o resultado mostra o mesmo padrão do benchmark:
Type: alloc_space
Showing nodes accounting for 6.46GB, 99.79% of 6.48GB total
      flat  flat%   sum%        cum   cum%
     6.46GB 99.79% 99.79%     6.47GB   100%  pproflab/relatorio.Naive
Parte 3: como ler
6. go tool pprof: top, list, peek e a visualização
Abrir um perfil sem outras flags entra no modo interativo, com a prompt (pprof). Os comandos que valem a pena conhecer, segundo a própria ajuda do help interativo, são estes:
    list             Output annotated source for functions matching regexp
    peek             Output callers/callees of functions matching regexp
    top              Outputs top entries in text form
    traces           Outputs all profile samples in text form
    tree             Outputs a text rendering of call graph
    web              Visualize graph through web browser
    weblist          Display annotated source in a web browser
    sample_index     Sample value to report (0-based index or name)
Para scripts e para a aula, o modo não interativo costuma ser mais útil, porque a saída vai para o terminal e pode ser colada. O top lista as funções com mais amostras. Há duas colunas que confundem quem começa. flat é o valor gasto na própria função, sem contar as que ela chama. cum é o valor acumulado, incluindo tudo o que ela chama. Uma função com cum alto e flat baixo funciona sobretudo como intermediária: o custo está, em boa parte, nas funções para as quais ela delega.
go tool pprof -top cpu-naive.outFile: relatorio.test
Type: cpu
Duration: 6.42s, Total samples = 3.07s (47.81%)
Showing nodes accounting for 2.87s, 93.49% of 3.07s total
flat flat% sum% cum cum%
0.66s 21.50% 21.50% 0.66s 21.50% runtime.madvise
0.42s 13.68% 35.18% 0.42s 13.68% runtime.pthread_cond_wait
0.38s 12.38% 47.56% 0.38s 12.38% runtime.usleep
0.28s 9.12% 56.68% 0.28s 9.12% runtime.pthread_cond_signal
0.21s 6.84% 63.52% 0.21s 6.84% runtime.pthread_kill
0.20s 6.51% 70.03% 0.20s 6.51% runtime.memmoveEsse topo é o primeiro sinal de armadilha, e a seção 9 volta a ele. A função de negócio Naive não aparece entre as primeiras linhas, e quase todo o tempo caiu em funções do runtime. A linha Total samples = 3.07s (47.81%) também diz algo: só metade da duração do benchmark virou amostra de CPU. Isso é compatível com um processo que passou boa parte do tempo esperando CPU numa máquina com essa carga, mas a aula não mediu essa causa. Esse é o tipo de detalhe que o cabeçalho do perfil entrega e que muita gente ignora.
Para saber quem chama uma função do runtime, use peek. No mesmo perfil, a chamada da madvise vem de sysUsedOS:
go tool pprof -peek 'runtime.madvise' cpu-naive.out 0.59s 89.39% | runtime.sysUsedOS
0.07s 10.61% | runtime.sysUnusedOS
0.66s 21.50% 21.50% 0.66s 21.50% | runtime.madviseO list mostra o código-fonte da função, com o valor de cada linha ao lado. É a ferramenta que transforma um nome de função numa linha para editar. Ele aparece na seção 9, com o perfil de alocações.
A visualização no navegador usa -http. Ele sobe um servidor local e mostra a visão de grafo, o flame graph e o top:
go tool pprof -http=127.0.0.1:8080 mem-naive.outNesta máquina, a visão de grafo não funcionou. A aba do grafo depende do Graphviz (o programa dot), que não está instalado aqui. A saída do servidor foi esta:
Serving web UI on http://127.0.0.1:8099
Failed to execute dot. Is Graphviz installed?
exec: "dot": executable file not found in $PATH
Consultando as rotas do servidor, o flame graph e o top responderam HTTP 200, e o grafo respondeu 501. Para usar o comando web, que abre o grafo no navegador, é preciso instalar o Graphviz antes. As rotas que não dependem dele funcionam sem isso. Quem tiver o dot instalado deve conferir a visão de grafo por conta própria, porque a aula não a viu renderizada.
7. inuse_space e alloc_space
Este é o ponto que mais confunde quem começa com memória em Go. O mesmo perfil de heap responde a duas perguntas, e cada uma tem um índice próprio. inuse_space soma os bytes dos objetos que estão vivos no instante da coleta. alloc_space soma todos os bytes alocados desde o início do processo, vivos ou não. Um objeto que foi alocado, usado e descartado conta em alloc_space e some de inuse_space.
Para ver a diferença, o servidor da seção 4 tem dois endpoints com comportamentos opostos. /relatorio monta um texto de 2000 linhas com Naive e devolve, e o resultado é lixo de vida curta. /acumula guarda um bloco de 64 KiB numa variável global a cada chamada, e isso é retenção.
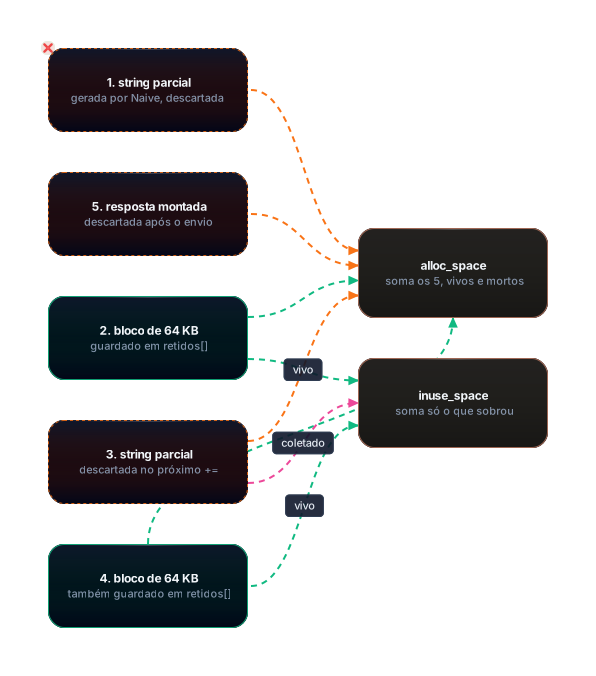
A figura mostra o mesmo conjunto de alocações sob as duas perguntas. Os cinco blocos entram em alloc_space. Só os dois blocos retidos, em verde, entram em inuse_space. A seta bloqueada mostra uma string descartada que tenta entrar no índice de vivos e é barrada, porque a coleta já a devolveu.
Foram feitas 200 chamadas a /acumula, e a consulta de conferência que veio depois também reteve um bloco, por isso são 201 blocos vivos. Depois foram feitas 300 chamadas a /relatorio, e o heap foi consultado com coleta forçada (gc=1, que segundo a documentação faz o runtime rodar uma coleta antes de gerar o perfil):
go tool pprof -top -sample_index=inuse_space 'http://127.0.0.1:6061/debug/pprof/heap?gc=1'Type: inuse_space
Showing nodes accounting for 14097.23kB, 100% of 14097.23kB total
flat flat% sum% cum cum%
13072kB 92.73% 92.73% 13072kB 92.73% main.acumulaHandler
1025.23kB 7.27% 100% 1025.23kB 7.27% runtime.mallocgcQuase todo o heap vivo está em acumulaHandler. Já o índice de alocação, sobre o mesmo servidor, conta a história inteira:
go tool pprof -top -sample_index=alloc_space 'http://127.0.0.1:6061/debug/pprof/heap?gc=1'Type: alloc_space
Showing nodes accounting for 9.01GB, 99.45% of 9.06GB total
flat flat% sum% cum cum%
9.01GB 99.45% 99.45% 9.02GB 99.56% pproflab/relatorio.Naive
0 0% 99.45% 9.04GB 99.75% main.relatorioHandlerAqui o Naive domina. Ele alocou quase 9 GB ao longo das chamadas, mas nada disso ficou vivo. Os dois índices, lidos juntos, dizem o que cada função faz com a memória: Naive produz muito lixo e não retém nada, acumulaHandler retém pouco lixo e muito dado vivo. Um vazamento de verdade aparece no inuse_space crescendo entre duas coletas. Um problema de custo de alocação aparece no alloc_space.
Duas ressalvas sobre esses números. Primeiro, eles são estimativas da amostragem. Os 201 blocos de 64 KiB somam 12.864 KiB, e o perfil mostra 13.072 kB. A diferença de cerca de 1,6% não foi investigada nesta aula, e é o tipo de erro que a amostragem produz. Segundo, o heap é o instantâneo da última coleta concluída. Sem gc=1, o perfil pode mostrar objetos que a próxima coleta já devolveria.
Parte 4: um exemplo que aloca demais
8. O código e a medida
A função Naive monta o texto com += dentro de um laço. Em Go, strings são imutáveis: cada += cria uma string nova e copia nela tudo o que já estava lá. Com 2000 linhas, a cópia do prefixo é repetida 2000 vezes, e o custo total cresce mais rápido do que o tamanho da saída. A versão Otimizado calcula o tamanho total antes, reserva o espaço com strings.Builder.Grow e escreve uma vez.
O benchmark mediu as duas. A primeira rodada, com -benchtime=2s e os perfis ligados, deu:
goos: darwin
goarch: arm64
pkg: pproflab/relatorio
cpu: Apple M1 Max
BenchmarkNaive-10        	     100	  29423654 ns/op	32103159 B/op	    7795 allocs/op
BenchmarkOtimizado-10    	   10000	    356222 ns/op	   78808 B/op	    3746 allocs/op
PASS
ok  	pproflab/relatorio	6.914s
Três rodadas seguidas com -benchtime=1s e uma quarta, depois, com -benchtime=2s e -memprofile, mostram a faixa:
| Rodada (hora, carga média de 1 minuto) | Naive ns/op | Naive B/op | Naive allocs/op | Otimizado ns/op | Otimizado B/op | Otimizado allocs/op |
|---|---|---|---|---|---|---|
| 07:18:13, carga 114 | 11.449.468 | 32.102.291 | 7.791 | 350.597 | 78.787 | 3.746 |
| 07:18:18, carga 108 | 8.016.882 | 32.103.006 | 7.792 | 401.129 | 78.788 | 3.746 |
| 07:18:22, carga 105 | 22.581.553 | 32.102.937 | 7.793 | 392.626 | 78.787 | 3.746 |
| 07:28 (quarta, sem leitura de carga) | 8.333.376 | 32.103.513 | 7.793 | 662.412 | 78.789 | 3.746 |
O tempo do Naive variou de 8 a 22 milissegundos por operação, e o do Otimizado ficou entre 350 e 660 microssegundos. A diferença é grande em qualquer rodada, mas a faixa é larga demais para dar um número cravado. As alocações são o dado estável: 7.791 a 7.795 alocações e cerca de 32 MB por operação no Naive, contra 3.746 alocações e 78 KB no Otimizado. Na prática, as contagens de bytes e de alocações saíram quase idênticas entre rodadas com cargas bem diferentes, enquanto o relógio variou bastante.
Repare que o Otimizado ainda faz 3.746 alocações. A seção 10 usa essa sobra como o próximo alvo.
9. O perfil que mostra a causa
Com o perfil de alocações do Naive isolado, o topo do alloc_space é uma única função:
go tool pprof -top -sample_index=alloc_space mem-naive.outType: alloc_space
Showing nodes accounting for 8.90GB, 99.82% of 8.91GB total
flat flat% sum% cum cum%
8.90GB 99.82% 99.82% 8.91GB 99.94% pproflab/relatorio.Naive
0 0% 99.82% 8.91GB 99.94% pproflab/relatorio.BenchmarkNaiveO list aponta a linha. Este é o resultado do perfil combinado dos dois benchmarks, gerado numa rodada posterior, e por isso os valores absolutos são outros. Os números que importam são as proporções:
go tool pprof -list 'relatorio.Naive' mem.outTotal: 15.57GB
ROUTINE ======================== pproflab/relatorio.Naive in .../relatorio/relatorio.go
14.93GB 14.96GB (flat, cum) 96.06% of Total
. . 10:func Naive(linhas []string) string {
. . 11: var s string
. . 12: for i, l := range linhas {
14.93GB 14.96GB 13: s += fmt.Sprintf("%05d %s\n", i, l)
. . 14: }
. . 15: return s
. . 16:}A linha 13 responde por 96% de tudo o que foi alocado. O caminho quente é esse +=, e ninguém precisou adivinhar nada. O mesmo list, aplicado ao Otimizado, mostra onde ficou a sobra:
go tool pprof -list 'relatorio.Otimizado' mem.outTotal: 15.57GB
ROUTINE ======================== pproflab/relatorio.Otimizado in .../relatorio/relatorio.go
353.01MB 624.83MB (flat, cum) 3.92% of Total
. . 20:func Otimizado(linhas []string) string {
. . 21: total := 0
. . 22: for _, l := range linhas {
. . 23: total += len(l) + 7
. . 24: }
. . 25: var b strings.Builder
. 271.82MB 26: b.Grow(total)
. . 27: for i, l := range linhas {
353.01MB 353.01MB 28: fmt.Fprintf(&b, "%05d %s\n", i, l)
. . 29: }
. . 30: return b.String()
. . 31:}Agora a sobra do Otimizado está numa linha só: o fmt.Fprintf do laço. A função Otimizado representa 3,9% do total do perfil combinado, contra 96% do Naive. A aula não mediu por que o Fprintf aloca. Uma hipótese plausível é que os argumentos passados ao formatador sejam convertidos para interface e aloquem, mas isso não foi verificado aqui, e o perfil mostra apenas onde a alocação acontece.
O perfil de CPU, por outro lado, não apontou a linha. Ele apontou o runtime. A leitura que a aula adota é esta: quando o programa aloca muito, o custo aparece em funções de gerenciamento de memória, como madvise e as rotinas do coletor, e o perfil de CPU mostra o efeito, não a origem. Por isso o perfil de alocação é a primeira pergunta quando o topo de CPU cai no runtime. Essa leitura é uma interpretação dos perfis que vimos, e não uma medição de causa e efeito.
Pergunta de entrevistaQual a diferença entre inuse_space e alloc_space no perfil de heap do pprof?
No perfil de heap, inuse_space soma os bytes dos objetos que estão vivos no instante da coleta, e alloc_space soma tudo o que foi alocado desde o início do processo, vivo ou não. Um objeto alocado, usado e descartado aparece só em alloc_space. Uso inuse_space para investigar retenção e vazamento, e alloc_space para achar quem gera pressão de alocação sobre o coletor. Na aula, o endpoint que guardava blocos numa variável global dominava o inuse_space, enquanto a função de relatório com concatenação dominava o alloc_space, mesmo sem reter nada. Se eu escolher o índice errado, acabo otimizando o lugar errado.
Parte 5: o fluxo de trabalho
10. Medir, achar, mudar, medir de novo
Um perfil não serve para nada se não entrar num ciclo. A figura abaixo mostra o fluxo que esta aula seguiu.
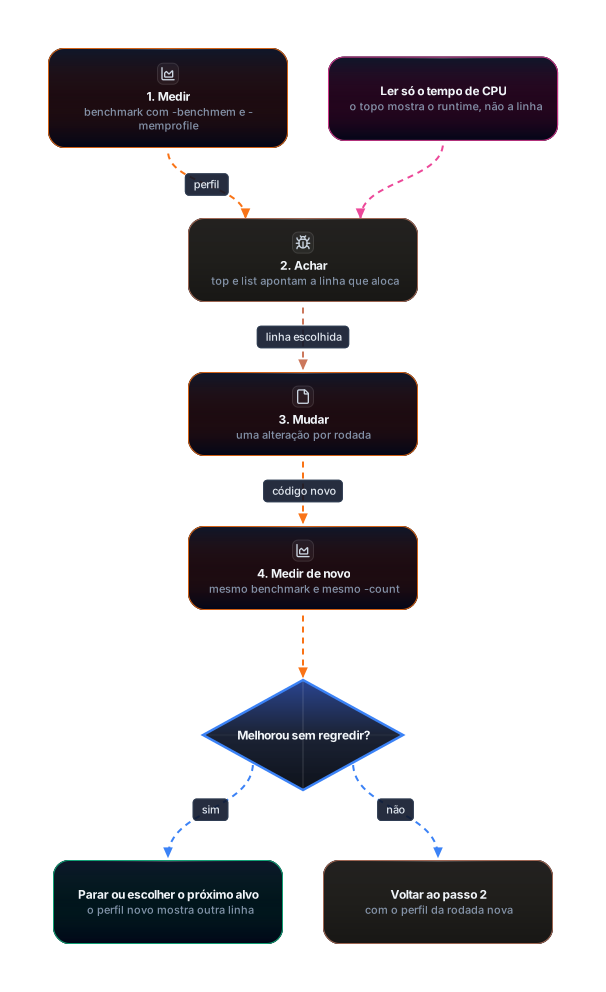
O primeiro passo é medir com um benchmark que reproduza o caso real, com -benchmem para ter as alocações. O segundo é achar, com top para a função e list para a linha. O terceiro é mudar uma coisa só. O quarto é medir de novo, com o mesmo benchmark e o mesmo -count. A decisão no fim é simples: se o resultado melhorou sem regredir em outro lugar, o perfil novo mostra o próximo alvo, e o ciclo recomeça; se não, a mudança sai.
No exemplo, a primeira medição do Naive deu 7.795 alocações por operação e 32 MB. Depois da troca da concatenação pelo Builder pré-dimensionado, o Otimizado caiu para 3.746 alocações e 78 KB. O perfil dessa versão, relido com list, mostrou a sobra no fmt.Fprintf. Uma próxima rodada começaria por ele.
Esta aula não rodou o benchstat, que compara amostras com teste estatístico. A recomendação da aula de Benchmarking e Profiling de Testes para comparar duas versões continua valendo, e ela pede rodadas repetidas com -count maior que 1, que não foram feitas nesta aula.
11. Erros comuns e como evitá-los
Otimizar sem perfil é um dos erros mais caros e mais comuns. A sensação de que “isto deve ser lento” é barata de ter e cara de pagar: o código muda, fica menos legível, e o gargalo continua no mesmo lugar, porque ele estava numa função que ninguém olhou. Antes de mexer, o perfil diz onde está o tempo.
Ler só o tempo de CPU é a armadilha que a seção 9 mostrou de perto. O topo de CPU de um programa que aloca demais tende a cair em funções do runtime, e quem para aí procura a culpa nos lugares errados. Quando o topo de CPU aponta o runtime, a pergunta seguinte costuma ser quem está alocando, e a resposta vem do perfil de alocações.
Decidir com poucas amostras também confunde. Um perfil de meio segundo, com poucas dezenas de amostras, pode mostrar uma função que nunca foi o gargalo. O perfil de CPU do servidor desta aula foi um bom exemplo disso: em cinco segundos, com carga dada por um laço de curl, o perfil acumulou só 170 milissegundos de amostras. Um perfil assim não sustenta nenhuma conclusão, e o certo é gerar carga mais forte e por mais tempo.
Confundir inuse_space com alloc_space leva a dois diagnósticos errados. Quem olha só o total alocado acha que há vazamento onde há lixo de vida curta. Quem olha só o vivo acha que tudo está bem onde há muita pressão no coletor. Para decidir se o problema é retenção ou custo de alocação, olhe os dois índices no mesmo perfil.
Medir uma vez e acreditar no número é outro erro clássico. Um benchmark com a máquina sobrecarregada, como as rodadas desta aula, varia de 8 a 22 milissegundos por operação. Sem repetir e sem registrar a carga, a comparação é de sorte.
Esquecer o gc=1 no heap também engana. Sem a coleta forçada, o perfil reflete a última coleta concluída, e a memória que o programa acabou de liberar pode aparecer como viva.
Expor /debug/pprof na porta pública é o erro de segurança que a seção 4 descreveu. Nenhum teste o acusa, e ele costuma ser descoberto tarde, quando alguém de fora baixa um perfil.
Ligar runtime.MemProfileRate em 1, para registrar todas as alocações, tira a amostragem e fica caro. A documentação da flag -memprofilerate diz que esse modo gera perfis mais precisos e mais caros. Use-o em uma investigação pontual, não como padrão.
Algumas boas práticas saem desses erros. Meça com um benchmark que reproduza o caso e com -benchmem. Compare os dois índices de heap antes de concluir. Registre a carga da máquina junto com o número. Mantenha o diagnóstico separado da porta pública. E trate cada perfil como uma amostra, que serve para escolher o próximo alvo e não para fechar o assunto.
Pergunta de entrevistaComo você otimiza um trecho que aloca demais usando pprof?
Sigo um ciclo: medir, achar, mudar e medir de novo. Começo com um benchmark que reproduz o caso real e uso -benchmem para ver as alocações. Uso top para achar a função e list para achar a linha. Mudo uma coisa só e meço de novo com o mesmo benchmark e o mesmo -count, para saber se melhorou sem regredir em outro lugar. Na aula, trocar a concatenação por um Builder pré-dimensionado reduziu as alocações por operação de 7.795 para 3.746, e o perfil novo apontou o fmt.Fprintf como próximo alvo. Para comparar versões com rigor, eu rodaria várias rodadas e usaria benchstat. Otimizar sem medir antes costuma atacar o lugar errado.
Parte 6: prática
Exercícios
-
Rode
go test ./relatorio -run='^$' -bench=BenchmarkOtimizado -benchmem -memprofile mem-otim.oute abra o perfil com-listna funçãoOtimizado. Qual linha domina a alocação?Resposta de referência: a linha 28, o
fmt.Fprintfdentro do laço, com cerca de 353 MB de 15,57 GB do perfil combinado. A aula não mediu a causa dessa alocação; a hipótese de conversão para interface é uma pista para investigar, não uma conclusão. -
Troque o
fmt.Fprintfporstrconv.AppendInteappendsobre um[]bytepré-dimensionado, sem mudar a saída. Antes de medir, rodeTestMesmaSaida. Depois compareallocs/opcom o benchmark deOtimizadoanterior, usando-count=5.Resposta de referência: o teste precisa passar antes de qualquer número. O
allocs/opdeve cair em relação às 3.746 alocações atuais. Se não cair, o perfil de alocações deve ser relido, porque a nova versão pode ter deslocado a alocação para outra linha. O número exato não é conhecido aqui; a aula não o mediu. -
Um serviço tem o
inuse_spacedo heap crescendo entre duas coletas forçadas, e oalloc_spacetambém cresce. Diga qual dos dois índices sustenta a suspeita de vazamento e o que você olharia depois.Resposta de referência: o
inuse_spaceé o que sustenta a suspeita, porque mede o que continua vivo após a coleta. Oalloc_spacecrescer sozinho não prova vazamento, porque o programa pode só estar alocando muito. Depois, olhe otopdoinuse_spacepara achar quem retém o dado, comoacumulaHandlerna seção 7, e confira comlista linha que guarda a referência.
O que não foi confirmado
- A visão de grafo (
webe a aba de grafo do-http) não foi vista renderizada. O Graphviz não está instalado nesta máquina, e a rota/ui/graphrespondeu 501. O flame graph e otopresponderam HTTP 200, mas o conteúdo visual não foi conferido. - O
benchstatnão foi rodado. Não há comparação estatística entre as versões nesta aula. - Os tempos absolutos ficaram ruidosos, com carga média entre 100 e 120. Só as contagens de alocação são usadas como conclusão.
- Os perfis de bloqueio e de contenção de trava não foram exercitados com programa próprio. O que a aula diz sobre eles vem da documentação.
- O perfil
goroutineleakaparece na toolchain local e no índice do servidor. Não verifiquei se ainda é experimental nem em que versão ele foi introduzido. - A diferença de cerca de 2% entre o heap estimado (13.072 kB) e o valor exato de 200 blocos de 64 KiB não foi investigada.
- A explicação de por que
fmt.Fprintfaloca não foi medida. Apenas a localização da alocação foi. - Não testei a exposição de
/debug/pprofem rede real. Demonstrei que o mesmo mux serve as rotas da aplicação e ocmdline, e o restante é análise. - A aula foi escrita e medida com Go 1.27.2 em darwin/arm64. Versões anteriores podem ter diferenças nos perfis e no formato da saída.
Glossário
- Profiling: medição de um programa em execução para descobrir onde ele gasta um recurso.
- Amostragem: coleta de fotos periódicas da pilha de chamadas, em vez de observar cada instrução.
- Perfil: arquivo com as amostras agregadas por pilha, lido pelo
go tool pprof. - Heap: região de memória onde ficam os objetos que sobrevivem ao escopo que os criou, e que o coletor de lixo administra.
- Alocação: criação de um objeto ou de um bloco de memória. Em
alloc_space, conta-se o total desde o início. inuse_space: bytes dos objetos vivos no instante da última coleta concluída.flat: valor gasto na própria função, sem contar o que ela chama.cum: valor acumulado, incluindo o que a função chama.DefaultServeMux: o roteador HTTP global da biblioteca padrão, que onet/http/pprofusa quando é importado só com_.- Goroutine: unidade de execução concorrente de Go, gerenciada pelo runtime, e não pelo sistema operacional. Ver Goroutine.
- Coletor de lixo (GC): rotina do runtime que libera objetos sem referências. Ver Garbage Collector.
- Graphviz: programa externo que desenha grafos, exigido pela visão de grafo do pprof.
Fontes (consultadas em 3 de novembro de 2026)
- Documentação local da toolchain Go 1.27.2 (
go doc net/http/pprof,go doc runtime/pprof,go doc runtime.MemProfileRate,go help testflagego tool pprof -help), consultada no Mac da aula em 3 de novembro de 2026. Essa é a fonte usada para as afirmações sobre flags, índices e endpoints. - Go Team. Go Diagnostics. Página consultada em 3 de novembro de 2026, usada para a classificação dos perfis, para a afirmação de que o profiling em produção é seguro com custo, e para o exemplo de mux personalizado. A página não traz alerta de segurança sobre os endpoints.
- Russ Cox, com atualização de Shenghou Ma. Profiling Go Programs. Artigo de 24 de junho de 2011, com atualização de maio de 2013, consultado em 3 de novembro de 2026. Usado para a frequência histórica de amostragem da CPU e para a descrição da visão de grafo. O texto é antigo, e a aula não o trata como referência atual para a frequência.
Relacionados
- Benchmarking e Profiling de Testes, pré-requisito para medir com
testing.Be gerar os primeiros perfis. - Memory Leaks, pré-requisito para entender o que o perfil de heap pode e não pode provar.
- Garbage Collector, para entender por que a alocação aparece no custo de CPU.
- Heap e Ponteiros, Memória e Escape Analysis, para a origem das alocações que o perfil mostra.
- Goroutine, para o perfil de goroutines e de bloqueio.
- Trilha de Go, com a posição desta aula na ordem da trilha.