SQLX em Go: mapeamento, named queries e transações
Como o sqlx preenche structs pela tag db, usa consultas com parâmetros nomeados e sqlx.In, e fecha transações com defer tx.Rollback, testado em SQLite.
intermediárioPublicada em · 26 min de leitura
Imagine a recepção de um consultório. Cada paciente chega com uma ficha, e a secretária copia os campos para o prontuário. Ela pode trabalhar de dois jeitos: contar os campos pela posição (“o terceiro item vai para o terceiro quadrado”) ou ler o nome escrito em cada campo e procurar o quadrado com esse mesmo nome. O primeiro jeito quebra quando alguém acrescenta um campo na ficha. O segundo aguenta a mudança sem reclamar. O database/sql puro funciona como o primeiro jeito, e o sqlx é o segundo.
Esta é a aula 6.6 da trilha de Go, na fase de bancos de dados e persistência. Ela vem depois de database/sql, pgx, sqlc e GORM, e antes das migrations. Os pré-requisitos são database-sql e Connection Pooling, que explica o pool e as transações no nível do driver, e PostgreSQL com pgx, que mostra o driver mais usado com PostgreSQL. Se você já sabe o que é um *sql.DB e o que faz o Scan, pode pular para a seção 3.
Mapa da aula
| Parte | Seções | O que você vai dominar |
|---|---|---|
| Problema e instalação | 1 e 2 | Por que o Scan manual cansa, e a versão da biblioteca usada aqui |
| Mapeamento | 3, 4 e 5 | Tags db, Get, Select, StructScan e consultas com :nome |
| Listas e transações | 6 e 7 | sqlx.In, Rebind, Beginx, Commit e Rollback com defer |
| Exemplo rodado | 8 | Programa completo em SQLite em memória, com a saída real |
| Segurança e decisão | 9, 10 e 11 | de SQL, quando usar sqlx, sqlc ou pgx puro, erros comuns |
| Prática e referências | 12 a 16 | Exercícios com resposta, o que não foi confirmado, glossário, fontes e relacionados |
1. O problema que o sqlx resolve
Para entender o sqlx, primeiro é preciso ver a dor que ele alivia. Com database/sql puro, uma consulta que devolve linhas exige que você leia cada coluna e entregue um ponteiro para cada campo, na ordem exata em que as colunas aparecem no SELECT:
// Versão com database/sql puro, para comparar
func listarPuro(db *sql.DB) ([]P, error) {
	rows, err := db.Query("SELECT id, nome FROM p ORDER BY id")
	if err != nil {
		return nil, err
	}
	defer rows.Close()
	var ps []P
	for rows.Next() {
		var p P
		if err := rows.Scan(&p.ID, &p.Nome); err != nil {
			return nil, err
		}
		ps = append(ps, p)
	}
	return ps, rows.Err()
}
Repare em três coisas. O rows.Scan recebe os ponteiros na mesma ordem do SELECT, então, se alguém trocar a ordem das colunas na consulta e esquecer o Scan, os valores vão parar no campo errado sem erro algum quando os tipos forem compatíveis. Acrescentar uma coluna ao SELECT sem acrescentar o ponteiro correspondente também quebra o código, mas o aviso só aparece quando a consulta roda. E cada struct novo pede mais uma função dessas. Escrever Scan à mão é um trabalho que ninguém cita no currículo e que quase todo mundo faz.
O sqlx não substitui o database/sql. Segundo o README do projeto, os tipos dele envolvem os originais sem alterar as interfaces. Na prática, sqlx.Open devolve um *sqlx.DB que guarda um *sql.DB no campo DB, e é por isso que a função de comparação acima recebe db.DB na chamada. Dá para adotar o sqlx em um projeto existente trocando função por função.
O que ele acrescenta, em resumo, aparece na tabela abaixo. Cada linha é explicada na seção indicada.
| Recurso | O que faz | Seção |
|---|---|---|
Get | Traz uma linha e preenche um struct (ou um valor simples) | 4 |
Select | Traz várias linhas e preenche um slice | 4 e 6 |
NamedExec e NamedQuery | Usam parâmetros com nome, tirados de um struct ou de um map | 5 |
StructScan | Preenche um struct a partir da linha atual de um Rows | 5 |
sqlx.In e Rebind | Expandem listas em vários ? e convertem o marcador para o formato do driver | 6 |
Beginx e BeginTxx | Abrem uma que devolve um *sqlx.Tx | 7 |
2. Versão e instalação
A versão atual da biblioteca é a v1.4.0. Consultei em 2026-11-03 o endereço @latest do proxy de módulos do Go, que devolve a v1.4.0, e a página de releases do GitHub mostra a mesma versão marcada como “Latest”. As referências de API usadas nas seções seguintes vêm do código do módulo v1.4.0, lido com go doc. O README também diz que o projeto garante compatibilidade só com as duas versões mais recentes do Go, então confira isso antes de fixar a toolchain do seu projeto.
go get github.com/jmoiron/sqlx@v1.4.0
go get modernc.org/sqlite@v1.61.1
O exemplo desta aula roda em SQLite em memória, com o driver modernc.org/sqlite. Ele é escrito em Go puro, então não exige cgo nem compilador C, e se registra com o nome "sqlite". Para PostgreSQL, o caminho comum seria o driver github.com/jackc/pgx/v5/stdlib. Não subi um servidor de PostgreSQL para esta aula, então os trechos que falam de PostgreSQL são explicações e não rodaram.
3. Mapeamento de struct pela
O sqlx descobre quais campos do struct recebem quais colunas lendo a tag db. A tag é o texto entre crases depois do tipo do campo. O struct usado no exemplo é este:
type Produto struct {
	ID        int    `db:"id"`
	Nome      string `db:"nome"`
	Categoria string `db:"categoria"`
	Estoque   int    `db:"estoque"`
}
Quando um campo não tem tag, o sqlx usa o nome do campo em minúsculas, porque o NameMapper padrão é strings.ToLower, conforme a documentação do pacote. Por isso Nome string sem tag casaria com uma coluna nome. A tag só se torna necessária quando o nome da coluna e o do campo não coincidem, como tutor_id e TutorID, ou quando você quer deixar explícito o contrato entre o banco e o código. Eu prefiro sempre escrever a tag: quem lê o struct dez meses depois não precisa adivinhar o nome da coluna.
A descoberta do mapa de campos é feita por reflexão. O código do sqlx guarda o resultado num cache indexado pelo tipo, então o trabalho de olhar as tags acontece uma vez por tipo, e não a cada linha lida. Isso explica por que o sqlx é bem mais leve do que parece à primeira vista: ele não reconstrói o mapa a cada consulta.
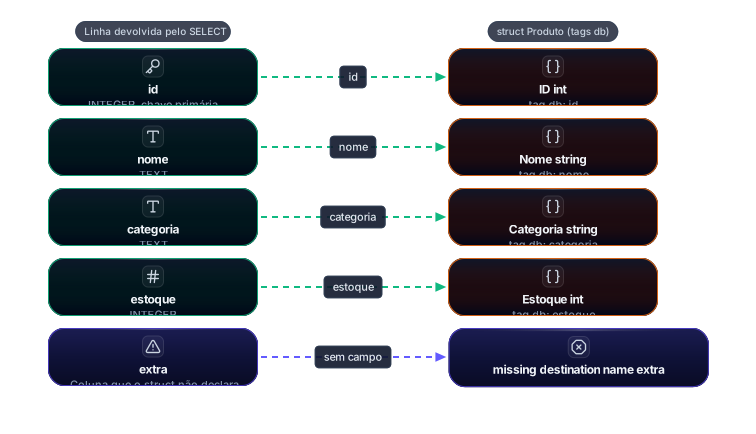
A figura mostra o caminho de uma linha. As colunas do SELECT à esquerda são casadas com os campos do struct à direita pelo nome da tag, e a coluna extra não tem campo correspondente. Quando isso acontece, o banco já devolveu a linha, e o sqlx recusa o mapeamento com um erro que diz qual coluna sobrou. No teste que rodei, o erro foi missing destination name extra in *[]main.P.
Existe uma saída para esse erro: Unsafe(), que faz o Select ignorar colunas sem campo. No teste, a consulta passou e o primeiro produto veio com o campo Nome vazio. Essa opção parece confortável, mas ela desliga justamente o aviso que você mais precisa ver cedo. Ligue-a só quando a consulta trouxer colunas auxiliares de propósito, e deixe um comentário dizendo por quê. O aviso do sqlx é como a luz do painel do carro: ignorá-la não faz o problema sumir.
4. Get e Select
Get traz uma linha. A função abaixo usa o GetContext, que é a versão com contexto, e preenche um struct:
// Get: uma linha só, preenchida em um struct.
func buscarProduto(ctx context.Context, db *sqlx.DB, id int) (Produto, error) {
	var p Produto
	err := db.GetContext(ctx, &p,
		"SELECT id, nome, categoria, estoque FROM produtos WHERE id = ?", id)
	return p, err
}
Se a consulta achar a linha, o struct volta preenchido. Se não achar, o Get devolve sql.ErrNoRows, a mesma sentinela usada pelo Row.Scan do database/sql. Por isso o teste correto é errors.Is(err, sql.ErrNoRows), que separa “esse registro não existe” de “o banco caiu”. Confundir os dois é um erro comum, e ele aparece na seção 11. No exemplo, o produto 1 existe e o produto 99 não existe, e a saída mostra a diferença:
produto 1: {ID:1 Nome:Caneca Categoria:casa Estoque:5} (erro: <nil>)
produto 99: erro=sql: no rows in result set, é sql.ErrNoRows=true
O Get também serve para um valor simples. Quando o destino é um tipo escalar, como um int, a consulta precisa devolver uma coluna só. O exemplo usa isso para contar os pedidos com SELECT COUNT(*).
Select faz o mesmo papel para várias linhas, preenchendo um slice. A consulta com lista de IDs, na seção 6, mostra o Select em uso junto com sqlx.In.
Repare também nos marcadores ?. O SQLite aceita ?. O PostgreSQL aceita $1, $2 e assim por diante. A seção 6 explica como o sqlx lida com essa diferença.
5. Consultas nomeadas com :nome
Uma troca ? por nomes como :nome, e o sqlx busca o valor de cada nome no struct, usando a tag db. O exemplo cadastra os produtos assim:
func semearProdutos(db *sqlx.DB) error {
	produtos := []Produto{
		{Nome: "Caneca", Categoria: "casa", Estoque: 5},
		{Nome: "Camiseta", Categoria: "roupa", Estoque: 10},
		{Nome: "Boné", Categoria: "roupa", Estoque: 0},
		{Nome: "Garrafa", Categoria: "casa", Estoque: 3},
	}
	for _, p := range produtos {
		// NamedExec troca :nome, :categoria e :estoque pelos campos do struct,
		// encontrados pela tag db. Não precisa montar a lista de argumentos.
		_, err := db.NamedExec(`INSERT INTO produtos (nome, categoria, estoque)
			VALUES (:nome, :categoria, :estoque)`, p)
		if err != nil {
			return err
		}
	}
	return nil
}
O NamedExec lê os campos Nome, Categoria e Estoque pelas tags, então você não monta a lista de argumentos na mão. Se o nome na consulta não existir no struct, o erro aparece antes de a consulta ser enviada. O teste que fiz com :nao_existe devolveu could not find name nao_existe in main.P{ID:0, Nome:"x"}. Esse é um erro de programação, não de banco, e ele é uma boa razão para manter a consulta e o struct lado a lado no mesmo arquivo.
Para ler, NamedQueryContext devolve um *sqlx.Rows, e o StructScan preenche um struct a cada chamada de Next. O exemplo filtra por categoria e estoque mínimo, com parâmetros nomeados vindos de outro struct:
// NamedQuery: os parâmetros :categoria e :minimo vêm do struct filtro.
func listarProdutos(ctx context.Context, db *sqlx.DB, f FiltroProduto) ([]Produto, error) {
	rows, err := db.NamedQueryContext(ctx, `
		SELECT id, nome, categoria, estoque FROM produtos
		WHERE categoria = :categoria AND estoque >= :minimo
		ORDER BY id`, f)
	if err != nil {
		return nil, err
	}
	defer rows.Close()

	var ps []Produto
	for rows.Next() {
		var p Produto
		if err := rows.StructScan(&p); err != nil {
			return nil, err
		}
		ps = append(ps, p)
	}
	return ps, rows.Err()
}
O filtro FiltroProduto usa a mesma regra: :categoria vai para o campo com a tag db:"categoria", e :minimo vai para o campo com a tag db:"minimo". O nome da tag não precisa ser igual ao nome do campo, e isso é útil quando a consulta usa um nome mais curto do que o da propriedade.
6. Listas com e
O database/sql não sabe expandir uma lista dentro de IN (?). Cada valor precisa de um marcador próprio, então é preciso gerar IN (?, ?, ?) com a quantidade certa. O sqlx.In faz essa expansão e devolve a consulta e a lista achatada de argumentos:
// Select com In: sqlx.In expande a lista em ?, ?, ?
func buscarProdutosPorIDs(ctx context.Context, db *sqlx.DB, ids []int) ([]Produto, error) {
	query, args, err := sqlx.In(
		"SELECT id, nome, categoria, estoque FROM produtos WHERE id IN (?) ORDER BY id", ids)
	if err != nil {
		return nil, err
	}
	// sqlx.In devolve ?. db.Rebind converte para o formato do driver
	// ($1, $2... no PostgreSQL). No SQLite, ? já é o formato certo.
	query = db.Rebind(query)

	var ps []Produto
	err = db.SelectContext(ctx, &ps, query, args...)
	return ps, err
}
O sqlx.In devolve sempre o marcador ?. Para o driver que usa outro formato, o Rebind faz a conversão. Testei a função de texto diretamente, sem servidor, e a saída foi esta:
In -> SELECT id FROM t WHERE id IN (?, ?, ?) AND nome = ? [1 3 4 x]
Rebind DOLLAR -> SELECT id FROM t WHERE id IN ($1, $2, $3) AND nome = $4
Rebind QUESTION -> SELECT id FROM t WHERE id IN (?, ?, ?) AND nome = ?
O sqlx decide o formato pelo nome do driver. sqlx.BindType("pgx") devolveu 2, que é DOLLAR, e sqlx.BindType("sqlite") devolveu 0, que é UNKNOWN. Como o sqlx não conhece o nome "sqlite", o Rebind deixa o ? como está, e a consulta funciona. Esse comportamento é o motivo de o exemplo chamar db.Rebind mesmo no SQLite: o código fica certo quando você trocar o driver. Se o seu driver não estiver na lista do sqlx, sqlx.BindDriver registra o formato usado.
Há uma armadilha aqui. Uma lista vazia não gera IN (), que é SQL inválido. O sqlx recusa a expansão com o erro empty slice passed to 'in' query, e é melhor checar o tamanho da lista antes de chamar a função.
7. Transações com Beginx,
Uma transação agrupa escritas que precisam acontecer juntas. Ou todas se confirmam, ou nenhuma fica gravada. No nível do driver, a transação reserva uma conexão do pool até o fim, como explica a aula database-sql e Connection Pooling. O sqlx abre a transação com BeginTxx, que recebe um contexto, ou com Beginx, que não recebe. Prefira BeginTxx, porque o contexto permite cancelar a operação inteira.
O diagrama abaixo mostra o caminho de um pedido com um produto com estoque insuficiente:
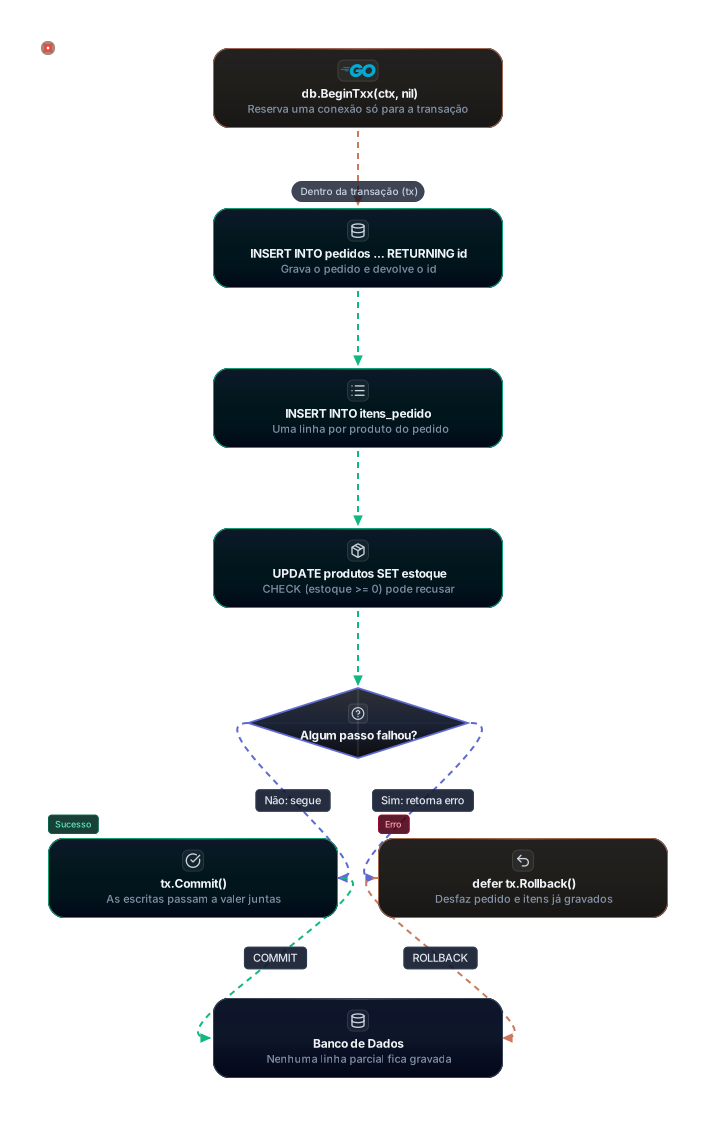
A linha de cima é a transação. O pedido e cada item entram na mesma conexão, e o UPDATE do estoque passa pelo CHECK do schema. Quando o CHECK recusa a linha, a função retorna o erro, e o defer chama Rollback, que desfaz o pedido e os itens que já tinham sido gravados. Quando tudo dá certo, o Commit confirma as escritas, e o Rollback que o defer chama depois não faz nada. Ele devolve sql.ErrTxDone, o que o código ignora de propósito.
O código abaixo implementa esse caminho:
// criarPedido grava o pedido e baixa o estoque de cada item, tudo ou nada.
func criarPedido(ctx context.Context, db *sqlx.DB, cliente string, itens []ItemPedido) (int, error) {
	tx, err := db.BeginTxx(ctx, nil)
	if err != nil {
		return 0, fmt.Errorf("abrir transação: %w", err)
	}
	// Se o Commit der certo, este Rollback devolve sql.ErrTxDone e não faz nada.
	// Se qualquer passo falhar e a função retornar, ele desfaz tudo.
	defer tx.Rollback()

	var pedidoID int
	err = tx.GetContext(ctx, &pedidoID,
		"INSERT INTO pedidos (cliente) VALUES (?) RETURNING id", cliente)
	if err != nil {
		return 0, fmt.Errorf("inserir pedido: %w", err)
	}

	for _, item := range itens {
		_, err := tx.ExecContext(ctx,
			"INSERT INTO itens_pedido (pedido_id, produto_id, quantidade) VALUES (?, ?, ?)",
			pedidoID, item.ProdutoID, item.Quantidade)
		if err != nil {
			return 0, fmt.Errorf("inserir item do produto %d: %w", item.ProdutoID, err)
		}

		// Se o estoque ficar negativo, o CHECK do schema recusa o UPDATE.
		_, err = tx.ExecContext(ctx,
			"UPDATE produtos SET estoque = estoque - ? WHERE id = ?",
			item.Quantidade, item.ProdutoID)
		if err != nil {
			return 0, fmt.Errorf("baixar estoque do produto %d: %w", item.ProdutoID, err)
		}
	}

	if err := tx.Commit(); err != nil {
		return 0, fmt.Errorf("confirmar pedido: %w", err)
	}
	return pedidoID, nil
}
O padrão defer tx.Rollback() logo depois do BeginTxx é a parte que mais se copia e a que mais se esquece. Ele cobre todas as saídas da função, inclusive as que você não escreveu pensando em erro, como um return esquecido no meio de um laço. Eu testei o comportamento de Rollback depois de Commit: o retorno foi sql: transaction has already been committed or rolled back, que é o sql.ErrTxDone documentado pelo pacote database/sql.
O contexto também participa da transação. A documentação do BeginTxx diz que, se o contexto for cancelado antes do Commit, o pacote database/sql desfaz a transação, e o Commit devolve erro. O exemplo passa ctx para todas as chamadas, então o cancelamento de quem chamou encerra a operação inteira.
Essa última regra tem consequência prática. Dentro de uma transação, toda operação precisa passar por tx. Quando o pool tem só uma conexão, usar db no meio da transação faz a consulta esperar uma conexão que a própria transação segura. O teste que fiz deixou essa espera até o contexto expirar, com o erro context deadline exceeded depois de 500 ms. Em produção, esse tipo de bloqueio costuma aparecer como requisições penduradas, sem nenhuma mensagem clara no log.
8. Exemplo completo rodado
O programa abaixo é o arquivo exato que rodei. Usei go1.27.2 (darwin/arm64), sqlx v1.4.0 e modernc.org/sqlite v1.61.1. Para rodar, crie um módulo com go mod init e as duas instalações da seção 2, grave o código como main.go e execute go run .. A saída vem logo depois do código.
package main

import (
	"context"
	"database/sql"
	"errors"
	"fmt"
	"log"
	"time"

	"github.com/jmoiron/sqlx"
	_ "modernc.org/sqlite" // driver "sqlite": puro Go, sem cgo
)

const schema = `
CREATE TABLE produtos (
    id        INTEGER PRIMARY KEY,
    nome      TEXT    NOT NULL,
    categoria TEXT    NOT NULL,
    estoque   INTEGER NOT NULL CHECK (estoque >= 0)
);
CREATE TABLE pedidos (
    id      INTEGER PRIMARY KEY,
    cliente TEXT NOT NULL
);
CREATE TABLE itens_pedido (
    pedido_id  INTEGER NOT NULL REFERENCES pedidos(id),
    produto_id INTEGER NOT NULL REFERENCES produtos(id),
    quantidade INTEGER NOT NULL CHECK (quantidade > 0)
);
`

type Produto struct {
	ID        int    `db:"id"`
	Nome      string `db:"nome"`
	Categoria string `db:"categoria"`
	Estoque   int    `db:"estoque"`
}

type FiltroProduto struct {
	Categoria     string `db:"categoria"`
	EstoqueMinimo int    `db:"minimo"`
}

type ItemPedido struct {
	ProdutoID  int `db:"produto_id"`
	Quantidade int `db:"quantidade"`
}

func abrirBanco() (*sqlx.DB, error) {
	db, err := sqlx.Open("sqlite", ":memory:")
	if err != nil {
		return nil, err
	}
	// Cada conexão a ":memory:" enxerga um banco separado e vazio.
	// Com uma conexão só no pool, todas as operações veem os mesmos dados.
	db.SetMaxOpenConns(1)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Second)
	defer cancel()
	if err := db.PingContext(ctx); err != nil {
		db.Close()
		return nil, err
	}
	if _, err := db.Exec(schema); err != nil {
		db.Close()
		return nil, err
	}
	return db, nil
}

func semearProdutos(db *sqlx.DB) error {
	produtos := []Produto{
		{Nome: "Caneca", Categoria: "casa", Estoque: 5},
		{Nome: "Camiseta", Categoria: "roupa", Estoque: 10},
		{Nome: "Boné", Categoria: "roupa", Estoque: 0},
		{Nome: "Garrafa", Categoria: "casa", Estoque: 3},
	}
	for _, p := range produtos {
		// NamedExec troca :nome, :categoria e :estoque pelos campos do struct,
		// encontrados pela tag db. Não precisa montar a lista de argumentos.
		_, err := db.NamedExec(`INSERT INTO produtos (nome, categoria, estoque)
			VALUES (:nome, :categoria, :estoque)`, p)
		if err != nil {
			return err
		}
	}
	return nil
}

// Get: uma linha só, preenchida em um struct.
func buscarProduto(ctx context.Context, db *sqlx.DB, id int) (Produto, error) {
	var p Produto
	err := db.GetContext(ctx, &p,
		"SELECT id, nome, categoria, estoque FROM produtos WHERE id = ?", id)
	return p, err
}

// Select com In: sqlx.In expande a lista em ?, ?, ?
func buscarProdutosPorIDs(ctx context.Context, db *sqlx.DB, ids []int) ([]Produto, error) {
	query, args, err := sqlx.In(
		"SELECT id, nome, categoria, estoque FROM produtos WHERE id IN (?) ORDER BY id", ids)
	if err != nil {
		return nil, err
	}
	// sqlx.In devolve ?. db.Rebind converte para o formato do driver
	// ($1, $2... no PostgreSQL). No SQLite, ? já é o formato certo.
	query = db.Rebind(query)

	var ps []Produto
	err = db.SelectContext(ctx, &ps, query, args...)
	return ps, err
}

// NamedQuery: os parâmetros :categoria e :minimo vêm do struct filtro.
func listarProdutos(ctx context.Context, db *sqlx.DB, f FiltroProduto) ([]Produto, error) {
	rows, err := db.NamedQueryContext(ctx, `
		SELECT id, nome, categoria, estoque FROM produtos
		WHERE categoria = :categoria AND estoque >= :minimo
		ORDER BY id`, f)
	if err != nil {
		return nil, err
	}
	defer rows.Close()

	var ps []Produto
	for rows.Next() {
		var p Produto
		if err := rows.StructScan(&p); err != nil {
			return nil, err
		}
		ps = append(ps, p)
	}
	return ps, rows.Err()
}

// criarPedido grava o pedido e baixa o estoque de cada item, tudo ou nada.
func criarPedido(ctx context.Context, db *sqlx.DB, cliente string, itens []ItemPedido) (int, error) {
	tx, err := db.BeginTxx(ctx, nil)
	if err != nil {
		return 0, fmt.Errorf("abrir transação: %w", err)
	}
	// Se o Commit der certo, este Rollback devolve sql.ErrTxDone e não faz nada.
	// Se qualquer passo falhar e a função retornar, ele desfaz tudo.
	defer tx.Rollback()

	var pedidoID int
	err = tx.GetContext(ctx, &pedidoID,
		"INSERT INTO pedidos (cliente) VALUES (?) RETURNING id", cliente)
	if err != nil {
		return 0, fmt.Errorf("inserir pedido: %w", err)
	}

	for _, item := range itens {
		_, err := tx.ExecContext(ctx,
			"INSERT INTO itens_pedido (pedido_id, produto_id, quantidade) VALUES (?, ?, ?)",
			pedidoID, item.ProdutoID, item.Quantidade)
		if err != nil {
			return 0, fmt.Errorf("inserir item do produto %d: %w", item.ProdutoID, err)
		}

		// Se o estoque ficar negativo, o CHECK do schema recusa o UPDATE.
		_, err = tx.ExecContext(ctx,
			"UPDATE produtos SET estoque = estoque - ? WHERE id = ?",
			item.Quantidade, item.ProdutoID)
		if err != nil {
			return 0, fmt.Errorf("baixar estoque do produto %d: %w", item.ProdutoID, err)
		}
	}

	if err := tx.Commit(); err != nil {
		return 0, fmt.Errorf("confirmar pedido: %w", err)
	}
	return pedidoID, nil
}

// NUNCA faça isto: a entrada do usuário vira parte do texto do SQL.
func buscarPorNomeInseguro(db *sqlx.DB, nome string) ([]Produto, error) {
	query := "SELECT id, nome, categoria, estoque FROM produtos WHERE nome = '" + nome + "'"
	var ps []Produto
	err := db.Select(&ps, query)
	return ps, err
}

// Forma correta: o valor vai como parâmetro, separado do texto do SQL.
func buscarPorNomeSeguro(ctx context.Context, db *sqlx.DB, nome string) ([]Produto, error) {
	var ps []Produto
	err := db.SelectContext(ctx, &ps,
		"SELECT id, nome, categoria, estoque FROM produtos WHERE nome = ?", nome)
	return ps, err
}

func main() {
	ctx := context.Background()

	db, err := abrirBanco()
	if err != nil {
		log.Fatal(err)
	}
	defer db.Close()

	if err := semearProdutos(db); err != nil {
		log.Fatal(err)
	}

	fmt.Println("== Get")
	p, err := buscarProduto(ctx, db, 1)
	fmt.Printf("produto 1: %+v (erro: %v)\n", p, err)
	_, err = buscarProduto(ctx, db, 99)
	fmt.Printf("produto 99: erro=%v, é sql.ErrNoRows=%t\n", err, errors.Is(err, sql.ErrNoRows))

	fmt.Println("== Select com In")
	ps, err := buscarProdutosPorIDs(ctx, db, []int{1, 3, 4})
	if err != nil {
		log.Fatal(err)
	}
	for _, p := range ps {
		fmt.Printf("  %+v\n", p)
	}

	fmt.Println("== NamedQuery com StructScan")
	roupas, err := listarProdutos(ctx, db, FiltroProduto{Categoria: "roupa", EstoqueMinimo: 1})
	if err != nil {
		log.Fatal(err)
	}
	for _, p := range roupas {
		fmt.Printf("  %+v\n", p)
	}

	fmt.Println("== Transação que falha no segundo item")
	// A Caneca (produto 1) tem estoque 5. A Garrafa (produto 4) tem 3, e o pedido pede 99.
	itensRuins := []ItemPedido{{ProdutoID: 1, Quantidade: 2}, {ProdutoID: 4, Quantidade: 99}}
	_, err = criarPedido(ctx, db, "Ana", itensRuins)
	fmt.Printf("erro: %v\n", err)

	var pedidos int
	if err := db.GetContext(ctx, &pedidos, "SELECT COUNT(*) FROM pedidos"); err != nil {
		log.Fatal(err)
	}
	var caneca Produto
	if err := db.GetContext(ctx, &caneca, "SELECT id, nome, categoria, estoque FROM produtos WHERE id = 1"); err != nil {
		log.Fatal(err)
	}
	fmt.Printf("pedidos gravados: %d; estoque da Caneca: %d (o rollback desfez o primeiro item)\n", pedidos, caneca.Estoque)

	fmt.Println("== Transação que dá certo")
	itensBons := []ItemPedido{{ProdutoID: 1, Quantidade: 2}, {ProdutoID: 2, Quantidade: 1}}
	id, err := criarPedido(ctx, db, "Bruno", itensBons)
	if err != nil {
		log.Fatal(err)
	}
	fmt.Printf("pedido %d criado\n", id)
	if err := db.GetContext(ctx, &pedidos, "SELECT COUNT(*) FROM pedidos"); err != nil {
		log.Fatal(err)
	}
	if err := db.GetContext(ctx, &caneca, "SELECT id, nome, categoria, estoque FROM produtos WHERE id = 1"); err != nil {
		log.Fatal(err)
	}
	fmt.Printf("pedidos gravados: %d; estoque da Caneca: %d\n", pedidos, caneca.Estoque)

	fmt.Println("== Entrada maliciosa")
	entrada := "x' OR '1'='1"
	inseguros, _ := buscarPorNomeInseguro(db, entrada)
	seguros, _ := buscarPorNomeSeguro(ctx, db, entrada)
	fmt.Printf("concatenado: %d linhas\n", len(inseguros))
	fmt.Printf("parâmetro:   %d linhas\n", len(seguros))
}
Saída real do programa:
== Get
produto 1: {ID:1 Nome:Caneca Categoria:casa Estoque:5} (erro: <nil>)
produto 99: erro=sql: no rows in result set, é sql.ErrNoRows=true
== Select com In
  {ID:1 Nome:Caneca Categoria:casa Estoque:5}
  {ID:3 Nome:Boné Categoria:roupa Estoque:0}
  {ID:4 Nome:Garrafa Categoria:casa Estoque:3}
== NamedQuery com StructScan
  {ID:2 Nome:Camiseta Categoria:roupa Estoque:10}
== Transação que falha no segundo item
erro: baixar estoque do produto 4: constraint failed: CHECK constraint failed: estoque >= 0 (275)
pedidos gravados: 0; estoque da Caneca: 5 (o rollback desfez o primeiro item)
== Transação que dá certo
pedido 1 criado
pedidos gravados: 1; estoque da Caneca: 3
== Entrada maliciosa
concatenado: 4 linhas
parâmetro:   0 linhas
A saída mostra três coisas que as seções anteriores prometeram. A primeira é a transação que falhou: o pedido da Ana não ficou gravado, e a Caneca continua com estoque 5, o que prova que o primeiro item também foi desfeito. A segunda é a transação que deu certo, com o pedido 1 e o estoque da Caneca baixando de 5 para 3. A terceira são as duas últimas linhas, que mostram a diferença entre concatenar a entrada e passá-la como parâmetro. A seção seguinte explica essa última parte.
9. Cuidado com SQL montado por interpolação
Interpolar é montar o SQL colando um valor de fora dentro do texto da consulta. Com uma entrada comum, como Caneca, o resultado parece correto. Com uma entrada escrita por alguém querendo mexer na consulta, o texto final muda de significado. A função insegura do exemplo faz isso:
// NUNCA faça isto: a entrada do usuário vira parte do texto do SQL.
func buscarPorNomeInseguro(db *sqlx.DB, nome string) ([]Produto, error) {
	query := "SELECT id, nome, categoria, estoque FROM produtos WHERE nome = '" + nome + "'"
	var ps []Produto
	err := db.Select(&ps, query)
	return ps, err
}
A figura compara a mesma entrada nas duas formas:
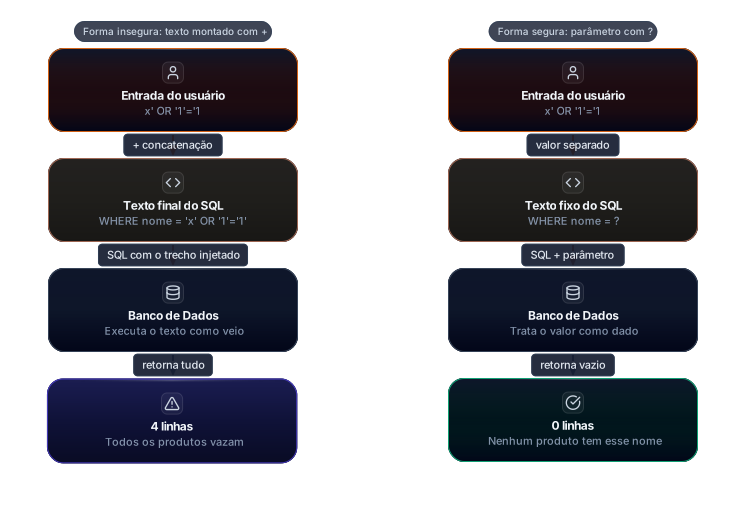
Na forma insegura, o banco recebe um texto só, e não consegue distinguir a parte que você escreveu da parte que veio do usuário. A aspa da entrada fecha o literal, o OR '1'='1' vira uma condição que sempre é verdadeira, e a consulta devolve os quatro produtos. Na forma segura, o texto do SQL é fixo, e o valor viaja separado, como dado. O banco nunca interpreta a entrada como comando, então nenhum produto tem o nome literal x' OR '1'='1, e a consulta devolve zero linhas. No teste, a saída foi concatenado: 4 linhas e parâmetro: 0 linhas.
A recomendação da OWASP vai na mesma direção. A folha de referência sobre prevenção de SQL injection pede que a estrutura da consulta seja definida separadamente dos valores, e que os valores sejam ligados pela API do banco. Ela também diz que montar a consulta com valores não confiáveis antes de prepará-la anula essa proteção. Ou seja, não adianta escapar a string à mão e achar que está seguro: a forma correta é deixar o driver fazer o trabalho.
Há um limite importante. O parâmetro serve para valores, não para nomes de tabela ou de coluna. Se a aplicação precisar escolher a coluna de ordenação a partir de uma entrada, a lista de colunas permitidas tem de estar fixada no código ou validada contra um conjunto conhecido, e a entrada só escolhe um item dessa lista.
10. Quando usar sqlx, sqlc ou pgx puro
O sqlx é uma boa escolha quando você quer manter o SQL escrito à mão e tirar do caminho o trabalho repetitivo de preencher structs. Ele continua usando a interface database/sql, então qualquer código que já a use pode migrar aos poucos. O custo é que a checagem entre consulta e struct acontece em tempo de execução. O erro missing destination name que vimos na seção 3 aparece quando a consulta roda, e não quando o código compila.
O sqlc vai por outro caminho. Ele lê arquivos .sql e gera código Go tipado a partir deles, de modo que a incompatibilidade entre consulta e schema aparece na geração do código, antes de o programa rodar. A aula SQLC - Type-Safe SQL mostra esse fluxo. Se a equipe quer o máximo de verificação antes do deploy e aceita um passo de geração no build, o sqlc costuma ser a escolha mais segura. Não medi a diferença de desempenho entre as duas abordagens nesta aula, então não vou afirmar um número.
O pgx puro, usado com a interface própria do driver, dá acesso a recursos específicos do PostgreSQL, como lotes de comandos e tipos que o database/sql não representa bem. A aula PostgreSQL com pgx cobre esse caminho. Quando você precisa desses recursos, ou quando o desempenho do PostgreSQL é um requisito real do projeto, usar o pgx direto costuma compensar a perda de conveniência. Se o projeto só precisa de consultas comuns e quer a escrita do dia a dia enxuta, o sqlx basta.
11. Erros comuns e boas práticas
O erro mais frequente é concatenar a entrada do usuário no SQL. Ele já foi discutido na seção 9, e vale repetir o motivo: a consulta deixa de ser a que você escreveu. Quando isso acontece com dados sensíveis, o problema deixa de ser de estilo.
O segundo erro é tratar sql.ErrNoRows como falha do banco. Quando a linha não existe, a resposta correta da aplicação costuma ser 404, e não 500. Separe os dois casos com errors.Is e deixe o erro de conexão seguir como erro de verdade.
O terceiro é esquecer o defer tx.Rollback(), ou colocar o Rollback só no caminho de erro explícito. Sem o defer, um return esquecido no meio de uma função longa deixa a transação aberta, com as linhas travadas e a conexão presa no pool. A regra simples é colocar o defer logo depois do BeginTxx, sempre.
O quarto é usar db dentro de uma transação, como vimos na seção 7. Com o pool no limite, a consulta espera uma conexão que nunca será liberada, enquanto a transação espera a consulta. Passe tx para todas as operações que pertencem à transação.
O quinto é esquecer o Rebind ao trocar de driver. Uma consulta com ? enviada ao PostgreSQL chega com um marcador que o servidor não reconhece, e a falha só aparece na primeira execução real. Como o Rebind não muda nada no SQLite, use-o desde o começo, mesmo quando o driver de hoje não precisa dele.
O sexto é usar Unsafe() para calar um erro de mapeamento. Ele funciona, mas esconde a coluna que você esqueceu de declarar. Quando a consulta muda, o struct fica para trás e o problema some do log. Deixe o aviso ligado e corrija a consulta ou o struct.
O sétimo é usar :memory: com um pool de conexões maior que um. Cada conexão a :memory: abre um banco separado. O teste com duas conexões mostrou no such table: t na segunda conexão, porque ela enxergava um banco vazio. A documentação do SQLite diz que cada banco :memory: é distinto dos outros. Por isso o exemplo usa SetMaxOpenConns(1), e a saída mostra que a tabela criada na primeira conexão continua lá para as operações seguintes.
12. Exercícios com resposta de referência
Faça os exercícios em um módulo separado, com o mesmo schema do exemplo. As respostas abaixo são referências, e não as rodei separadamente.
-
Escreva
buscarProdutosPorCategorias(ctx context.Context, db *sqlx.DB, categorias []string) ([]Produto, error), que devolve os produtos cujas categorias estão na lista. Resposta de referência: usesqlx.InsobreWHERE categoria IN (?), passe o resultado pordb.Rebinde chamedb.SelectContext. Antes de tudo, retorne um slice vazio secategoriasestiver vazia, porque osqlx.Inrecusa a lista vazia. -
Escreva
transferirUnidade(ctx context.Context, db *sqlx.DB, origemID, destinoID int) error, que tira uma unidade de estoque de um produto e põe no outro, em uma única transação. Resposta de referência: abra a transação comBeginTxx, coloquedefer tx.Rollback()logo em seguida, faça doisUPDATEcomtx.ExecContexte termine comtx.Commit(). Se o estoque da origem for zero, oCHECKrecusa o primeiroUPDATE, e oRollbackdesfaz tudo. Teste com um produto com estoque 0 e confira que o destino não mudou. -
Pegue a função
buscarPorNomeInseguroe troque a concatenação por um parâmetro. Explique, sem rodar, por que o texto do SQL deixa de mudar com a entrada e por que a consulta comx' OR '1'='1passa a devolver zero linhas. Resposta de referência: o valor vira um argumento separado, que o driver trata como dado. O texto do SQL fica idêntico para qualquer entrada, então a aspa não fecha literal nenhum.
13. O que não foi confirmado
Algumas afirmações desta aula ficaram fora do que consegui verificar, e prefiro declarar isso aqui a deixar uma frase sem fonte:
- O exemplo rodou só com SQLite em memória. O Docker estava parado, então não rodei nada contra um servidor PostgreSQL. O
BindTypedepgxe oRebindpara$1foram verificados como funções de texto, sem conexão. - Não medi desempenho. A comparação entre sqlx, sqlc e pgx puro é qualitativa, baseada na documentação de cada projeto.
- A manutenção do sqlx não foi avaliada além da data da última versão. A v1.4.0 é de abril de 2024, e não encontrei release posterior em 2026-11-03. Não verifiquei a atividade recente do repositório.
- As mensagens de erro citadas (
CHECK constraint failed,missing destination name,could not find name) são as da versão de driver e de biblioteca desta aula. Elas podem mudar em outras versões. - As respostas dos exercícios da seção 12 não foram rodadas.
14. Glossário
- Tag
db: texto entre crases depois de um campo de struct, que diz a qual coluna o campo corresponde. NameMapper: função que converte o nome de um campo sem tag no nome da coluna. Por padrão éstrings.ToLower.StructScan: preenche um struct com a linha atual de umRows.- Consulta nomeada: consulta que usa
:nomeno lugar de?, com valores vindos de um struct ou map. sqlx.In: expande um slice em uma lista de marcadores?, um para cada valor.Rebind: converte o marcador?para o formato que o driver espera, como$1no PostgreSQL.- Transação: grupo de operações que são confirmadas juntas ou desfeitas juntas.
CommiteRollback: confirmam ou desfazem a transação. Depois de umCommit, oRollbackdevolvesql.ErrTxDone.sql.ErrNoRows: erro devolvido quando uma consulta de uma linha não encontra nada.- Interpolação: montar o texto do SQL colando valores de fora, em vez de passá-los como parâmetros.
SetMaxOpenConns: limita quantas conexões o pool pode abrir ao mesmo tempo.
15. Fontes
Consultadas em 2026-11-03:
- Documentação do pacote sqlx v1.4.0, lida com
go docno módulo baixado do proxy de módulos: https://pkg.go.dev/github.com/jmoiron/sqlx@v1.4.0 - README do projeto sqlx: https://github.com/jmoiron/sqlx
- Lista de versões do sqlx no proxy de módulos: https://proxy.golang.org/github.com/jmoiron/sqlx/@v/list
- Página de releases do sqlx no GitHub, com a v1.4.0 marcada como “Latest”: https://github.com/jmoiron/sqlx/releases
- Documentação do pacote
database/sql, lida comgo docna toolchain go1.27.2: https://pkg.go.dev/database/sql - Driver
modernc.org/sqlitev1.61.1: https://pkg.go.dev/modernc.org/sqlite - SQLite, sobre bancos
:memory:: https://www.sqlite.org/inmemorydb.html - OWASP, SQL Injection Prevention Cheat Sheet: https://cheatsheetseries.owasp.org/cheatsheets/SQL_Injection_Prevention_Cheat_Sheet.html
Relacionados
- database-sql e Connection Pooling, o pool e as transações no nível do driver.
- PostgreSQL com pgx, o driver de alto desempenho para PostgreSQL.
- SQLC - Type-Safe SQL, a alternativa que gera código tipado a partir de SQL.
- GORM na Prática, o caminho com ORM e as trocas que ele traz.
- Database Migrations com Goose, a próxima etapa, para versionar o schema que as consultas usam.
- Tags e Structs, para revisar as tags e a declaração de structs.
- Context, para entender o cancelamento e o prazo nas chamadas com
ctx. - Tratamento de Erros Idiomático, para separar
sql.ErrNoRowsde erros de verdade. - Go, o ponto de partida da trilha.