Structs em Go: campos, embedding, ponteiros e padding
Declare, inicialize e compare structs em Go, entenda o embedding como composição e veja como ponteiros, cópia por valor e padding afetam a memória.
intermediárioPublicada em · 34 min de leitura
Uma é uma marmita de três compartimentos. O grande leva o arroz, o do meio leva a carne e o pequeno leva a salada. Cada compartimento tem um lugar fixo e um tamanho que ninguém discute, e quem recebe a marmita sabe onde procurar cada coisa sem abrir tudo. Em Go, a marmita é o tipo, os compartimentos são os campos, e o nome e o tipo de cada são decididos na declaração e conferidos pelo compilador antes de o programa rodar.
Sem structs, um programa que representa um paciente costuma espalhar o nome, a idade e o convênio por variáveis soltas e passá-las uma a uma para as funções. Uma função com sete parâmetros parece inofensiva até alguém trocar a ordem de dois deles, e o compilador não reclama porque os dois são string. A struct resolve isso agrupando os dados sob um nome. Esta aula cobre a declaração e a inicialização, a visibilidade dos campos, a comparação, a composição por , os ponteiros, o custo de copiar uma struct e o efeito do de memória no tamanho final.
Mapa da aula
A ordem segue a dependência entre as ideias. Primeiro você declara e cria structs, porque todo o resto usa isso. Depois vêm a visibilidade e a comparação, que dependem de saber quais campos existem e quem pode vê-los. Por último vêm a memória e a cópia, que dependem de como uma struct ocupa espaço na RAM.
| Parte | Seções | O que você vai aprender |
|---|---|---|
| Fundamentos | 1 a 4 | Declarar, inicializar, , campos exportados e structs anônimas |
| Composição | 5 a 7 | Comparação com ==, embedding com de campos e métodos, tags |
| Memória | 8 a 10 | Ponteiro para struct, cópia por valor e seus custos, alinhamento e |
| Prática | 11 a 13 | Erros comuns, exercícios com resposta de referência, o que não foi confirmado |
| Consulta | 14 e 15 | Glossário e fontes |
Os pré-requisitos são variáveis, tipos básicos e a ideia de função. Todos os exemplos desta aula foram executados com go1.27.2 em macOS (darwin/arm64) em 2026-11-03. A saída que aparece nos blocos é a saída real dessa execução, e não uma estimativa.
1. O que é uma struct
Uma struct é um tipo composto: um tipo que reúne outros tipos sob um nome, com cada parte identificada por um campo. Ela serve para modelar uma entidade do domínio, como um usuário, um pedido, uma configuração ou um ponto no mapa.
Poderia-se guardar um paciente num map[string]any, e o programa funcionaria. A diferença aparece quando alguém digita "Idaed" em vez de "Idade". O map devolve o valor zero da chave ausente, sem erro nenhum, e o bug só aparece quando o cálculo der um resultado estranho. Com uma struct, o nome do campo é um identificador do programa: se estiver errado, o compilador recusa o código antes de ele rodar. Esse é o ganho principal de tipar os dados: o erro de digitação deixa de ser um problema de produção.
Structs também não têm herança nem classes. A seção 6 mostra como Go reaproveita código sem elas, e por que a composição costuma dar menos surpresa do que a herança.
2. Declarar e inicializar
A palavra type cria um tipo novo com nome e campos. A declaração descreve o molde, mas ainda não cria nenhum valor, do mesmo jeito que o desenho de uma marmita não serve de almoço. Para ter um valor, você usa um , que é a lista de campos entre chaves.
package main

import "fmt"

type Paciente struct {
	Nome     string
	Idade    int
	Convenio string
	Ativo    bool
}

type Ponto struct {
	X, Y int
}

func main() {
	p1 := Paciente{
		Nome:     "Carlos Drummond",
		Idade:    45,
		Convenio: "Saude Total",
		Ativo:    true,
	}
	fmt.Printf("%+v\n", p1)

	var zero Paciente
	fmt.Printf("valor zero: %+v\n", zero)
	fmt.Printf("nome vazio? %t, idade %d\n", zero.Nome == "", zero.Idade)

	pos := Ponto{10, 20}
	fmt.Printf("posicional: %+v\n", pos)
}
{Nome:Carlos Drummond Idade:45 Convenio:Saude Total Ativo:true}
valor zero: {Nome: Idade:0 Convenio: Ativo:false}
nome vazio? true, idade 0
posicional: {X:10 Y:20}Há três formas de preencher uma struct. A primeira é o literal nomeado, que aparece em Paciente{Nome: ..., Idade: ...}. Ele é a forma recomendada para código de produção, porque não depende da ordem em que os campos foram declarados e deixa claro o que cada valor significa. Você pode omitir campos nesse formato, e cada campo omitido recebe o valor zero do tipo dele.
A segunda forma é o literal posicional, como Ponto{10, 20}. Ele exige um valor para cada campo, na ordem da declaração. Para um ponto de duas coordenadas ele é aceitável. Para uma struct de negócio, ele é um convite a problemas, porque o literal deixa de compilar quando o campo novo entra na declaração, e a mensagem de erro aponta o literal, não a mudança que o causou.
package main

import "fmt"

type Paciente struct {
	Nome  string
	Idade int
}

func main() {
	p := Paciente{"Ana", 30}
	fmt.Println(p)
	q := Paciente{"Bia"}
	fmt.Println(q)
}
# command-line-arguments
./main.go:13:21: too few values in struct literal of type PacienteO compilador recusou a linha 13, que omite a idade no formato posicional. A linha 12 compila, e isso engana quem testa só com um exemplo. Se você quiser que o código sobreviva a mudanças na struct, use o literal nomeado.
A terceira forma é o valor zero, que você obtém com var zero Paciente. A especificação diz que, quando a memória de uma variável é alocada e nenhuma inicialização é dada, cada elemento recebe o valor zero do tipo: false para booleanos, 0 para números e "" para strings. Structs não recebem nil, porque uma struct é um valor e não uma referência. Isso é cômodo: a struct sempre existe e sempre tem campos legíveis. O cuidado é outro: um campo esquecido vira zero sem aviso, e esse zero pode ser um valor perigoso, como uma idade igual a zero ou um Ativo falso num cadastro que deveria estar ativo.
Projetar uma struct pensando no valor zero costuma dar bons resultados. Um campo booleano cujo false significa “não autorizado” é mais seguro do que um campo cujo false significa “autorizado” e cujo zero é o padrão para qualquer cadastro novo.
3. Campos exportados e não exportados
Em Go, a visibilidade é decidida pela primeira letra do nome, não por uma palavra-chave como public ou private. Um campo que começa com letra maiúscula é exportado: pode ser lido e escrito por código de outros pacotes. Um campo que começa com minúscula não é exportado: só o próprio pacote enxerga esse campo.
A regra vale para o pacote, não para a struct. Dentro do mesmo pacote, todos os campos são acessíveis, inclusive os minúsculos. Para ver a diferença de verdade, a melhor forma é usar dois pacotes. Este módulo tem um pacote modelos, que declara o usuário, e um pacote app, que o usa.
exemplo/
├── go.mod
├── modelos/usuario.go
└── app/main.go
// go.mod
module exemplo
go 1.27// modelos/usuario.go
package modelos
type Usuario struct {
Nome string
senha string
}
func NovoUsuario(nome, senha string) Usuario {
return Usuario{Nome: nome, senha: senha}
}
func (u Usuario) Confere(s string) bool {
return u.senha == s
}// app/main.go
package main
import (
"encoding/json"
"fmt"
"exemplo/modelos"
)
func main() {
u := modelos.NovoUsuario("Ana", "123")
fmt.Println(u.Nome, u.Confere("123"))
fmt.Printf("%+v\n", u)
saida, _ := json.Marshal(u)
fmt.Println(string(saida))
}Ana true
{Nome:Ana senha:123}
{"Nome":"Ana"}O pacote app consegue chamar NovoUsuario e Confere, porque ambos são exportados, e lê Nome, que também é. A saída mostra algo curioso: fmt imprime senha mesmo ele não sendo exportado, enquanto encoding/json ignora o campo. O fmt usa reflexão para formatar qualquer valor, então ele enxerga tudo o que a struct tem. O json respeita a regra de exportação e só serializa o que pode ver de fora.
Quem escreve modelos.Usuario{Nome: "Bia", senha: "x"} no pacote app recebe um erro:
# exemplo/erro
./main.go:10:36: cannot refer to unexported field senha in struct literal of type modelos.Usuario
./main.go:11:16: u.senha undefined (cannot refer to unexported field senha)
A consequência prática é que não exportado protege o campo de outros pacotes, mas não protege o valor de quem tem a struct em mãos. Uma senha guardada num campo minúsculo aparece em qualquer %+v que alguém colocar num log. Dados sensíveis devem ficar fora de structs que vão para log ou devem ser guardados como resumo, como um hash, e nunca em texto puro.
4. Structs anônimas
Uma struct não precisa de nome. Quando um tipo só faz sentido dentro de uma função, você pode declará-lo no próprio lugar de uso, com struct { ... } seguido do literal. O caso mais comum são as tabelas de teste, em que cada caso é uma linha com alguns campos e nenhum motivo para virar um tipo do pacote.
O teste abaixo usa uma para descrever os casos. Ela existe só dentro de TestSomar, e ninguém de fora precisa conhecê-la.
package main

import "testing"

func somar(a, b int) int { return a + b }

func TestSomar(t *testing.T) {
	testes := []struct {
		nome     string
		a, b     int
		esperado int
	}{
		{"positivos", 2, 3, 5},
		{"com zero", 10, 0, 10},
		{"negativos", -4, -6, -10},
	}
	for _, tt := range testes {
		t.Run(tt.nome, func(t *testing.T) {
			if r := somar(tt.a, tt.b); r != tt.esperado {
				t.Errorf("obtido %d, esperado %d", r, tt.esperado)
			}
		})
	}
}
=== RUN TestSomar
=== RUN TestSomar/positivos
=== RUN TestSomar/com_zero
=== RUN TestSomar/negativos
--- PASS: TestSomar (0.00s)
--- PASS: TestSomar/positivos (0.00s)
--- PASS: TestSomar/com_zero (0.00s)
--- PASS: TestSomar/negativos (0.00s)
PASS
ok ex9 0.182sUma struct anônima também pode ser atribuída a uma variável de um tipo nomeado, desde que os dois tipos tenham o mesmo tipo subjacente e pelo menos um deles não seja nomeado. A especificação diz exatamente isso: um valor de tipo V é atribuível a T quando os dois têm tipos subjacentes idênticos e pelo menos um deles não é um tipo nomeado. O exemplo da seção 5 faz isso com var p Ponto = struct{ X, Y int }{1, 2}, e ele compila.
O limite prático é a legibilidade. Se a mesma forma aparece em três funções, dê um nome a ela. Uma struct anônima repetida espalha a definição do dado por vários lugares, e uma mudança num campo exige editar todos eles.
5. Comparação com ==
Duas structs do mesmo tipo podem ser comparadas com == e !=, e a comparação é campo a campo. Ela só é permitida se todos os campos forem comparáveis. Inteiros, floats, booleanos, strings, ponteiros, canais, arrays de elementos comparáveis e structs formadas só por esses tipos são comparáveis. Slices, maps e funções não são, e uma struct que contém um deles também não é.
O programa abaixo mostra a comparação, a atribuição para tipo anônimo e o uso de uma struct como chave de map.
package main

import "fmt"

type Ponto struct {
	X, Y int
}

type Chave struct {
	Org int
	Rec string
}

func main() {
	// struct anônima para um escopo pequeno
	config := struct {
		Host  string
		Porta int
	}{Host: "localhost", Porta: 8080}
	fmt.Printf("config: %+v\n", config)

	// tipo anônimo com campos idênticos pode ser atribuído ao tipo nomeado
	var p Ponto = struct{ X, Y int }{1, 2}
	fmt.Printf("p: %+v\n", p)

	// comparação com ==
	a := Ponto{1, 2}
	b := Ponto{X: 1, Y: 2}
	c := Ponto{X: 1}
	fmt.Println("a == b:", a == b)
	fmt.Println("a == c:", a == c)

	// struct como chave de map
	tabela := map[Chave]string{}
	tabela[Chave{Org: 10, Rec: "doc-abc"}] = "leitura"
	fmt.Println("consulta:", tabela[Chave{Org: 10, Rec: "doc-abc"}])
	fmt.Println("ausente:", tabela[Chave{Org: 11, Rec: "doc-abc"}] == "")
}
config: {Host:localhost Porta:8080}
p: {X:1 Y:2}
a == b: true
a == c: false
consulta: leitura
ausente: trueA comparação a == c dá false porque c tem Y zero e a tem Y igual a 2. Campos omitidos no literal nomeado recebem o valor zero, e a comparação enxerga isso.
O uso de struct como chave de map merece atenção. A chave é comparada pelo valor, então duas structs com os mesmos campos acessam a mesma entrada. Isso evita montar chaves compostas por concatenação de strings, como fmt.Sprintf("%d:%s", org, rec), que são frágeis porque um separador mal escolhido pode colidir com o próprio conteúdo.
Quando um campo não é comparável, o compilador avisa antes de o programa rodar:
package main

import "fmt"

type Pedido struct {
	ID    int
	Itens []string
}

func main() {
	p1 := Pedido{ID: 1, Itens: []string{"Teclado"}}
	p2 := Pedido{ID: 1, Itens: []string{"Teclado"}}
	fmt.Println(p1 == p2)
}
# command-line-arguments
./main.go:13:14: invalid operation: p1 == p2 (struct containing []string cannot be compared)A mensagem diz o motivo, que é o slice dentro da struct. Se você precisar comparar esses pedidos, escreva a comparação campo a campo, comparando ID e depois cada item de Itens em um laço. Tentar contornar o erro com outra forma de comparação costuma esconder a intenção de quem escreveu o código.
6. Embedding: composição, não herança
Go não tem herança, mas tem embedding. Quando você declara um tipo dentro de uma struct sem dar um nome ao campo, a struct externa recebe os campos e os métodos do tipo interno como se fossem seus. Essa relação é de composição: Empresa tem um Endereco, e não é um Endereco. A diferença importa porque a composição não cria uma hierarquia de tipos. Um Empresa não passa a ser aceito em todo lugar que espera um Endereco.
Um detalhe sutil separa embedding de herança. Quando um método de Endereco é chamado através de Empresa, ele recebe o Endereco como receptor, e não a Empresa. Ele não tem como saber que está dentro de outra struct. Isso dá previsibilidade, mas também significa que não existe sobrescrita por herança: se a struct externa quer um comportamento diferente, ela precisa declarar o próprio método.
O programa abaixo tem três casos. Empresa embute Endereco, Produto embute Base e declara um campo ID com o mesmo nome do campo de Base, e Servico embute um Logger.
package main

import "fmt"

type Endereco struct {
	Cidade string
	Estado string
}

func (e Endereco) Formatado() string {
	return fmt.Sprintf("%s/%s", e.Cidade, e.Estado)
}

type Empresa struct {
	RazaoSocial string
	Endereco
}

type Base struct {
	ID int
}

func (b Base) Descrever() string {
	return fmt.Sprintf("Base ID: %d", b.ID)
}

type Produto struct {
	Base
	ID int
}

func (p Produto) Descrever() string {
	return fmt.Sprintf("Produto ID: %d (Base interna ID: %d)", p.ID, p.Base.ID)
}

type Logger struct{ Prefixo string }

func (l Logger) Log(msg string) { fmt.Println(l.Prefixo + msg) }

type Servico struct {
	Logger
	Nome string
}

func main() {
	emp := Empresa{RazaoSocial: "Tecnologia Brasil LTDA", Endereco: Endereco{Cidade: "São Paulo", Estado: "SP"}}
	fmt.Println("promovido:", emp.Cidade, "| explícito:", emp.Endereco.Estado)
	fmt.Println("método promovido:", emp.Formatado())

	prod := Produto{Base: Base{ID: 100}, ID: 999}
	fmt.Println(prod.Descrever())
	fmt.Println(prod.Base.Descrever())
	fmt.Println("prod.ID:", prod.ID, "prod.Base.ID:", prod.Base.ID)

	svc := Servico{Logger: Logger{Prefixo: "[API] "}, Nome: "Auth"}
	svc.Log("token gerado")
}
promovido: São Paulo | explícito: SP
método promovido: São Paulo/SP
Produto ID: 999 (Base interna ID: 100)
Base ID: 100
prod.ID: 999 prod.Base.ID: 100
[API] token geradoPromoção de campos e métodos
A promoção é o que torna emp.Cidade válido, mesmo que Cidade esteja dentro de Endereco. O compilador procura o nome seguindo a profundidade dos embeddings. A especificação define a regra assim: x.f denota o campo ou método na menor profundidade de T onde existe um f, e, se não houver exatamente um f nessa profundidade, o seletor é ilegal.
Esse é o motivo pelo qual o acesso promovido é seguro na maior parte dos casos. Um campo do próprio tipo externo sempre está na profundidade zero, e vence qualquer campo embutido com o mesmo nome. Quem lê emp.Cidade sabe que está acessando um campo de Endereco só porque conhece o embedding, e a leitura do código não precisa de nada além disso.
O literal com campo promovido também funciona. Desde o Go 1.27 a especificação aceita chaves que nomeiam um campo promovido, e isso aparece no literal Empresa{..., Cidade: "São Paulo", Estado: "SP"}. A especificação marca essa regra como [Go 1.27]. Em versões anteriores, o literal precisava nomear o tipo embutido, como em Endereco: Endereco{...}. Essa diferença não foi testada aqui com uma toolchain anterior à 1.27.
package main

import "fmt"

type Endereco struct {
	Cidade string
	Estado string
}

type Empresa struct {
	RazaoSocial string
	Endereco
}

type Object struct{ name, color string }
type Point3D struct {
	Object
	x, y, z float64
}
type Line struct {
	Object
	p, q Point3D
}

func main() {
	e := Empresa{RazaoSocial: "Tecnologia Brasil LTDA", Cidade: "São Paulo", Estado: "SP"}
	fmt.Printf("%+v\n", e)
	l := Line{name: "diagonal", q: Point3D{x: 1, y: 1, z: 1}}
	fmt.Printf("%+v\n", l)
}
{RazaoSocial:Tecnologia Brasil LTDA Endereco:{Cidade:São Paulo Estado:SP}}
{Object:{name:diagonal color:} p:{Object:{name: color:} x:0 y:0 z:0} q:{Object:{name: color:} x:1 y:1 z:1}}A regra tem um limite. Uma chave não pode nomear um campo que já foi nomeado por outra chave, quando os dois estão dentro do mesmo embedding. O literal Line{Object: obj, name: "diagonal"} é recusado com a mensagem cannot specify promoted field name and enclosing embedded field Object, porque name mora dentro de Object, que já foi preenchido.
Quando a struct externa declara um campo com o mesmo nome de um campo promovido, ela sombreia o campo interno. No exemplo, Produto tem ID, e Base também tem. prod.ID devolve 999, o campo do próprio Produto. Para chegar ao ID de Base, é preciso escrever o caminho completo, prod.Base.ID, que devolve 100. O mesmo vale para métodos: prod.Descrever() chama o método de Produto, e prod.Base.Descrever() chama o de Base.
A figura abaixo mostra essas quatro expressões e para onde cada uma aponta. Os elementos em rosa são os que estão na frente, e os verdes são os que só são alcançados pelo caminho explícito.
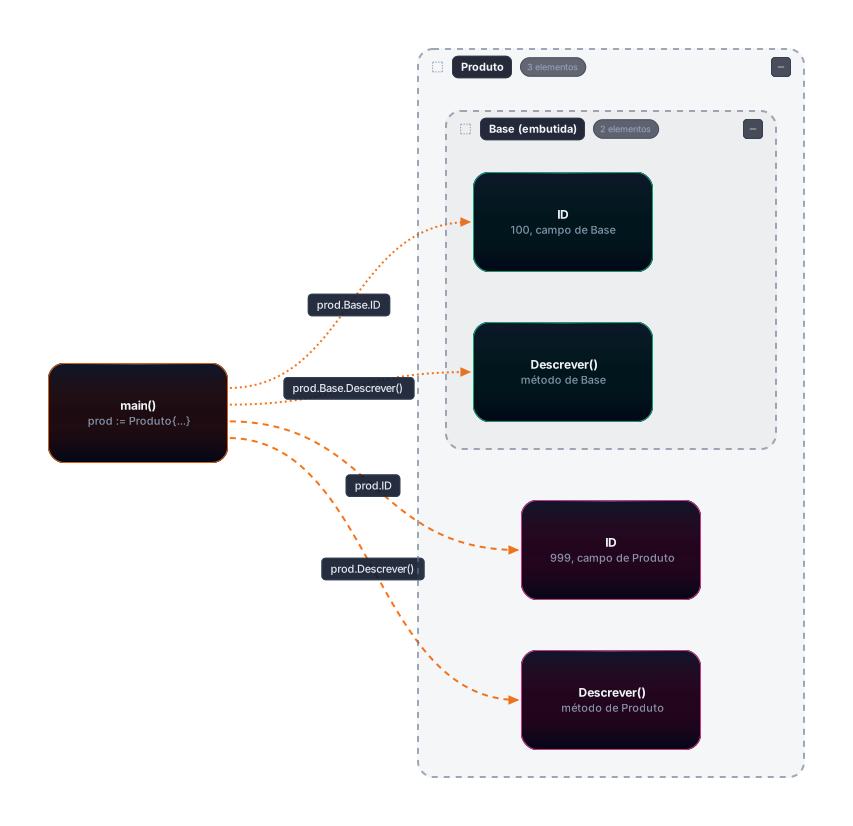
A figura mostra a regra de profundidade. A seta de prod.ID cai direto no campo de Produto, sem passar por Base, porque ele está na profundidade zero. As setas de prod.Base.ID e prod.Base.Descrever() precisam atravessar o grupo Base porque o nome está um nível abaixo. O sombreamento não apaga o campo interno: ele continua existindo e acessível, só que pelo caminho explícito.
Ambiguidade
Quando dois tipos embutidos têm um campo com o mesmo nome, e nenhum deles está mais perto da struct externa, a seleção fica ambígua. O compilador só reclama quando esse nome é usado. Declarar a struct é permitido, e acessar cada campo pelo tipo embutido também:
package main

import "fmt"

type A struct{ ID int }
type B struct{ ID int }

type C struct {
	A
	B
}

func main() {
	c := C{A: A{ID: 1}, B: B{ID: 2}}
	fmt.Println(c.ID)
}
# command-line-arguments
./main.go:15:16: ambiguous selector c.IDSe você remover a última linha e usar c.A.ID e c.B.ID, o programa compila e imprime c.A.ID: 1 c.B.ID: 2. A ambiguidade aparece no uso, e não na declaração, o que é uma boa notícia: o erro fica perto da linha que o causou.
Receptor de ponteiro e
Esta é a armadilha que mais surpreende quem chega de outras linguagens. Um método com pertence ao conjunto de métodos de *T, e não ao de T. Quando a struct externa embute T por valor, o conjunto de métodos da struct externa, sem ponteiro, também não contém o método. Isso só importa quando você tenta usar a struct como interface.
package main

import "fmt"

type Contador struct{ n int }

func (c *Contador) Incrementar() { c.n++ }

type Wrapper struct {
	Contador
}

type Incrementador interface {
	Incrementar()
}

func main() {
	var w Wrapper
	w.Incrementar()
	fmt.Println("n:", w.n)

	var i Incrementador
	i = &w
	i.Incrementar()
	fmt.Println("via interface com ponteiro:", w.n)
}
n: 1
via interface com ponteiro: 2A chamada w.Incrementar() funciona porque w é uma variável endereçável, e o compilador toma o endereço dela automaticamente. A atribuição i = &w também compila. Se você acrescentar a linha var v Incrementador = w, o compilador recusa:
cannot use w (variable of struct type Wrapper) as Incrementador value in variable declaration: Wrapper does not implement Incrementador (method Incrementar has pointer receiver)A regra é que a interface só aceita o valor Wrapper se o método estiver no conjunto de métodos de Wrapper, e o método tem receptor de ponteiro. Para que a interface funcione, é preciso passar &w. A mesma lógica explica por que muitas implementações de interface em Go usam ponteiros como receptor: o estado precisa ser alterado, e o conjunto de métodos fica consistente quando todos os métodos usam ponteiro.
7. Tags
Tags são metadados escritos entre crases depois do tipo de um campo. Elas não mudam o comportamento da struct por si. Um pacote como encoding/json ou um ORM lê a tag em tempo de execução, com reflexão, e decide o que fazer com o campo. O formato convencional é uma sequência de pares chave:"valor", separados por espaço, e a documentação de reflect.StructTag diz isso sem ambiguidade.
package main

import (
	"encoding/json"
	"fmt"
	"reflect"
)

type UsuarioDTO struct {
	ID        int64  `json:"id" db:"user_id"`
	Nome      string `json:"nome_completo" db:"full_name"`
	SenhaHash string `json:"-" db:"password_hash"`
	codigo    int    `json:"codigo"`
}

func main() {
	u := UsuarioDTO{ID: 7, Nome: "Ana", SenhaHash: "segredo", codigo: 42}

	saida, _ := json.Marshal(u)
	fmt.Println("json:", string(saida))

	t := reflect.TypeOf(u)
	campo, _ := t.FieldByName("ID")
	fmt.Println("tag json:", campo.Tag.Get("json"), "| tag db:", campo.Tag.Get("db"))
	campoPriv, _ := t.FieldByName("codigo")
	fmt.Println("não exportado, tag json:", campoPriv.Tag.Get("json"))
	fmt.Printf("%+v\n", u)
}
json: {"id":7,"nome_completo":"Ana"}
tag json: id | tag db: user_id
não exportado, tag json: codigo
{ID:7 Nome:Ana SenhaHash:segredo codigo:42}Três coisas aparecem na saída. A tag json:"id" define o nome do campo no JSON. A tag json:"-" faz o campo SenhaHash sumir da serialização. E o campo codigo, que tem tag mas não é exportado, não aparece no JSON, mesmo com a tag escrita. A tag é lida com Tag.Get, que devolve o valor da chave pedida, e a reflexão enxerga o , mas o json não o serializa porque não pode ser acessado de fora do pacote.
Os detalhes das tags, como omitempty, string e a combinação com outros pacotes, ficam na aula de Tags. Aqui basta saber que a tag é metadado lido em tempo de execução e que a exportação do campo decide se a leitura faz efeito.
Pergunta de entrevistaEmbedding é herança em Go?
Não. Embedding é composição: o tipo externo ganha os campos e métodos do interno por promoção, mas não vira subtipo. Uma struct que embute outra não pode ser usada onde se espera o tipo embutido. Se eu sobrescrevo um método no tipo externo, ele usa a versão própria, mas quem recebe o tipo interno não é afetado. Uso embedding para reaproveitar comportamento de forma explícita, e interface quando preciso de polimorfismo.
8. Ponteiro para struct e acesso automático
Um ponteiro para struct guarda o endereço de uma struct. Em Go, você cria um ponteiro com & e acessa campos com a mesma sintaxe de um valor. Para p := &Pessoa{...}, p.Nome funciona, mesmo sendo p um ponteiro. Quem está por trás disso é uma regra de seleção da especificação: se x é um ponteiro para um tipo nomeado e (*x).f é um campo válido, então x.f é atalho para (*x).f. O compilador faz a desreferência por você.
Isso não é só conveniência de digitação. Métodos com receptor de ponteiro dependem da mesma regra: o método recebe o endereço, altera o campo original e não uma cópia. O programa abaixo mostra as duas formas de acesso, a alteração por método e a diferença entre ponteiro e valor.
package main

import (
	"fmt"
	"unsafe"
)

type Pessoa struct {
	Nome  string
	Idade int
}

func (p *Pessoa) Envelhecer() {
	p.Idade++
}

func main() {
	p := &Pessoa{Nome: "Ana", Idade: 30}
	fmt.Println("acesso automático:", p.Nome)
	fmt.Println("forma explícita:", (*p).Nome)
	p.Envelhecer()
	fmt.Println("depois de Envelhecer:", p.Idade)

	v := Pessoa{Nome: "Bia", Idade: 20}
	v.Envelhecer()
	fmt.Println("valor endereçável também chama:", v.Idade)

	fmt.Printf("tipo de p: %T, ponteiro: %d bytes, struct: %d bytes\n", p, unsafe.Sizeof(p), unsafe.Sizeof(*p))
}
acesso automático: Ana
forma explícita: Ana
depois de Envelhecer: 31
valor endereçável também chama: 21
tipo de p: *main.Pessoa, ponteiro: 8 bytes, struct: 24 bytesO ponteiro ocupa 8 bytes em uma arquitetura de 64 bits, enquanto a struct ocupa 24. Passar p para uma função copia esses 8 bytes, e passar *p copia os 24. Isso conecta a seção com a seção 9.
Tudo isso depende de o ponteiro não ser nil. O atalho não cria a struct: se o ponteiro estiver vazio, o acesso a um campo causa um pânico em tempo de execução.
package main

import "fmt"

type Pessoa struct {
	Nome  string
	Idade int
}

func main() {
	var nulo *Pessoa
	fmt.Println("nulo == nil:", nulo == nil)
	fmt.Println(nulo.Nome)
}
nulo == nil: true
panic: runtime error: invalid memory address or nil pointer dereference
[signal SIGSEGV: segmentation violation code=0x2 addr=0x0 pc=0x104ebb5a8]A primeira linha do pânico é a que interessa para diagnóstico. A segunda e as seguintes trazem o endereço e o rastro, que mudam a cada execução. A figura a seguir mostra o caminho que o acesso percorre: a variável guarda o endereço, e o campo é lido na struct que mora no heap.
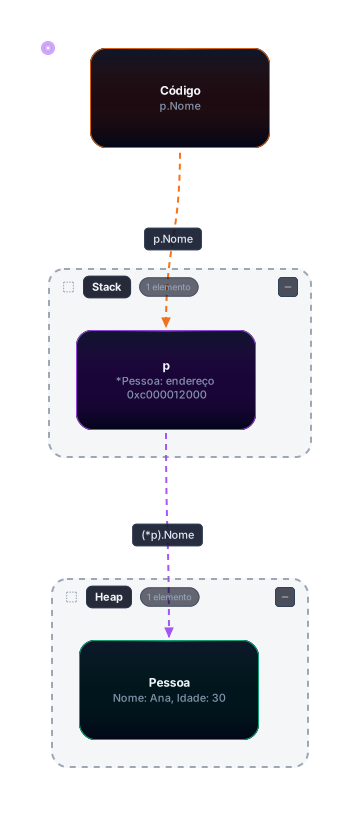
A figura mostra o que o atalho esconde. O código escreve p.Nome, mas o caminho real passa pela variável p, que guarda um endereço, e depois pela struct que mora em outra região da memória. O compilador escreve (*p).Nome para você, e a seta com o rótulo (*p).Nome é esse passo intermediário. Se o endereço estiver vazio, o passo intermediário falha, e é por isso que o pânico acontece no acesso ao campo e não na criação do ponteiro.
9. Cópia por valor e seus custos
Em Go, atribuir uma struct a outra variável, passá-la para uma função ou devolvê-la de uma função copia o valor inteiro. A cópia percorre todos os campos, e para uma struct grande o custo cresce com o tamanho. Esse custo é a razão pela qual a escolha entre valor e ponteiro importa, e a própria cópia traz uma armadilha quando a struct contém ponteiros, slices, maps ou um mutex.
Uma cópia de struct é superficial: ela duplica os campos da struct, mas não os dados para onde os campos apontam. Um campo do tipo slice é um cabeçalho com ponteiro, comprimento e capacidade. Quando você copia a struct, o cabeçalho é copiado, e o ponteiro passa a apontar para o mesmo array.
package main

import "fmt"

type Pedido struct {
	ID    int
	Itens []string
}

func main() {
	p1 := Pedido{ID: 1, Itens: []string{"Teclado", "Mouse"}}
	p2 := p1
	p2.ID = 2
	p2.Itens[0] = "Monitor UltraWide"
	fmt.Printf("p1: ID %d, Itens: %v\n", p1.ID, p1.Itens)
	fmt.Printf("p2: ID %d, Itens: %v\n", p2.ID, p2.Itens)
}
p1: ID 1, Itens: [Monitor UltraWide Mouse]
p2: ID 2, Itens: [Monitor UltraWide Mouse]O ID de p2 mudou sem afetar p1, porque é um inteiro copiado. Mas a alteração em p2.Itens[0] apareceu em p1, porque os dois slices apontam para o mesmo array. A struct foi copiada, o array não. A figura abaixo mostra as duas structs na stack e o array no heap.
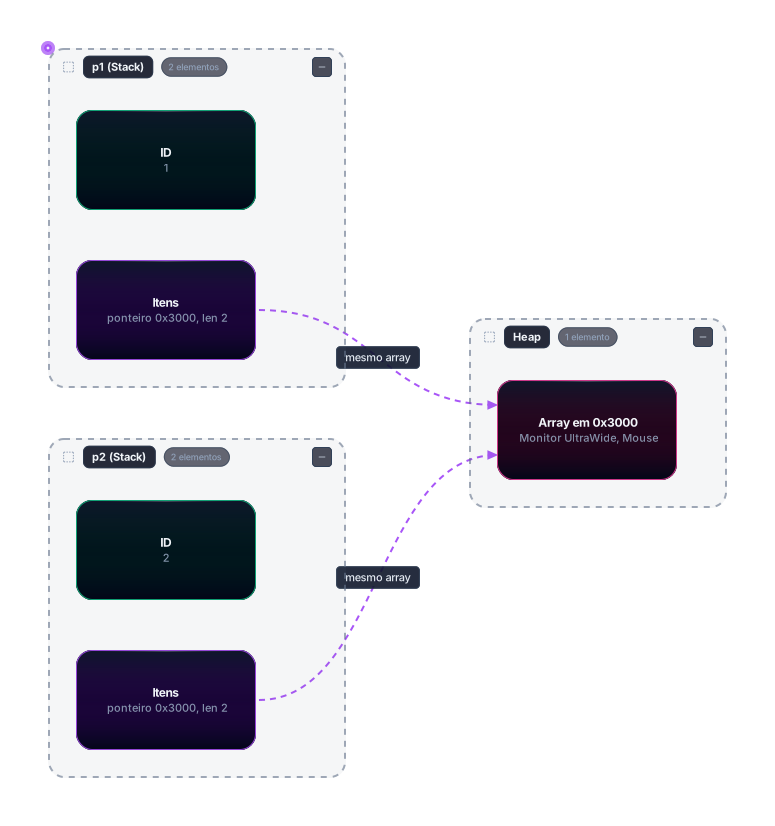
Quando você precisa de isolamento total, precisa copiar o array também, com uma função de cópia profunda que aloque um slice novo e use copy. A escolha de quando fazer isso depende do uso: copiar tudo a cada chamada pode custar mais do que o problema que você está evitando.
Mutex dentro de struct
Um sync.Mutex dentro de uma struct é um valor com estado: ele sabe se está travado. Copiar a struct copia esse estado. Uma função que recebe a struct por valor trabalha com uma cópia independente do mutex, e a trava que ela adquire não protege nada do original. É como fazer uma cópia da chave do banheiro da firma: a cópia abre a porta, mas a fila de verdade continua esperando a chave original, que ninguém tocou.
package main

import (
	"fmt"
	"sync"
)

type RepositorioMemoria struct {
	mu    sync.Mutex
	dados map[string]string
}

func Atualizar(r RepositorioMemoria, chave, valor string) {
	r.mu.Lock()
	defer r.mu.Unlock()
	r.dados[chave] = valor
}

func main() {
	r := RepositorioMemoria{dados: map[string]string{}}
	Atualizar(r, "k", "v")
	fmt.Println(r.dados)
}map[k:v]O programa roda sem reclamar, e esse é o perigo: a cópia do mutex não aparece na saída. Quem avisa é o go vet, que a gente roda com go vet main.go e que responde:
main.go:13:18: Atualizar passes lock by value: command-line-arguments.RepositorioMemoria contains sync.Mutex
main.go:21:12: call of Atualizar copies lock value: command-line-arguments.RepositorioMemoria contains sync.Mutex
Esses avisos vêm da verificação copylocks, e ela deve estar ligada no editor e nos testes. O erro só se manifesta de verdade quando duas goroutines escrevem no mapa ao mesmo tempo, o que pode não acontecer num teste simples. A correção é passar um ponteiro para o repositório, como na solução do exercício 3.
Quanto custa copiar
A cópia de uma struct tem custo proporcional ao número de bytes copiados. Uma struct pequena, como um ponto com dois inteiros, é copiada em poucos ciclos e não vale a pena pensar nisso. Uma struct com dezenas de campos ou com um array grande muda a conta. O exemplo a seguir cria uma struct com um array de 128 inteiros de 64 bits e passa a mesma struct por valor e por ponteiro. Os //go:noinline impedem o compilador de embutir as funções, o que tornaria a comparação injusta.
package main

import (
	"fmt"
	"unsafe"
)

type Grande struct {
	Dados [128]int64
}

//go:noinline
func somaPorValor(g Grande) int64 {
	return g.Dados[0] + g.Dados[127]
}

//go:noinline
func somaPorPonteiro(g *Grande) int64 {
	return g.Dados[0] + g.Dados[127]
}

func main() {
	var g Grande
	fmt.Println("tamanho de Grande:", unsafe.Sizeof(g), "bytes")
	g.Dados[0] = 1
	g.Dados[127] = 2
	fmt.Println(somaPorValor(g), somaPorPonteiro(&g))
}
tamanho de Grande: 1024 bytes
3 3A struct tem 1024 bytes, e as duas funções devolvem o mesmo resultado. Para medir a diferença, usei um benchmark com as mesmas funções, rodado três vezes com go test -bench . -benchmem -count 3 na máquina Apple M1 Max, em darwin/arm64, com go1.27.2, em 2026-11-03:
| Chamada | Rodada 1 | Rodada 2 | Rodada 3 | Alocações |
|---|---|---|---|---|
somaPorValor (copia 1024 bytes) | 32,59 ns/op | 31,96 ns/op | 31,96 ns/op | 0 |
somaPorPonteiro (copia 8 bytes) | 2,27 ns/op | 2,29 ns/op | 2,66 ns/op | 0 |
A diferença é de cerca de dez vezes nesta máquina, e nenhuma das duas chamadas aloca memória. Esses números medem uma chamada isolada, em um tipo específico, em uma arquitetura específica. Eles não dizem quanto o seu programa vai ganhar ou perder. Para decidir com base em medição, meça o caminho real do seu código com um benchmark que se pareça com o uso de produção.
Como regra prática, o ponteiro é a escolha segura quando a struct é grande, quando a função precisa alterar o original, ou quando a struct contém um mutex. Um valor pequeno e imutável, como uma coordenada ou um valor monetário, costuma ficar melhor por valor. A figura a seguir resume essa decisão.
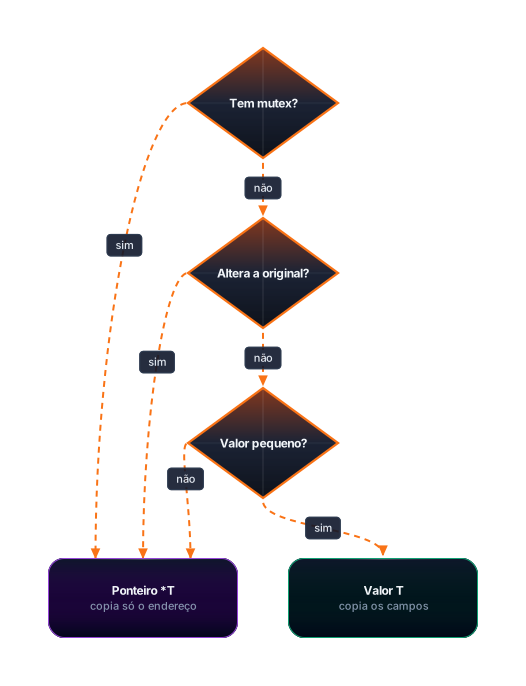
A árvore começa pelas restrições, que são as que não admitem exceção. Se a struct tem um mutex ou outro campo que não pode ser copiado, a resposta é ponteiro, e a pergunta sobre tamanho nem chega a ser feita. Se a função precisa alterar a original, também é ponteiro. Só depois dessas duas perguntas entra a questão do tamanho. Essa ordem evita o erro comum de otimizar por valor uma struct que precisava ser compartilhada.
10. Alinhamento e padding no tamanho
O tamanho de uma struct não é necessariamente a soma dos tamanhos dos campos. O processador lê a memória com mais eficiência quando um campo começa num endereço que é múltiplo do próprio tamanho, e o compilador insere bytes de preenchimento, chamados de padding, para garantir isso. A especificação garante um alinhamento mínimo: para uma struct, unsafe.Alignof é o maior alinhamento entre os campos, com pelo menos 1. Os deslocamentos exatos que o compilador escolhe são detalhe da implementação, e unsafe.Offsetof é a forma de consultá-los.
O mecanismo de endereços e a relação entre stack, heap e alinhamento são tratados em detalhe na aula de Ponteiros, Memória e Escape Analysis. Esta seção não depende dela: basta acompanhar o exemplo, que mostra o tamanho e os deslocamentos de duas structs com os mesmos campos em ordens diferentes.
package main

import (
	"fmt"
	"unsafe"
)

type LayoutRuim struct {
	a bool
	b int64
	c bool
}

type LayoutBom struct {
	b int64
	a bool
	c bool
}

func main() {
	fmt.Printf("Tamanho de LayoutRuim: %d bytes\n", unsafe.Sizeof(LayoutRuim{}))
	fmt.Printf("Tamanho de LayoutBom:  %d bytes\n", unsafe.Sizeof(LayoutBom{}))
	var r LayoutRuim
	fmt.Println("Offsets ruim: a", unsafe.Offsetof(r.a), "b", unsafe.Offsetof(r.b), "c", unsafe.Offsetof(r.c))
	var b LayoutBom
	fmt.Println("Offsets bom: b", unsafe.Offsetof(b.b), "a", unsafe.Offsetof(b.a), "c", unsafe.Offsetof(b.c))
	fmt.Println("Alignof LayoutRuim:", unsafe.Alignof(r), "Alignof b.b:", unsafe.Alignof(b.b))
}
Tamanho de LayoutRuim: 24 bytes
Tamanho de LayoutBom: 16 bytes
Offsets ruim: a 0 b 8 c 16
Offsets bom: b 0 a 8 c 9
Alignof LayoutRuim: 8 Alignof b.b: 8Os dois layouts guardam os mesmos dados: dois booleanos e um inteiro de 64 bits. No layout ruim, a ocupa o byte 0, e o int64 só pode começar no byte 8, então sete bytes ficam vazios entre os dois. Depois de c, no byte 16, a struct precisa terminar em um múltiplo de 8, o que adiciona mais sete bytes. São 24 bytes para 10 de dados. No layout bom, o int64 vem primeiro, em 0, e os booleanos ocupam os bytes 8 e 9. Sobram seis bytes no fim, e a struct tem 16.
A figura reproduz essa conta com uma escala de 30 pixels por byte, para que a largura de cada caixa seja proporcional ao espaço que o campo ocupa. As caixas em rosa são o padding.
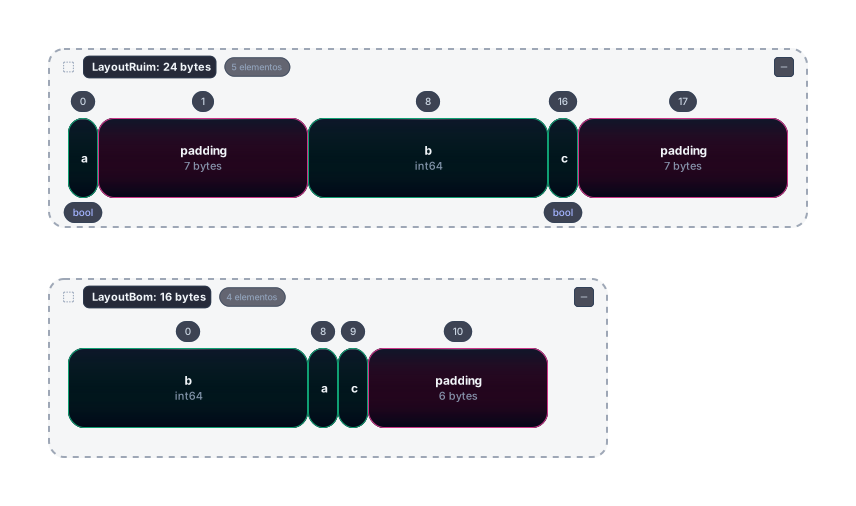
A figura mostra onde o desperdício acontece. No layout ruim, os dois blocos rosa somam 14 bytes que não guardam dado nenhum. No layout bom, o bloco rosa final tem seis bytes, e ele existe porque o tamanho da struct precisa ser múltiplo do maior alinhamento dos campos. Os números em cima de cada caixa são os deslocamentos, e eles batem com os que o unsafe.Offsetof devolveu.
Para campos escalares, ordenar do maior para o menor costuma eliminar o padding interno, e esse é o motivo do conselho que circula em muitos guias. Essa regra não garante o menor tamanho em todos os casos, porque campos com alinhamento menor no fim ainda geram padding de arredondamento, e o resultado depende da arquitetura. Quando o tamanho importa de verdade, meça com unsafe.Sizeof na arquitetura de produção, como no exercício 1.
11. Erros comuns e boas práticas
Todo mundo esquece um lock de mutex pelo menos uma vez, e quem diz que nunca esqueceu ainda não usou struct com concorrência por tempo suficiente. A cópia de struct com mutex é o erro mais caro desta aula, porque o compilador aceita o código e só o go vet avisa. Ligue o go vet no editor e nos testes, e passe structs com lock sempre por ponteiro.
Comparar structs com slices, maps ou funções também parece inofensivo até o compilador responder. A correção é escrever a comparação campo a campo, que deixa explícito o que conta como igualdade para aquele tipo. Tentar contornar com outra forma de comparação costuma esconder um problema de modelagem.
Guardar segredo em campo não exportado é uma proteção que não protege. O pacote de fora não consegue ler o campo, mas fmt lê, e um %+v num log expõe o valor. Dados sensíveis precisam de cuidado no próprio uso, e não só de visibilidade.
Ponteiro nil em struct é um erro previsível que só aparece em produção quando ninguém checou a origem do ponteiro. Quando uma função pode devolver nil, documente isso e verifique antes de acessar campos. O pânico da seção 8 é o sintoma mais comum desse caso.
Embedding usado como herança é o anti-padrão mais comum de quem chega de Java ou C#. Uma cadeia de três ou quatro níveis de embedding faz os campos aparecerem de lugares distantes e torna difícil saber de onde vem cada valor. Prefira structs rasas, com campos declarados perto de onde são usados, e interfaces pequenas para o comportamento. Quando o embedding fizer a leitura parecer um quebra-cabeça, troque por um campo nomeado.
Literais posicionais em structs de negócio são outro convite a problemas. Eles funcionam até o dia em que um campo novo entra no meio da declaração, e nesse dia o código quebra em todos os lugares que usam o literal. Use o literal nomeado, que sobrevive a mudanças.
12. Exercícios
Os exercícios usam o que a aula ensinou. As soluções abaixo foram rodadas com go1.27.2, e cada uma inclui a saída. Tente resolver antes de olhar a solução.
Exercício 1: alinhamento e medição
Objetivo: meça o tamanho da struct abaixo com unsafe.Sizeof, reordene os campos para reduzir o tamanho em uma arquitetura de 64 bits e calcule a economia em porcentagem.
Solução de referência:
package main

import (
	"fmt"
	"unsafe"
)

type EventoOriginal struct {
	Ativo     bool
	Timestamp int64
	Flag      byte
	Valor     float64
	Status    int32
}

type EventoOtimizado struct {
	Timestamp int64
	Valor     float64
	Status    int32
	Ativo     bool
	Flag      byte
}

func main() {
	tamOriginal := unsafe.Sizeof(EventoOriginal{})
	tamOtimizado := unsafe.Sizeof(EventoOtimizado{})
	fmt.Printf("Tamanho Original:  %d bytes\n", tamOriginal)
	fmt.Printf("Tamanho Otimizado: %d bytes\n", tamOtimizado)
	fmt.Printf("Economia alcançada: %.2f%%\n", float64(tamOriginal-tamOtimizado)/float64(tamOriginal)*100)
}
Tamanho Original: 40 bytes
Tamanho Otimizado: 24 bytes
Economia alcançada: 40.00%A struct original tem 40 bytes, e não 32. Os campos somam 22 bytes, e o padding entre Ativo e Timestamp, entre Flag e Valor e no fim da struct leva o total a 40. A versão reordenada ocupa 24, uma economia de 40%.
Exercício 2: composição com sombreamento
Objetivo: crie uma struct Logger com o método Log(msg string). Embuta Logger em ServicoAPI. Implemente um método Log próprio em ServicoAPI que formate a mensagem com o nome do serviço e chame explicitamente o Log do embutido.
Solução de referência:
package main

import "fmt"

type Logger struct{}

func (l Logger) Log(msg string) {
	fmt.Printf("[Nível Base]: %s\n", msg)
}

type ServicoAPI struct {
	Logger
	Nome string
}

func (s ServicoAPI) Log(msg string) {
	mensagemFormatada := fmt.Sprintf("[%s]: %s", s.Nome, msg)
	s.Logger.Log(mensagemFormatada)
}

func main() {
	svc := ServicoAPI{Nome: "Autenticacao"}
	svc.Log("Token JWT gerado com sucesso")
}
[Nível Base]: [Autenticacao]: Token JWT gerado com sucessoO método de ServicoAPI sombreia o de Logger, e a chamada s.Logger.Log escolhe explicitamente o caminho interno. Sem essa chamada explícita, o Log de Logger não seria acessível pela struct externa, porque o nome estaria sombreado.
Exercício 3: corrigir a cópia de um mutex
Objetivo: o código abaixo passa o repositório por valor e copia o mutex. Corrija a função para que ela altere o repositório original e o go vet não emita avisos.
package main

import (
	"fmt"
	"sync"
)

type RepositorioMemoria struct {
	mu    sync.Mutex
	dados map[string]string
}

func Atualizar(r RepositorioMemoria, chave, valor string) {
	r.mu.Lock()
	defer r.mu.Unlock()
	r.dados[chave] = valor
}

func main() {
	r := RepositorioMemoria{dados: map[string]string{}}
	Atualizar(r, "k", "v")
	fmt.Println(r.dados)
}
Solução de referência: passar um ponteiro para o repositório, para que o lock e os dados sejam os do original.
package main

import (
	"fmt"
	"sync"
)

type RepositorioMemoria struct {
	mu    sync.Mutex
	dados map[string]string
}

func Atualizar(r *RepositorioMemoria, chave, valor string) {
	r.mu.Lock()
	defer r.mu.Unlock()
	r.dados[chave] = valor
}

func main() {
	r := &RepositorioMemoria{dados: map[string]string{}}
	Atualizar(r, "k", "v")
	fmt.Println(r.dados)
}map[k:v]O go vet não emite avisos para esta versão. A única mudança necessária é o * no parâmetro e o & na criação, e o restante do código permanece igual.
13. O que não foi confirmado
Alguns pontos desta aula não foram verificados nesta revisão, e a lista abaixo diz quais são.
- O layout foi medido apenas em darwin/arm64, com
go1.27.2. Os deslocamentos e tamanhos em amd64 e em 386 não foram rodados aqui. Em particular, o alinhamento deint64em 386 pode ser diferente do que aparece nesta aula, e eu não confirmei isso. - O comportamento do literal com campo promovido foi testado apenas no Go 1.27.2. Não testei com uma toolchain anterior, e por isso a afirmação sobre versões antigas se baseia na marcação
[Go 1.27]da especificação. - Os números do benchmark são de uma máquina e de uma rodada de três execuções. Eles mostram a ordem de grandeza nessa máquina, e não um valor universal.
- A regra de ordenação do maior para o menor, na seção 10, é um guia prático, e não uma garantia de tamanho mínimo para toda combinação de campos e arquiteturas.
- O risco de corrida que a cópia do mutex pode causar foi descrito pelo princípio do lock copiado, mas não reproduzi uma corrida de escrita no mapa nesta revisão. O aviso do
go vetfoi verificado.
14. Glossário
- Struct: tipo composto que agrupa campos nomeados, cada um com um tipo, sob um único nome.
- Campo: parte de uma struct, identificada por um nome e um tipo.
- Literal composto: expressão que cria um valor de struct, com os campos entre chaves.
- Valor zero: valor padrão de um tipo quando nenhuma inicialização é dada, como
""para string,0para número efalsepara booleano. - Campo exportado: campo cujo nome começa com letra maiúscula, acessível de outros pacotes.
- Campo não exportado: campo cujo nome começa com letra minúscula, acessível apenas dentro do pacote que declara a struct.
- Struct anônima: struct declarada sem nome, geralmente num escopo local, como numa tabela de testes.
- Embedding: inclusão de um tipo dentro de outro sem nome de campo, que dá à struct externa os campos e métodos do tipo interno.
- Promoção: acesso direto a um campo ou método do tipo embutido através da struct externa, sem escrever o nome do embutido.
- Sombreamento: campo ou método da struct externa com o mesmo nome de um campo ou método promovido, que passa a ter prioridade no acesso direto.
- Seletor ambíguo: nome que existe em dois embeddings na mesma profundidade, o que impede o uso direto e gera erro de compilação.
- Conjunto de métodos: conjunto de métodos que um valor de um tipo possui, e que determina se o valor satisfaz uma interface.
- Receptor de ponteiro: método declarado com
*Tcomo receptor, que pode alterar o valor original. - Cópia superficial: cópia que duplica os campos de uma struct, mas não os dados apontados por ponteiros, slices ou maps.
- Padding: bytes de preenchimento inseridos entre campos ou no fim de uma struct para respeitar o alinhamento.
- Alinhamento: exigência de que um valor comece em um endereço múltiplo de certo tamanho, para que o processador leia a memória de forma eficiente.
- Tag de struct: metadado entre crases, depois do tipo do campo, lido em tempo de execução por reflexão.
15. Fontes
Consultadas em 2026-11-03.
- The Go Programming Language Specification, seções sobre struct types, selectors, struct literals, assignability, size and alignment guarantees, e method sets. Versão local do toolchain
go1.27.2, em$(go env GOROOT)/doc/go_spec.html. Página pública: https://go.dev/ref/spec. A página pública pode mostrar uma versão mais recente da linguagem. - Documentação do pacote
unsafe, conferida comgo doc unsafe.Sizeofego doc unsafe.Alignofna toolchaingo1.27.2. Página pública: https://pkg.go.dev/unsafe. - Documentação do pacote
reflect, tipoStructTag, conferida comgo doc reflect.StructTag. Página pública: https://pkg.go.dev/reflect. - Documentação do pacote
encoding/json, sobre campos exportados, conferida comgo doc encoding/jsone confirmada pela execução dos exemplos da seção 3 e da seção 7. Página pública: https://pkg.go.dev/encoding/json. - Ferramenta
go vet, verificaçãocopylocks, conferida pela execução do exemplo da seção 9. Página pública: https://pkg.go.dev/cmd/vet.
Relacionados
- Go
- Trilha de Go
- Tags
- Ponteiros, Memória e Escape Analysis
- Ponteiros
- Anatomia de Slices, Arrays e Maps
- Conversão de tipos
- iota
- Table-Driven Tests e Paralelismo
- sync
- Race Condition
- Módulos, Pacotes e Workspaces
- Controle de Fluxo Idiomático