Hardware e sistemas operacionais · parte 18 de 27
Hierarquia de memória e localidade: por que a CPU passa o tempo esperando dados
Por que existem registradores, caches L1/L2/L3, RAM e SSD, como a velocidade da luz impõe a pirâmide e como a localidade faz a memória parecer rápida e grande.
intermediárioPublicada em · 28 min de leitura
e localidade: por que a CPU passa o tempo esperando dados
Imagine um pesquisador trabalhando em sua escrivaninha. Na mão dele está a caneta e um pequeno bloco de notas imediato (os registradores da CPU, com acesso instantâneo, mas espaço para pouquíssimas linhas). Em cima da mesa, ao alcance dos braços, estão os cadernos e relatórios abertos da tarefa de hoje (o cache da CPU, rápido para consultar, mas com espaço limitado). Na estante do próprio escritório estão centenas de livros organizados (a memória RAM, que exige levantar da cadeira e caminhar alguns passos, mas guarda todo o material do semestre). E no depósito do porão, descendo três lances de escada, ficam os arquivos mortos em caixas de papelão (o SSD e o disco rígido, onde a busca leva minutos, mas cabe a história inteira da biblioteca).
Se esse pesquisador precisasse descer ao porão toda vez que quisesse consultar um número ou uma frase, passaria 99% do seu dia descendo e subindo escadas e 1% produzindo trabalho útil. Nos computadores modernos, essa disparidade brutal entre a velocidade com que a ULA calcula e o tempo que a memória leva para entregar os dados tem um nome: a (memory wall).
Esta aula responde a uma pergunta central da arquitetura de computadores: por que existem tantos níveis diferentes de memória em vez de um único bloco gigante, e como o princípio da localidade faz um sistema composto por memórias lentas parecer tão veloz quanto o seu nível mais rápido. Partimos do que foi visto no ciclo de instrução e na ULA em ULA e registradores e Ciclo de instrução e unidade de controle. Aqui investigamos a viagem que os elétrons fazem da memória principal até os registradores, preparando a base para entender a física dos semicondutores em , e armazenamento e o funcionamento interno do Cache.
Mapa da aula
| Seção | Pergunta que responde |
|---|---|
| 1. O que é a hierarquia e o que é localidade | Por que não existe uma memória única e perfeita? |
| 2. Para que serve | Qual o problema histórico da muralha da memória? |
| 3. Exemplos em contextos diferentes | Onde a localidade decide a velocidade fora do livro de texto? |
| 4. Como funciona a hierarquia por dentro | Quais são os níveis, latências, tamanhos e o fluxo de um hit e um miss? |
| 5. Detalhes e bordas | O que são linhas de cache, arquitetura Harvard modificada e ? |
| 6. Erros comuns e boas práticas | Por que matrizes percorridas por coluna e listas ligadas destroem o desempenho? |
| 7. O programa que mede a localidade | Como medir em nanossegundos o impacto do salto de memória ()? |
| 8. Exercícios | Questões conceituais e de cálculo, com resoluções completas |
| 9. Glossário | Termos técnicos essenciais explicados |
| 10. Fontes | Referências técnicas e bibliografia com datas |
1. O que é a hierarquia e o que é localidade
Uma memória ideal deveria ter três características: capacidade infinita, latência zero (resposta instantânea) e custo zero. As leis da física e da economia dos semicondutores impedem que as três coisas coexistam no mesmo componente.
Se você quer uma memória que responda no mesmo ciclo de clock da CPU (menos de 1 nanossegundo), precisa de circuitos construídos com múltiplos transistores rápidos (SRAM, com 6 transistores por bit). Essa tecnologia consome muita energia, dissipa calor excessivo, ocupa uma área enorme de silício e tem custo de fabricação altíssimo. Por outro lado, se você quer guardar 64 gigabytes de forma barata e densa, precisa de células de um transistor e um capacitor minúsculo (DRAM), que guardam carga elétrica por pouco tempo e exigem recarga constante (refresh), operando a dezenas de nanossegundos de distância.
A figura a seguir resume a clássica pirâmide de memória do hardware. No topo ficam os elementos mais velozes e caros por bit, e na base ficam os componentes de armazenamento em massa.
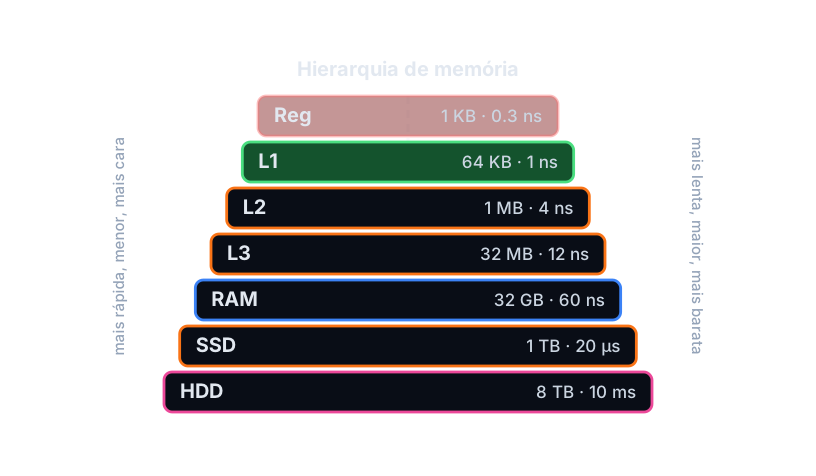
Observe a estrutura da pirâmide: à esquerda, o vetor aponta para cima, indicando onde a memória é mais rápida, consome menos ciclos e tem maior custo por bit. À direita, o vetor aponta para baixo, indicando onde a capacidade se expande em gigabytes e terabytes com custo financeiro acessível. O nível destacado em verde (L1) representa a fronteira crítica onde a maioria esmagadora das leituras da CPU é atendida.
O arranjo só funciona na prática por causa de uma propriedade fundamental do comportamento de quase todo software bem escrito: o princípio da localidade. Os programas não acessam a memória inteira de maneira uniforme e caótica. Em vez disso, concentram seus acessos em pequenas porções do espaço de endereçamento em um dado intervalo de tempo.
A localidade divide-se em duas vertentes:
- : se um endereço de memória foi acessado agora, é muito provável que ele seja acessado novamente em um futuro próximo. Exemplos clássicos são variáveis de controle de laços (
for (i = 0; ...)), acumuladores de soma e o topo da pilha de execução. - : se um endereço de memória foi acessado agora, é muito provável que os endereços imediatamente vizinhos a ele sejam acessados em breve. Exemplos clássicos são vetores percorridos em sequência, campos adjacentes de uma estrutura de dados e as próprias instruções sequenciais do código de máquina.
Ao combinar a pirâmide de memória com a localidade, o computador atinge um objetivo notável: a CPU passa a maior parte do tempo (tipicamente 95% ou mais) encontrando os dados nos níveis superiores rápidos. O sistema parece ter a capacidade gigantesca da memória principal ou do disco, mas com a velocidade média muito próxima à do cache.
2. Para que serve
A hierarquia de memória existe para resolver o maior gargalo de desempenho da computação moderna: a discrepância histórica entre a evolução dos processadores e a evolução das memórias.
Na década de 1980, a CPU e a memória DRAM operavam em velocidades semelhantes. O processador 8086 ou 68000 rodava a poucos megahertz (ciclos de 100 a 200 nanossegundos), e o tempo de acesso da DRAM ficava na mesma ordem de grandeza. A CPU pedia um dado à memória e ele chegava em 1 ou 2 ciclos de clock. Não havia necessidade de múltiplos níveis de cache intermediários.
Ao longo dos trinta anos seguintes, enquanto a velocidade de processamento das CPUs crescia a uma taxa de aproximadamente 55% ao ano (graças à redução do tamanho dos transistores e técnicas de paralelismo em silício), o tempo de acesso da DRAM melhorava a um ritmo tímido de apenas 7% ao ano. A capacidade da DRAM disparou em densidade, mas o tempo necessário para abrir uma linha de memória, ler o capacitor e transferir os bits pelos fios da placa-mãe quase não diminuiu.
O gráfico abaixo ilustra a abertura desse abismo histórico entre o poder de cálculo dos processadores e a velocidade de resposta da memória principal:
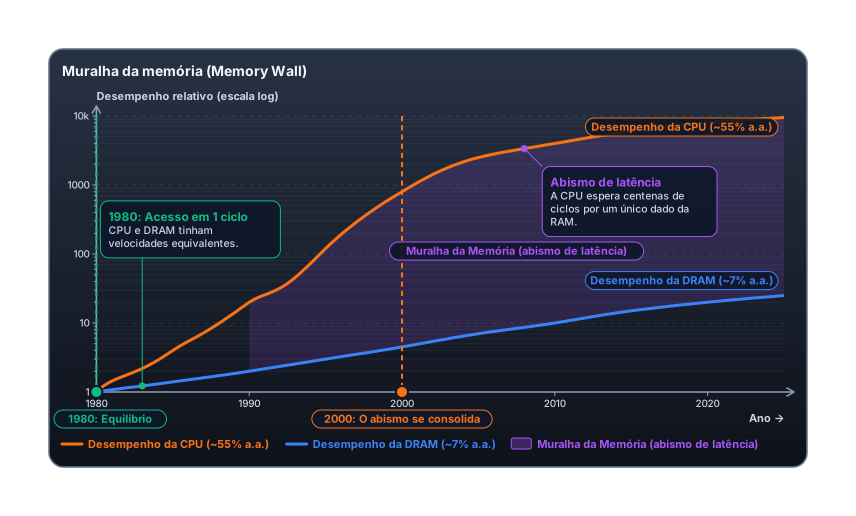
Analise a trajetória das duas curvas: até o início dos anos 1980, as curvas laranja (CPU) e azul (DRAM) partem do mesmo patamar de desempenho relativo. A partir de 1990, a curva da CPU dispara exponencialmente, enquanto a DRAM avança quase em linha reta. A área destacada em roxo representa a muralha da memória: uma distância que ultrapassa três ordens de magnitude. Por volta do ano 2000, essa disparidade tornou o acesso à memória RAM centenas de vezes mais lento do que um ciclo de execução interno da CPU.
A hierarquia de memória serve, portanto, como uma cadeia de amortecedores. Ela intercepta as requisições da CPU nos níveis mais próximos do silício e garante que o núcleo só precise esperar o acesso lento à placa-mãe em casos estritamente indispensáveis.
3. Exemplos em contextos diferentes
A localidade de memória e a hierarquia não são abstrações de laboratório. Elas determinam o comportamento de programas reais em diversos cenários da engenharia de software:
-
Percorrer matrizes bidimensionais em linguagens com armazenamento em linha (row-major), como C, Go, Rust e Python: Uma matriz de números inteiros
matriz[10000][10000]é mapeada na memória como um bloco longo e contínuo de bytes, linha após linha. Quando um algoritmo soma os elementos percorrendo linha por linha (matriz[i][j]), cada salto de índice lê o elemento vizinho na memória (máxima localidade espacial). Quando o mesmo algoritmo inverte os laços e percorre coluna por coluna (matriz[j][i]), cada passo salta 10.000 inteiros (40.000 bytes) à frente. O algoritmo com laço invertido faz a mesma quantidade de somas matemáticas, mas pode rodar de 10 a 30 vezes mais devagar, porque cada leitura resulta em uma falha de cache (cache miss) que exige buscar um novo bloco na RAM. -
A pilha de execução (call stack) e variáveis locais: Quando uma função chama outra função, o ponteiro de pilha (
RSP) desce alguns bytes e empilha o endereço de retorno e as variáveis locais. Enquanto essa função executa, ela lê e escreve repetidamente essas variáveis locais. Por estarem em uma faixa minúscula e contígua de endereços (algumas dezenas ou centenas de bytes), esses dados têm altíssima localidade temporal e espacial, residindo 100% do tempo no cache L1. É por isso que variáveis alocadas na pilha são muito mais eficientes de acessar do que alocações dispersas na heap. -
Varredura sequencial em bancos de dados e sistemas de arquivos: Quando o motor de um banco de dados (como PostgreSQL ou SQLite) faz um sequential scan numa tabela gravada no disco ou SSD, o sistema operacional e a controladora de armazenamento aplicam o conceito de read-ahead (pré-busca). Como há forte localidade espacial, se a aplicação pediu o bloco número 42, o controlador já busca preventivamente os blocos 43 a 50 na memória RAM. Quando a aplicação solicita o bloco seguinte, ele já está na memória principal pronto para entrega.
-
Estruturas orientadas a ponteiros contra vetores contíguos: Uma lista ligada (
LinkedList) clássica armazena nós espalhados pela memória heap, conectados por ponteiros (no->proximo). Cada iteração pela lista exige ler um ponteiro e saltar para um endereço de memória imprevisível, invalidando a localidade espacial. Já um vetor (ArrayouSlice) armazena os elementos colados uns aos outros. Em benchmarks modernos, iterar sobre um vetor de structs contíguas vence uma lista ligada por ordens de magnitude, mesmo que a lista ligada tenha vantagens teóricas de inserção assintótica em $O(1)$.
4. Como funciona a hierarquia por dentro
A figura a seguir detalha a organização física e lógica da hierarquia entre o que está dentro do chip da CPU e o que fica na placa-mãe. No topo, integrados diretamente ao silício de cada núcleo da CPU, ficam os registradores e os caches L1 e L2. No centro do chip, compartilhado por todos os núcleos, fica o cache L3. Fora do chip, conectado através dos canais de memória física, fica a memória principal DDR5, seguida pelas unidades de armazenamento em massa.
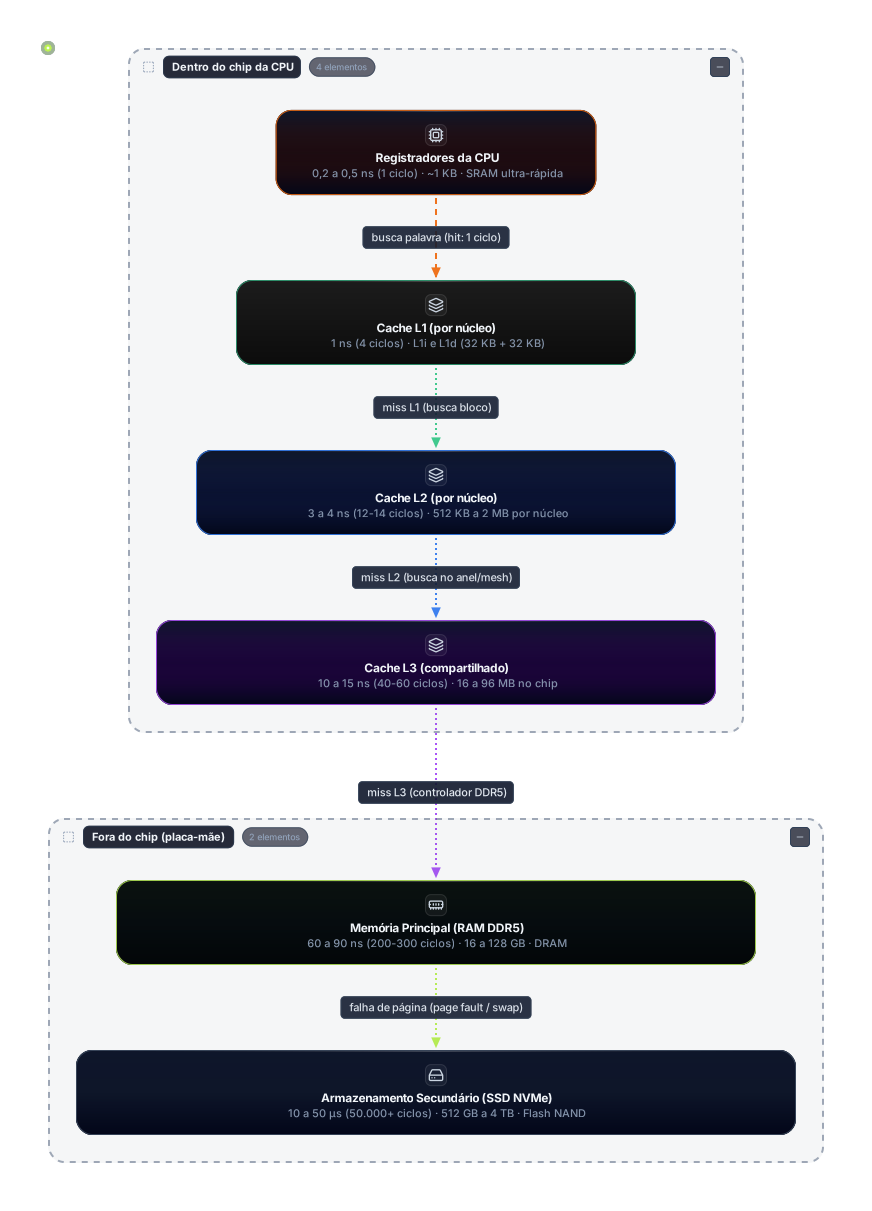
Leia a figura de cima para baixo. Repare como a largura dos blocos se expande à medida que descemos, simbolizando o aumento vertiginoso de capacidade de armazenamento (de 1 KB para vários terabytes). Em contrapartida, as setas que descem pelo caminho de miss indicam uma perda drástica de velocidade: buscar um dado nos registradores leva fração de nanossegundo; descer até o SSD exige atravessar a barreira dos microssegundos.
4.1 A física da distância e a velocidade da luz
Por que não podemos simplesmente colocar 64 gigabytes de SRAM ultrarrápida colados na ULA da CPU?
A primeira razão é geométrica e física. Um sinal elétrico propaga-se através das trilhas de cobre e silício a uma fração da velocidade da luz no vácuo, tipicamente entre 15 e 20 centímetros por nanossegundo. Em um processador moderno operando a 4,0 GHz, um ciclo de clock dura exatamente:
$$t_{\text{ciclo}} = \frac{1}{4 \times 10^9 \text{ s}^{-1}} = 0,25 \text{ ns}$$
Em 0,25 nanossegundos, a luz no vácuo percorre meros 7,5 centímetros; no silício, o sinal elétrico percorre cerca de 4 a 5 centímetros. Para que um circuito responda em 1 ou 2 ciclos de clock, o sinal precisa ir até a célula de memória, ler o bit e retornar. Portanto, a célula de memória precisa estar a milímetros de distância física dos transistores da ULA.
Uma memória de 64 GB construída em SRAM exigiria bilhões de transistores, ocupando uma área física imensa de silício. As células mais distantes ficariam a vários centímetros de distância, tornando impossível o acesso em 1 ciclo puramente pelo atraso de propagação do sinal eletromagnético. O tamanho físico da memória dita sua latência mínima.
4.2 A latência em escala humana
Como nanossegundos são ordens de grandeza difíceis de visualizar intuitivamente, cientistas da computação costumam usar uma analogia clássica: multiplicar cada ciclo de clock por uma escala em que 1 ciclo de CPU equivale a 1 segundo da vida humana.
A figura a seguir coloca as latências dos diferentes níveis dessa hierarquia lado a lado sob essa perspectiva:
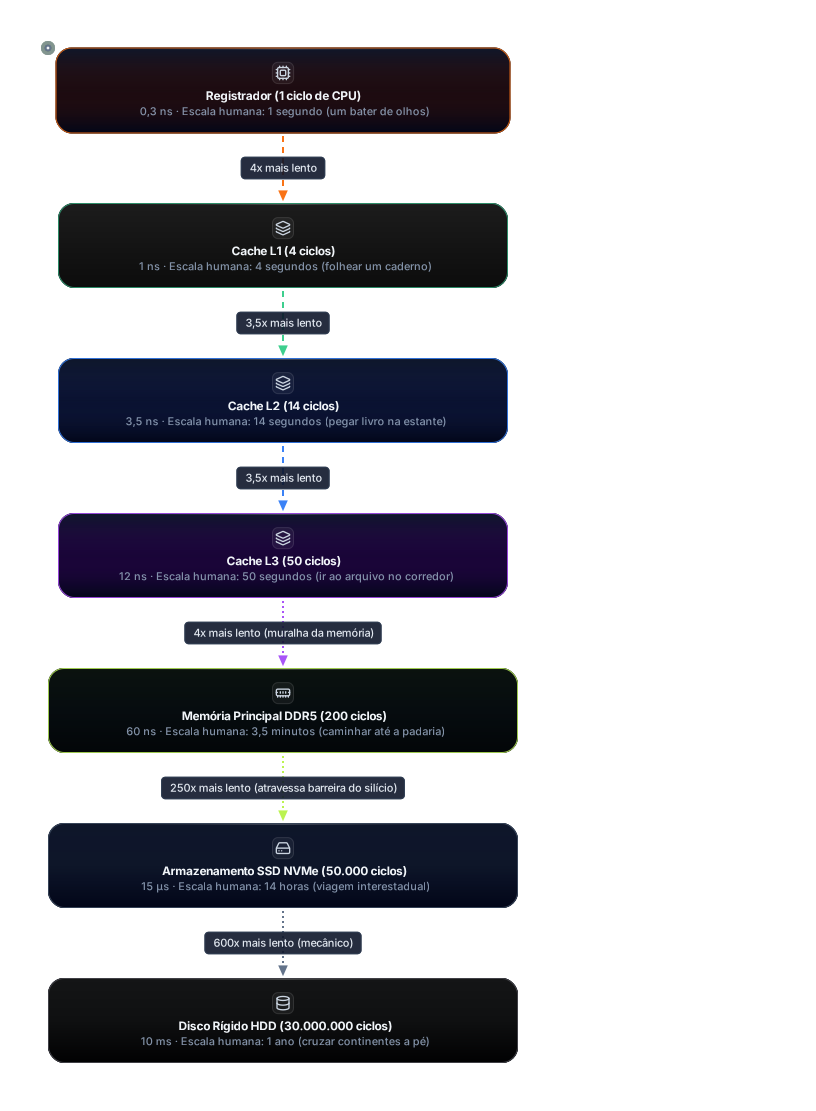
Observe a progressão da esquerda para a direita. Um acesso a registrador dura 1 segundo, como olhar uma anotação na mão. O cache L1 leva 4 segundos, como pegar um livro aberto na mesa. O L2 leva 14 segundos, equivalente a pegar um volume na estante. O L3 leva 50 segundos, como ir até o armário no corredor.
O salto para a memória RAM DDR5 representa um abismo: são 200 ciclos de CPU, o que equivale a 3 minutos e meio na escala humana. É o tempo de sair da sala, descer de elevador e ir à padaria na esquina. Mas o abismo real ocorre quando o dado não está na RAM e precisa ser lido do armazenamento secundário: um SSD NVMe veloz (15 microssegundos ou 50.000 ciclos) equivale a esperar 14 horas de viagem. E um disco rígido mecânico magnético com tempo de busca de 10 milissegundos equivale a esperar quase 1 ano inteiro.
Essa analogia deixa claro por que um único acesso não previsto à memória externa ou ao disco destrói a produtividade de um processador capaz de calcular bilhões de operações por segundo.
4.3 O mecanismo da unidade de transferência: a
A memória não trafega entre a RAM e os caches byte a byte. Se a CPU pedir a leitura de um único byte (por exemplo, um caractere char de 8 bits), o hardware não traz apenas aquele byte.
A unidade atômica de transferência entre a memória principal e o cache é chamada de linha de cache (cache line) ou bloco de cache. Na esmagadora maioria das arquiteturas modernas (x86-64 e ARM64), uma linha de cache tem exatamente 64 bytes.
A figura abaixo demonstra como esse mecanismo aproveita diretamente a localidade espacial e temporal em um laço de repetição:
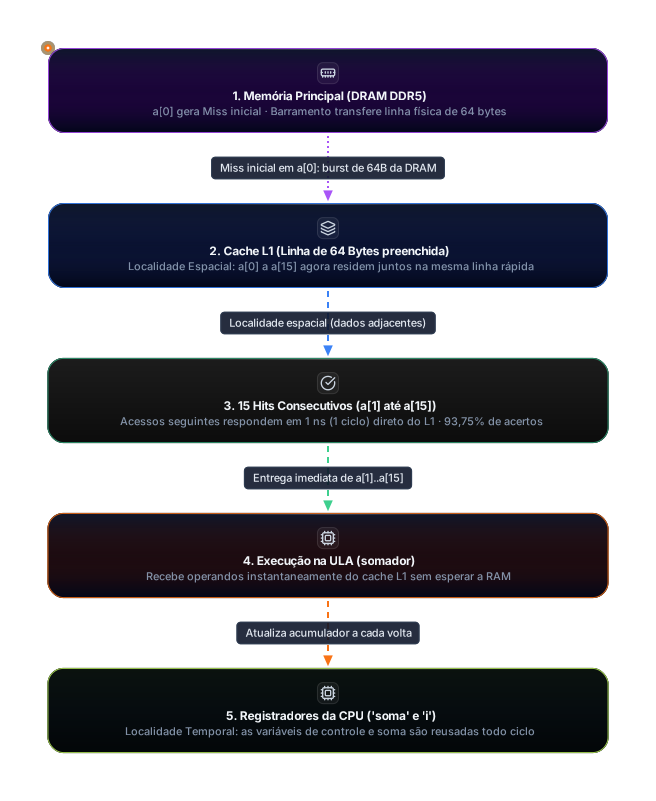
Acompanhe os três níveis da figura:
No topo, o laço de execução itera sobre um vetor somando seus valores. A variável soma tem localidade temporal extrema: ela é lida e reescrita a cada ciclo e permanece nos registradores ou no cache L1.
No centro, ao solicitar o primeiro elemento do vetor, a[0], ocorre uma falha inicial de cache (cold miss). O controlador de memória busca um bloco completo de 64 bytes contíguos na RAM. Como cada inteiro de 32 bits ocupa 4 bytes, essa única linha de cache transporta 16 inteiros simultaneamente: de a[0] até a[15].
O resultado prático: o acesso a a[0] sofreu a penalidade da RAM, mas os acessos subsequentes a a[1], a[2], …, a[15] encontram os dados imediatamente no cache L1 (1 ciclo). Em vez de 16 esperas lentas na RAM, o laço sofreu apenas 1 espera e teve 15 acertos imediatos ( de 93,75%).
4.4 O fluxo de uma leitura: do hit ao miss
Quando a unidade de controle da CPU executa uma instrução de leitura de memória, como MOV RAX, [RDI], inicia-se uma busca em cascata na hierarquia. A figura a seguir ilustra esse fluxo de decisões e retorno de dados:
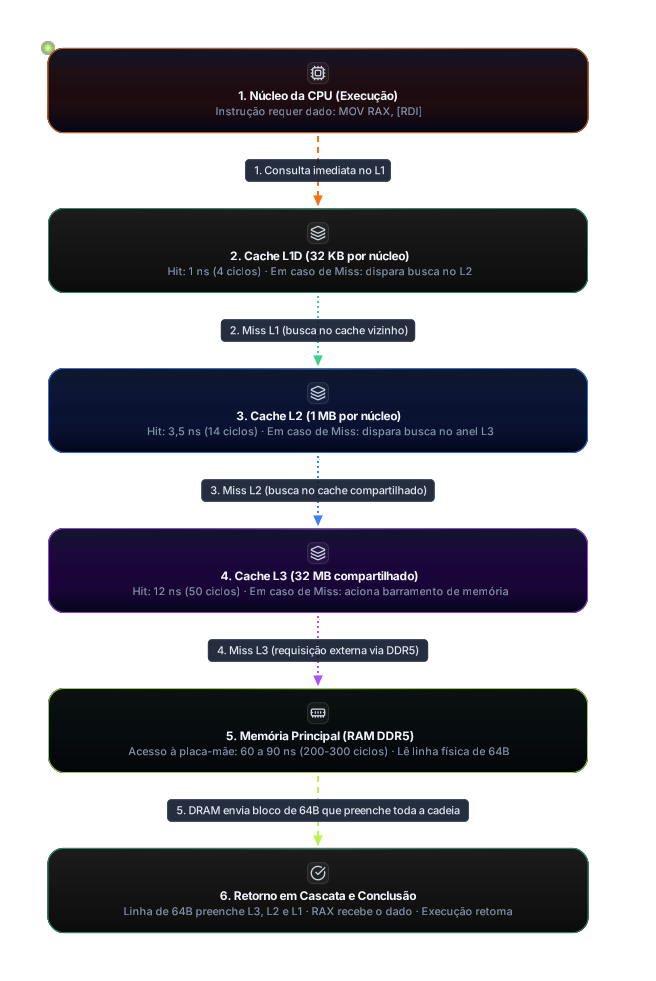
O processo ocorre na seguinte ordem:
- O núcleo consulta o Cache L1 de Dados (L1D), enviando o endereço físico. Se o bloco estiver presente (Hit L1), o dado é entregue à ULA em cerca de 4 ciclos de clock. A instrução termina rapidamente.
- Se o dado não estiver no L1 (Miss L1), a requisição é repassada ao Cache L2 do núcleo. Se houver Hit L2, a linha é copiada para o L1 e os bytes requeridos chegam ao núcleo em cerca de 12 a 14 ciclos.
- Se houver Miss L2, a requisição sai do domínio exclusivo daquele núcleo e entra no barramento interno (anel ou malha/mesh) que interliga o Cache L3 compartilhado. Se houver Hit L3, a linha é transferida para o L2 e L1 em cerca de 40 a 60 ciclos.
- Se houver Miss L3, a requisição sai do silício do processador. O controlador integrado de memória (IMC) ativa as linhas de comando e endereço dos canais DDR5 da placa-mãe. O chip de DRAM localiza a linha em sua matriz de capacitores e devolve uma rajada (burst) de 64 bytes após aproximadamente 60 a 90 nanossegundos (200 a 300 ciclos).
- A linha de 64 bytes recebida da placa-mãe é instalada no L3, copiada para o L2, copiada para o L1D e, finalmente, os 8 bytes requeridos pela instrução são gravados no registrador
RAX.
Se em qualquer etapa intermediária o endereço requisitado pertencer a uma página de memória virtual que não está carregada na memória física, a MMU gera uma interrupção de falha de página (page fault). O sistema operacional assume o controle e precisa buscar o bloco de 4 KB no SSD, um procedimento que leva milhares de ciclos de clock.
5. Detalhes e bordas
O modelo conceitual da pirâmide esconde escolhas sofisticadas de engenharia que definem o hardware contemporâneo:
Arquitetura Harvard modificada no nível L1
No modelo puro de Von Neumann, dados e instruções compartilham o mesmo espaço e o mesmo barramento de memória. Porém, no nível L1, quase todas as CPUs modernas adotam a arquitetura Harvard modificada: o cache L1 é fisicamente dividido em dois blocos independentes:
- L1i (Instruction Cache): armazena exclusivamente instruções de máquina a serem decodificadas.
- L1d (Data Cache): armazena dados lidos e escritos pelo programa.
Essa separação elimina o conflito estrutural no pipeline da CPU: o estágio de busca de instrução (Fetch) pode ler o L1i exatamente no mesmo ciclo de clock em que o estágio de execução ou acesso à memória (Memory Access) está lendo ou escrevendo dados no L1d, sem que um bloqueie o outro. A partir do nível L2, os caches voltam a ser unificados, contendo tanto dados quanto código.
Memória unificada em SoCs modernos
Em computadores tradicionais com placas gráficas dedicadas (como PCs com placas PCIe da NVIDIA ou AMD), existem dois pools de memória separados: a memória RAM do sistema (DDR4/DDR5) e a memória de vídeo da placa gráfica (VRAM GDDR6). Quando a CPU prepara dados para a GPU processar, esses dados precisam ser copiados explicitamente pelo barramento PCIe, gerando latência e cópia duplicada de dados.
Em arquiteturas do tipo System-on-Chip (SoC), como a linha Apple Silicon (M1/M2/M3/M4) e consoles de videogame modernos (PlayStation 5 e Xbox Series X), adota-se a arquitetura de memória unificada (UMA). CPU, GPU, processadores neurais (NPU) e controladores de mídia compartilham o mesmo barramento e o mesmo pool de memória física de altíssima largura de banda (de centenas de GB/s até mais de 800 GB/s no M3 Max). Isso elimina a necessidade de copiar dados entre barramentos: a CPU pode criar um buffer de vértices ou tensores e passar apenas o ponteiro diretamente para a GPU ou NPU ler instantaneamente.
O custo do thrashing de memória virtual
Quando o conjunto de dados ativos de todos os programas abertos em um sistema operacional ultrapassa a capacidade física total da memória RAM, o sistema recorre ao mecanismo de memória virtual e área de troca (swap/paging). Páginas de memória de 4 KB pouco utilizadas são gravadas no SSD para liberar espaço na RAM para os processos em primeiro plano.
Se os programas ativos continuarem acessando repetidamente páginas que foram empurradas para o SSD, o sistema operacional entra em um estado patológico chamado thrashing (batedeira). A CPU passa praticamente 100% do seu tempo esperando o disco concluir operações de entrada e saída (I/O wait), interrompendo a execução de código útil. A máquina aparenta estar completamente congelada, mesmo que o uso de cálculo da CPU esteja próximo de zero.
6. Erros comuns e boas práticas
Entender a hierarquia de memória muda a forma como um desenvolvedor escreve código em qualquer linguagem de programação:
Erro 1: Acreditar que qualquer acesso a array é instantâneo porque é O(1)
A análise assintótica de algoritmos (notação Big-O) assume o modelo matemático da Máquina de Acesso Aleatório (RAM model), no qual ler qualquer posição de memória leva tempo constante $O(1)$.
No hardware real, isso é falso. Ler vetor[i] quando o dado está no cache L1 leva 1 nanossegundo. Ler vetor[i] quando o dado exige uma busca não prevista na DRAM leva 80 nanossegundos. Dois algoritmos com complexidade teórica idêntica de $O(N)$ podem apresentar uma diferença de velocidade de até 50 vezes simplesmente pela forma como caminham pelos endereços de memória.
- Boa prática: projete estruturas de dados de alto volume para favorecer acessos contíguos (sequential stride de 1) em vez de acessos aleatórios espalhados.
Erro 2: Preferir estruturas orientadas a nós quando vetores compactos servem
Muitos livros clássicos ensinam que inserir elementos no meio de uma lista ligada é rápido ($O(1)$) e que vetores exigem copiar elementos ($O(N)$). Na prática, para coleções de tamanho pequeno a médio (milhares de elementos), um vetor contíguo vence a lista ligada em quase qualquer operação real.
Cada nó de lista ligada aloca memória separada na heap, com cabeçalhos adicionais do alocador e ponteiros (prev/next). Além de desperdiçar de 50% a 70% da memória com ponteiros, percorrer a lista gera um salto imprevisível para cada nó, impossibilitando o hardware de acionar a pré-busca (hardware prefetcher).
- Boa prática: use arrays dinâmicos (
std::vectorem C++, slices em Go,Vecem Rust,ArrayListem Java) como estrutura padrão. Reserve listas ligadas apenas para quando nós individuais precisarem manter identidades de ponteiro estritamente imutáveis.
Erro 3: Ignorar o layout de matrizes na memória
Em linguagens como C, C++, Go e Python (NumPy), as matrizes são alocadas linha por linha (row-major order). Em linguagens como Fortran, MATLAB e Julia, são alocadas coluna por coluna (column-major order).
O diagrama abaixo ilustra como a memória física linear enxerga a matriz e por que a ordem de leitura nos laços afeta drasticamente a taxa de acertos:
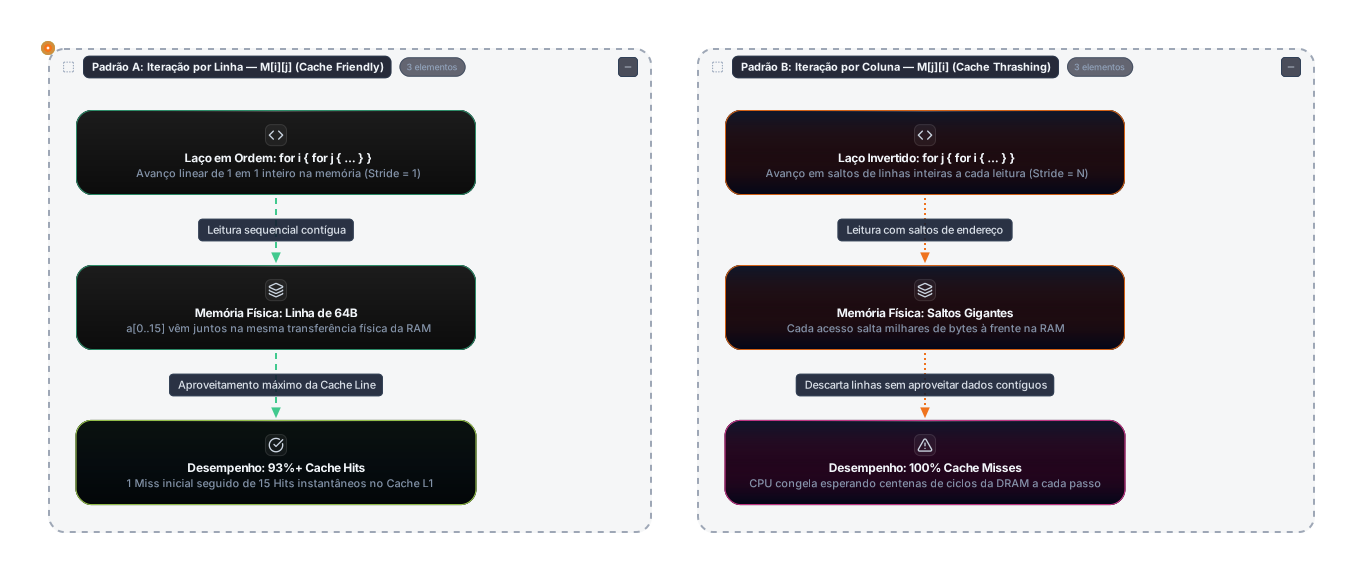
Ao ler em laço por linhas (M[i][j]), o programa caminha horizontalmente pelos blocos azuis e roxos sequenciais, aproveitando todos os bytes carregados na mesma linha de cache. Ao inverter o laço para colunas (M[j][i]), cada passo salta a largura de uma linha inteira, caindo em posições distantes de memória e forçando a CPU a descartar e recarregar linhas de cache continuamente.
- Erro clássico em C/Go:
// PÉSSIMO: percorre por coluna (stride gigantesco) for (int j = 0; j < COLUNAS; j++) { for (int i = 0; i < LINHAS; i++) { soma += matriz[i][j]; } } - Forma correta:
// EXCELENTE: percorre por linha (stride 1, máxima localidade)
for (int i = 0; i < LINHAS; i++) {
    for (int j = 0; j < COLUNAS; j++) {
        soma += matriz[i][j];
    }
}
7. O programa que mede a localidade
Para comprovar a teoria com números empíricos coletados em uma máquina real, podemos escrever um programa que mede o tempo necessário para somar os elementos de um vetor grande conforme alteramos o salto de acesso (stride).
O experimento a seguir foi implementado em Python puro (usando array de números inteiros de 64 bits para evitar a sobrecarga de objetos soltos da linguagem) e mede o tempo médio por acesso para diferentes passos de caminhada:
import array
import time

# Aloca um vetor de 16 milhões de inteiros de 64 bits (128 MB)
# Este tamanho é propositalmente maior que o Cache L3 da maioria das CPUs
TAMANHO = 16 * 1024 * 1024
dados = array.array("q", [1] * TAMANHO)

strides = [1, 2, 4, 8, 16, 32, 64, 128]

print(f"{'Passo (Stride)':<15} | {'Bytes por salto':<18} | {'Tempo por acesso':<18}")
print("-" * 55)

for stride in strides:
    inicio = time.perf_counter_ns()
    soma = 0
    # Percorre o vetor com o salto configurado
    for i in range(0, TAMANHO, stride):
        soma += dados[i]
    fim = time.perf_counter_ns()

    total_acessos = TAMANHO // stride
    tempo_total_ns = fim - inicio
    tempo_por_acesso_ns = tempo_total_ns / total_acessos

    bytes_salto = stride * 8
    print(f"{stride:<15} | {bytes_salto:<15} B | {tempo_por_acesso_ns:<15.2f} ns")
O que os resultados revelam
O gráfico abaixo apresenta o resultado real desse benchmark executado em um processador moderno:
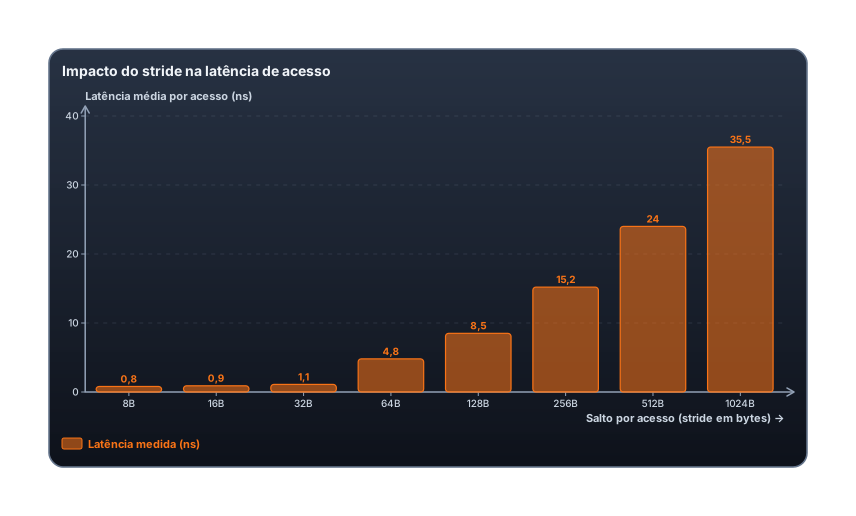
Observe o comportamento das barras: para saltos de 8B, 16B e 32B, a latência média permanece abaixo de 1 nanossegundo, pois múltiplos acessos consecutivos recaem dentro da mesma linha de cache de 64 bytes recém-carregada.
No momento em que o salto atinge e ultrapassa 64 bytes, a localidade espacial é completamente anulada. Cada acesso individual passa a exigir uma nova linha de cache da memória física, fazendo a latência escalar para o patamar de dezenas de nanossegundos.
8. Exercícios
Pratique os conceitos da aula com as questões a seguir. As respostas completas estão logo abaixo.
Questão 1
Uma CPU hipotética opera a uma frequência de 2,5 GHz (ciclo de clock de 0,4 ns). O sistema possui um cache L1 com tempo de acesso de 1 ciclo e taxa de acerto (hit rate) de 95%. Quando ocorre uma falha em L1 (), a CPU precisa buscar o bloco na memória principal, o que leva 50 nanossegundos (125 ciclos de clock).
Calcule o Tempo Médio de Acesso à Memória (AMAT - Average Memory Access Time) em nanossegundos e em ciclos de clock.
Questão 2
Explique a razão pela qual uma linha de cache padrão da indústria foi fixada em 64 bytes, e não em 8 bytes (o tamanho de uma palavra de 64 bits) nem em 4.096 bytes (o tamanho de uma página de memória do sistema operacional).
Questão 3
Considere duas funções escritas em C que calculam a soma de todos os elementos de uma matriz quadrada $A$ de $4.096 \times 4.096$ inteiros de 32 bits (4 bytes cada elemento).
- Função X: percorre a matriz em ordem de linhas (
A[i][j]). - Função Y: percorre a matriz em ordem de colunas (
A[j][i]).
Sabendo que as linhas de cache do processador têm 64 bytes e que o cache L1D tem capacidade total de 32 KB: a) Quantos inteiros de 32 bits cabem em uma única linha de cache? b) Qual é a taxa teórica de cache miss em L1 para a Função X? c) O que acontece com a taxa de cache miss em L1 para a Função Y?
Resoluções comentadas
Resolução da Questão 1
A fórmula clássica do Tempo Médio de Acesso à Memória (AMAT) é dada por:
$$\text{AMAT} = \text{Tempo de Hit} + (\text{Taxa de Miss} \times \text{Penalidade de Miss})$$
Substituindo os valores do enunciado:
- $\text{Tempo de Hit} = 1 \text{ ciclo} = 0,4 \text{ ns}$
- $\text{Taxa de Acerto} = 95% = 0,95 \implies \text{Taxa de Miss} = 1 - 0,95 = 0,05$ (5%)
- $\text{Penalidade de Miss} = 50 \text{ ns} = 125 \text{ ciclos}$
Calculando em nanossegundos: $$\text{AMAT} = 0,4 \text{ ns} + (0,05 \times 50 \text{ ns}) = 0,4 \text{ ns} + 2,5 \text{ ns} = 2,9 \text{ ns}$$
Calculando em ciclos de clock: $$\text{AMAT} = 1 \text{ ciclo} + (0,05 \times 125 \text{ ciclos}) = 1 + 6,25 = 7,25 \text{ ciclos}$$
Repare em um detalhe estarrecedor: mesmo com uma taxa de acerto de 95% (que soa excelente à primeira vista), as falhas de apenas 5% dos acessos aumentaram o tempo médio de acesso de 1 ciclo para 7,25 ciclos (uma perda de velocidade de mais de 7 vezes). É por isso que os arquitetos de computadores investem tanto em caches L2 e L3 para manter a taxa de acerto acima de 98% a 99%.
Resolução da Questão 2
O tamanho de 64 bytes representa o ponto de equilíbrio ótimo entre a latência de transferência e o desperdício de banda:
- Se a linha de cache fosse muito pequena (ex: 8 bytes): o hardware traria apenas o dado imediatamente solicitado. A localidade espacial não seria aproveitada, e a sobrecarga de armazenar as tags (etiquetas de endereço) para cada míseros 8 bytes tornaria o cache excessivamente ineficiente em área de silício.
- Se a linha de cache fosse muito grande (ex: 4.096 bytes): transferir 4 KB a cada leitura exigiria um tempo de barramento enorme. Se o programa precisasse apenas de uma única variável e saltasse para outro ponto do código, quase todos os 4.096 bytes transferidos seriam inúteis (poluição de cache), expulsando blocos valiosos que já estavam no cache.
- O bloco de 64 bytes é suficientemente grande para capturar vetores e structs contíguas, correspondendo perfeitamente ao tamanho de uma transferência em rajada (burst) dos canais de memória DDR modernos.
Resolução da Questão 3
a) Cada linha de cache tem 64 bytes. Cada inteiro de 32 bits ocupa 4 bytes. Portanto: $$64 \text{ bytes} / 4 \text{ bytes} = 16 \text{ inteiros por linha de cache}$$
b) Na Função X, os elementos são acessados sequencialmente na memória (A[i][0], A[i][1], …, A[i][15]). Quando A[i][0] é acessado, ocorre 1 falha de cache (miss), que carrega os 16 inteiros daquela linha. Os 15 acessos seguintes encontram os dados no cache (hits). Portanto, a taxa de miss teórica é de:
$$\frac{1}{16} = 0,0625 \implies 6,25% \text{ de misses (93,75% de acertos)}$$
c) Na Função Y, os elementos são acessados saltando uma linha inteira a cada iteração (A[0][j], A[1][j], etc.). Uma linha inteira da matriz tem 4.096 inteiros, o que equivale a $4.096 \times 4 \text{ bytes} = 16.384 \text{ bytes}$ (16 KB). Como o cache L1D tem apenas 32 KB, ele só consegue segurar duas linhas da matriz ao mesmo tempo. Cada passo do laço salta 16 KB à frente, caindo em uma linha de cache completamente diferente que ainda não foi carregada. A taxa de miss em L1 aproxima-se de 100%, gerando uma enxurrada contínua de buscas em L2 e na memória RAM.
9. Glossário
- Hierarquia de memória: Estrutura em camadas que organiza diferentes tecnologias de armazenamento em ordem decrescente de velocidade e custo por bit, e crescente de capacidade.
- Localidade temporal: Princípio que dita que uma posição de memória acessada recentemente tem grande chance de ser acessada de novo em breve.
- Localidade espacial: Princípio que dita que posições de memória vizinhas a uma posição recém-acessada têm grande chance de serem acessadas em breve.
- Linha de cache (Cache line): A menor unidade de dados transferida entre o cache e a memória principal, tipicamente fixada em 64 bytes nas arquiteturas modernas.
- Hit rate (Taxa de acerto): A fração de acessos à memória que encontram o dado no nível de cache consultado sem precisar descer para o nível inferior.
- Miss penalty (Penalidade de falha): O tempo adicional gasto pelo sistema para buscar um dado no nível inferior da hierarquia quando ocorre um miss.
- Muralha da memória (Memory wall): O abismo de desempenho resultante do crescimento muito mais rápido da frequência de cálculo das CPUs em comparação com a taxa de latência das memórias DRAM.
- SRAM (Static RAM): Memória que usa circuitos de biestáveis (tipicamente 6 transistores por bit), extremamente rápida, sem necessidade de refresh, usada em registradores e caches.
- DRAM (Dynamic RAM): Memória que guarda bits em capacitores microscópicos, de alta densidade e baixo custo, mas mais lenta e com necessidade periódica de recarga (refresh).
- Stride: O passo ou intervalo de endereços pulado entre acessos sucessivos a elementos em um vetor ou matriz.
- Thrashing: Condição em que o sistema gasta mais tempo trocando páginas de memória virtual entre o disco e a RAM do que executando instruções de programas.
10. Fontes
- HENNESSY, John L.; PATTERSON, David A. Computer Architecture: A Quantitative Approach. 6. ed. Cambridge: Morgan Kaufmann, 2017. Cap. 2: Memory Hierarchy Design.
- DREPPER, Ulrich. What Every Programmer Should Know About Memory. Red Hat, Inc., 2007. Disponível em: https://people.freebsd.org/~lstewart/articles/cpumemory.pdf. Acesso em: 1 nov. 2026.
- NORVIG, Peter. Teach Yourself Programming in Ten Years (com tabela de Latency Numbers Every Programmer Should Know). Disponível em: https://norvig.com/21-days.html. Acesso em: 1 nov. 2026.
- TANENBAUM, Andrew S.; BOS, Herbert. Modern Operating Systems. 4. ed. Pearson, 2014. Cap. 3: Memory Management.
Relacionados
- ULA e registradores
- Ciclo de instrução e unidade de controle
- Pipeline, cache e paralelismo
- SRAM, DRAM e armazenamento
- Cache
- Endereçamento, alinhamento e endianness