Hardware e sistemas operacionais · parte 19 de 27
SRAM, DRAM e armazenamento: como cada tecnologia guarda um bit
Como SRAM, DRAM, flash e disco guardam um bit por dentro, por que a SRAM é rápida e cara e a DRAM lenta e barata, e o que dá persistência.
intermediárioPublicada em · 41 min de leitura
Pense em dois colegas de sala que vivem discordando. Um afirma o contrário do que o outro acabou de dizer, e a briga se repete sem parar, porque cada um cobra do outro a resposta certa. Essa é a ideia do laço de inversores que a aula de Circuitos sequenciais construiu, e é assim que a SRAM guarda um bit: a resposta vive enquanto o laço estiver ligado. Se a energia cai, a discussão acaba e a resposta some.
A DRAM se parece mais com um balde com furo. O bit é a água, o furo deixa a água escorrer, e alguém precisa encher o balde de novo antes que ele seque. A flash guarda o bit como um recado trancado num envelope dentro de outro envelope: a carga fica presa lá dentro sem que nada esteja ligado. O disco magnético é um LP. Para tocar uma faixa, a agulha precisa chegar ao sulco certo, e a música só começa quando o ponto desejado passa por baixo dela.
Esta aula responde por que essas quatro tecnologias custam e se comportam de maneiras tão diferentes, e por que a SRAM é rápida e cara enquanto a DRAM é lenta e barata. Ela pressupõe o laço de dois inversores e o latch da aula de Circuitos sequenciais, e a aula de Hierarquia de memória e localidade, que mostrou por que existem vários níveis e onde cada um entra. A hierarquia não será repetida aqui. Vamos olhar para dentro das células, que é onde o preço nasce.
Dois termos aparecem já no começo. Um bit é um valor 0 ou 1 guardado. Uma célula é o menor pedaço de um chip de memória que guarda um bit. Volátil é a memória que perde o conteúdo quando a energia some, e não volátil é a que o mantém sem energia. Os demais termos são definidos quando aparecem pela primeira vez, e o glossário ao final reúne todos.
Mapa da aula
| Seção | Pergunta que responde |
|---|---|
| 1. O que é cada tecnologia | Quais são as quatro famílias e o que as separa? |
| 2. Para que serve | Por que a mesma sigla RAM cabe em memórias de custos tão diferentes? |
| 3. Exemplos em contextos diferentes | Onde cada família aparece no dia a dia? |
| 4. Como funciona por dentro | Como cada célula guarda, lê, perde e recupera o bit? |
| 5. Detalhes e bordas | Que variantes e limites existem? |
| 6. Erros comuns e boas práticas | Que equívocos aparecem ao usar essas memórias? |
| 7. O programa que confere as contas | Como refazer os números desta aula? |
| 8. Exercícios | Como praticar, com respostas de referência? |
| 9. Glossário | Quais termos a aula usa? |
| O que não foi confirmado | O que ficou sem fonte primária ou sem medição? |
| Fontes | De onde vêm os fatos, e quando foram consultados? |
1. O que é cada tecnologia
Existem quatro famílias que importam nesta aula. A SRAM é a memória de cache: rápida e cara por bit. A DRAM é a memória principal do computador: mais lenta e mais barata. A flash é a que aparece em pendrives, cartões de memória e SSDs, e guarda o bit sem energia. O disco magnético é o HD tradicional, que também guarda o bit sem energia, mas com peças que se movem. As duas primeiras são voláteis. As duas últimas não são.
Por que separar voláteis de não voláteis logo no início? Porque essa diferença decide o uso de cada uma. Nenhum programa mantém suas variáveis só num pendrive, porque o pendrive é lento demais para acompanhar a CPU. Ao mesmo tempo, ninguém guarda as fotos da família só na RAM, porque elas sumiriam ao desligar. Cada família ocupa seu lugar por combinar um tipo de física com um tipo de uso.
O custo também tem origem física. Cada família guarda o bit com um fenômeno diferente: um laço de transistores que se sustenta sozinho, uma carga num capacitor que escoa, uma carga presa numa porta isolada, uma orientação magnética que acompanha o prato. Quanto mais peças o bit exige, e quanto menos ele se sustenta sem ajuda, mais caro fica o bit, ou mais cuidado ele pede do circuito que o cerca.
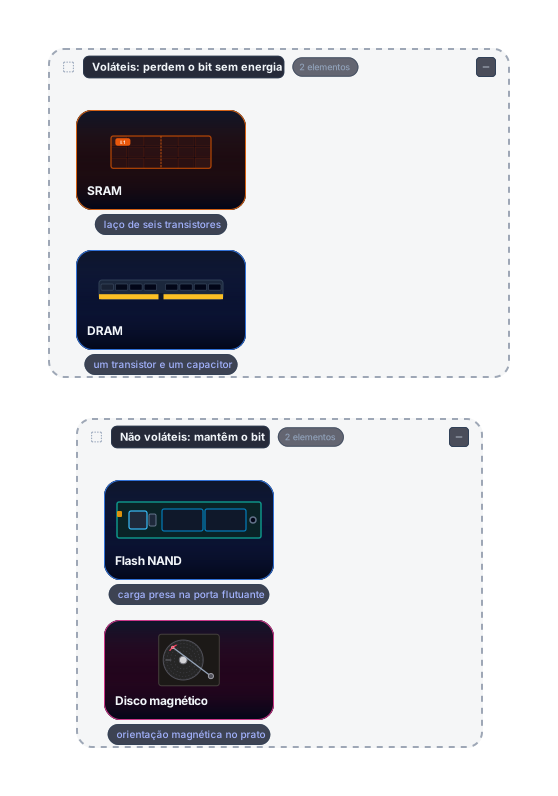
A figura separa as famílias pelo critério de perder ou manter o bit sem energia. Os grupos da esquerda são voláteis, e os da direita não são. Cada cartão traz o ícone da peça física e a frase que descreve como o bit é guardado. Os ícones são só a identificação visual de cada família, e não indicam tamanho nem preço. A aula não mediu preço nem tempo de acesso nesta figura. Os números de tempo aparecem na seção 4.10, com a CPU de referência e as fontes.
2. Para que serve
A CPU precisa de bits que respondam em poucos ciclos perto dela, de muitos bits longe dela a um preço razoável, e de bits que sobrevivam ao desligamento. Nenhuma tecnologia atende às três exigências, e por isso a hierarquia da aula de Hierarquia de memória e localidade existe. Sobra uma pergunta que a hierarquia não responde sozinha: por que SRAM e DRAM têm custos tão distantes, se as duas são chamadas de RAM?
RAM quer dizer memória de acesso aleatório. A sigla descreve a forma de acesso, que permite ler qualquer endereço em tempo parecido, e não a física da célula. Por isso ela cabe a duas coisas diferentes. A SRAM usa um laço de seis transistores por bit, e o laço só funciona enquanto há energia. A DRAM usa um transistor e um capacitor por bit, e o capacitor perde carga com o tempo. A primeira gasta peças para não precisar de cuidado. A segunda economiza peças e paga com manutenção constante, o refresh da seção 4.5.
A flash e o disco entram porque a pergunta muda. Para quem quer guardar uma foto por anos, importa se o bit continua lá depois de desligar, e quanto custa cada gigabyte. Por isso a aula trata das quatro juntas, com uma regra de leitura: as duas primeiras dizem respeito a um bit que vive enquanto há energia, e as duas últimas, à persistência.
3. Exemplos em contextos diferentes
O primeiro exemplo é a cache de um núcleo. Um processador moderno guarda em SRAM os dados que acabou de usar, porque a CPU espera ciclos a mais por cada acesso que erra. Com a CPU de referência desta aula (seção 4.10), a cache L1 responde em 4 ciclos. Nesse caso, pagar seis transistores por bit compensa, porque o ganho de tempo vale mais que o espaço que se perde no chip.
O segundo exemplo é a memória de um notebook. Os programas em execução vivem na DRAM, em quantidade muito maior que a cache. Quando o notebook é desligado, esse conteúdo some, e por isso o que precisa sobreviver ao desligamento tem de ser gravado em armazenamento não volátil. A DRAM é barata por bit porque cada bit ocupa um transistor e um capacitor, e não um laço inteiro.
O terceiro exemplo é o pendrive. Você grava uma foto nele, tira o pendrive da porta, e a foto continua lá. A célula flash prende a carga numa porta isolada, e essa carga não depende de energia para continuar presa. Só que o pendrive escreve em páginas e apaga em blocos, de modo que trocar uma foto por outra exige mais trabalho do que parece. A seção 4.8 explica esse trabalho.
O quarto exemplo é um disco de backup, que guarda muitos gigabytes por pouco dinheiro. Para ler um arquivo grande de uma vez, o disco vai bem. Para ler muitos arquivos pequenos espalhados pelo prato, a história muda, porque o braço precisa ir até cada trilha e esperar o setor passar. A seção 4.9 faz essa conta.
Os quatro casos mostram que o custo do bit e a velocidade de acesso aparecem juntos, mas a conta muda com o padrão de uso. Uma cache lida com poucos bits e acessos seguidos. Um disco de backup lida com volume. Olhar para o padrão de uso antes de olhar a tabela de preços já decide boa parte da escolha.
4. Como funciona por dentro
Esta seção abre cada memória até o transistor. As figuras de circuito usam símbolos de bloco, porque o ArchFlow não tem elemento de transistor. Cada ci da figura é um transistor de três pinos: a porta à esquerda, o dreno e a fonte à direita. Essa é a convenção do desenho, e a seção “O que não foi confirmado” repete a ressalva.
4.1 A célula SRAM: seis transistores em laço
Uma célula SRAM tem seis transistores. Drepper escreve que uma célula exige seis transistores e que existem variantes, e a nota de Mason, da Michigan State University, descreve a célula com dois transistores de acesso e suas operações de hold, write e read. Quatro deles formam dois inversores ligados em anel, exatamente como no laço da aula de Circuitos sequenciais. Cada inversor é um par de transistores complementares, um PMOS que liga a saída à alimentação e um NMOS que a liga ao terra, como visto em Transistor como chave. Os outros dois são os transistores de acesso, que a seção 4.2 apresenta.

A figura mostra só o núcleo, para que a realimentação fique visível sem o acesso misturado a ela. A alimentação VDD chega ao terminal superior de cada PMOS, e cada NMOS desce ao terra. Os dois inversores têm as portas ligadas a um nó de entrada, e as saídas se ligam ao nó oposto. Siga o caminho do bit: o dreno de P1 e o de N1 formam o nó Q, que leva o valor à porta de P2 e N2. A saída de P2 e N2 forma o nó Qn, que volta pela parte de cima e entra nas portas de P1 e N1. As legendas das caixas dizem o valor de cada entrada: com Q em 1, a porta de P2 vê 1 e desliga o PMOS, enquanto o NMOS de N2 conduz e puxa Qn para 0. Esse 0 volta às portas de P1 e N1, e confirma o estado. Nenhum dos dois inversores decide sozinho. A resposta fica no circuito inteiro, que é a ideia que a aula 2.3 mostrou com o latch.
4.2 Acesso e leitura: a linha de palavra e o par de bits
O núcleo sozinho segura o valor, mas não consegue ser lido nem escrito de fora. Para isso entram dois transistores de acesso, M5 e M6, que ligam os nós Q e Qn às linhas de bit, BL e BLn. A linha de palavra, WL, controla os dois transistores ao mesmo tempo. Quando WL está em 0, os acessos ficam cortados e o núcleo se isola do resto do chip. Quando WL sobe, os acessos conduzem e o valor pode ser lido ou escrito pelo par de linhas.

A figura mostra o estado de retenção, com WL em 0 V. Os acessos M5 e M6 estão cortados, e o núcleo, representado pelo bloco com as saídas q e qn, não recebe nem envia nada pelas linhas. As duas linhas de bit aparecem em 1 V, que é o nível de pré-carga adotado pela aula. A linha de palavra vai à porta de M5 e de M6 pelo mesmo fio, e as duas saídas do núcleo ligam-se a um dreno ou fonte de cada acesso. Na leitura, WL sobe e os dois acessos conduzem, como mostra a figura 04.
Para ler, a linha de palavra sobe e a célula começa a agir sobre as linhas de bit. A figura 04 segue a sequência. Em Q igual a 1, o lado que guarda 0 é o Qn. Ele puxa a linha BLn para baixo pelo caminho que passa pelo inversor. A linha BL, do lado que guarda 1, continua alta. Um amplificador de leitura compara as duas linhas e decide o valor pela diferença entre elas, sem esperar que uma delas chegue ao valor final.
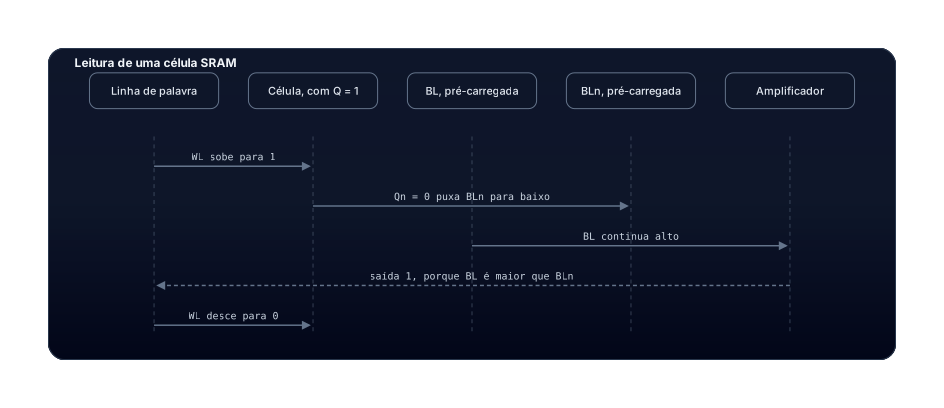
A sequência tem uma regra: as duas linhas começam iguais, e a célula cria a diferença. Leia a mensagem em que Qn igual a 0 puxa BLn para baixo, enquanto BL continua alto porque Q vale 1. O amplificador só precisa ver que BL é maior que BLn. A última mensagem fecha a sequência com a linha de palavra descendo, e o núcleo volta a segurar o valor sozinho. Por que essa leitura é rápida? Porque a própria célula dirige a linha de bit com transistores, sem depender de um capacitor que divide a carga com a linha. Essa é a diferença que a seção 4.3 vai contrastar com a DRAM. O custo do caminho rápido aparece no silício: seis transistores por bit, e um laço que precisa de energia para continuar existindo.
4.3 A célula DRAM: um transistor e um capacitor
A DRAM troca o laço por uma peça bem mais simples. Um capacitor guarda carga elétrica, e a presença ou a ausência de carga representa o bit. Um único transistor de acesso liga o capacitor à linha de bit quando a linha de palavra sobe. Drepper resume a estrutura em uma frase: um transistor e um capacitor, em que o capacitor guarda o estado e o transistor protege o acesso a ele. A nota da MSU diz o mesmo com outras palavras: um nFET de acesso, um capacitor de armazenamento e a linha de palavra como controle.

A figura tem um transistor M, o capacitor Cs que guarda o bit com Vs = 1 V, e a capacitância da linha de bit, Cbit, ligada ao terra. A palavra WL está em 0 V, de modo que M está cortado e a carga de Cs não sai. Quando WL sobe, M conduz, e Cs passa a dividir a carga com a linha. O amplificador, desenhado como um voltímetro, representa de forma simplificada o circuito de leitura da seção 4.2. Na DRAM, a linha de bit funciona como uma capacitância que recebe a carga de Cs, e por isso a variação que o amplificador vê é pequena.
A simplicidade tem efeito direto no preço. Drepper afirma que a célula DRAM é muitas vezes menor que a SRAM, e por isso mais bits cabem na mesma área de silício. O preço dessa economia aparece na leitura e na manutenção, que as seções 4.4 e 4.5 explicam.
4.4 A leitura que apaga e a regravação
Quando Cs divide a carga com a linha de bit, a tensão de Cs muda, e o valor original deixa de existir na célula. A nota de Mason é direta: a leitura da DRAM é destrutiva, e a operação precisa conter uma regravação simultânea. Drepper descreve o mesmo fenômeno com outro vocabulário: a leitura consome a carga do capacitor, e a saída do amplificador é enviada de volta ao capacitor para recarregá-lo.
A conta da divisão de carga está na nota da MSU: a carga inicial de Cs, Vs · Cs, se redistribui entre Cs e Cbit até uma tensão final Vf = Cs · Vs / (Cs + Cbit). Com Cbit dez vezes maior que Cs, valor escolhido só para o exemplo, a tensão final é Vs / 11, cerca de 9 % de Vs. A própria nota diz que essa tensão é muito pequena e exige um bom amplificador de leitura. Ler a DRAM, portanto, é perceber uma diferença pequena e, ao mesmo tempo, esvaziar a fonte da informação.
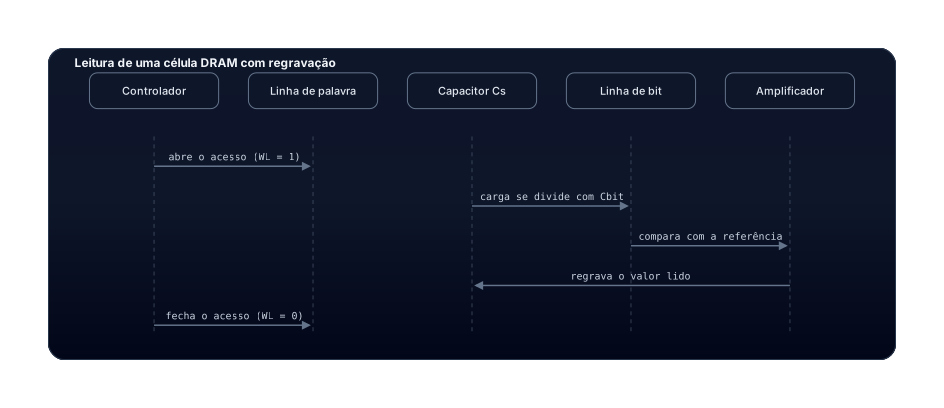
A sequência tem cinco passos, lidos de cima para baixo. O controlador abre o acesso subindo WL. Depois a carga de Cs se divide com a linha de bit. O amplificador compara a linha com a referência e decide o valor. A regravação devolve esse valor a Cs, e por fim o controlador fecha o acesso descendo WL. O quarto passo é o que impede a leitura de apagar o bit, porque a leitura gastou a carga e a regravação a devolve. Esse passo tem custo, e Drepper diz que a leitura exige tempo e energia adicionais por causa da regravação. Sem a regravação, o valor lido sairia da memória, e o próprio dado se perderia.
4.5 Refresh: o balde que precisa ser enchido
O capacitor não guarda carga para sempre. Mesmo com o transistor de acesso cortado, a carga escoa por uma corrente de fuga, que Drepper chama de leakage, e o bit se perde com o tempo. Por isso a DRAM precisa de uma atualização periódica, o refresh.
O refresh é uma leitura seguida de regravação, em que o resultado lido é descartado, e precisa atingir todas as linhas dentro de uma janela de tempo. Drepper afirma que, para a maioria dos chips DRAM daquela época, a janela era de 64 ms, segundo a especificação do JEDEC. Para deixar a conta visível, ele dá um exemplo: com 8192 linhas, o controlador emite um comando de refresh, em média, a cada 7,8125 µs. Durante um ciclo de refresh, o acesso à memória não é possível, e Drepper cita um estudo segundo o qual, em algumas cargas de trabalho, essa sobrecarga chega a travar até 50 % dos acessos.
Para memórias DDR5, a Wikipedia afirma que a janela cai para 32 ms até 85 °C e para 16 ms entre 85 °C e 95 °C. Esse valor não foi conferido no texto do JEDEC nesta aula, e a seção de confirmação diz isso.
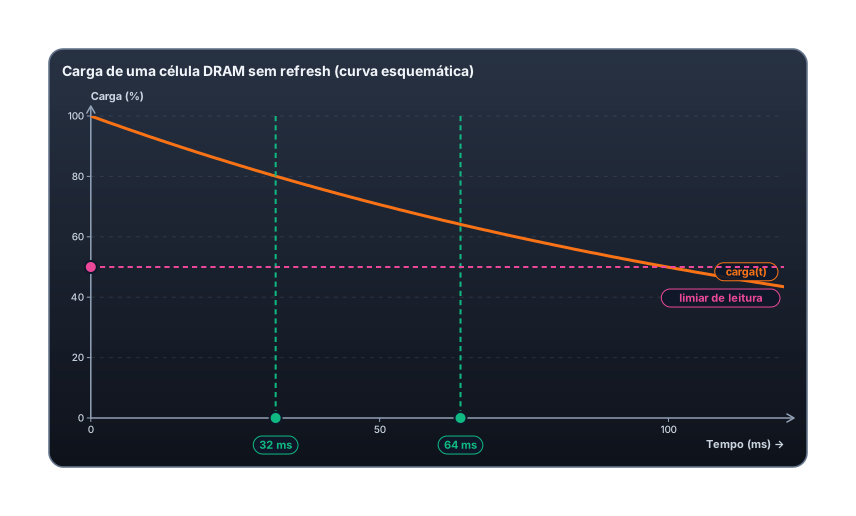
A curva é uma exponencial escolhida para mostrar o escoamento, e não foi medida em nenhum chip. A constante de 144 ms foi escolhida para o desenho. Com ela, a carga cai a cerca de 80 % do inicial em 32 ms, e a cerca de 64 % em 64 ms. Ela cruza o limiar de 50 % perto de 99,8 ms, que é 144 · ln 2. Esse instante não é o de um chip real. A figura mostra só a perda: o refresh não aparece nela, e é ele que devolveria a carga ao nível inicial a cada janela. Para o refresh dar certo, a carga precisa estar acima do limiar no fim de cada janela, e as marcas de 32 e 64 ms mostram onde essas janelas caem.
4.6 SRAM e DRAM lado a lado, e a conta do custo por bit
Depois dos mecanismos, a comparação cabe numa tabela. Cada linha tem sua explicação nas seções anteriores.
| Característica | SRAM | DRAM |
|---|---|---|
| Peças por bit | Seis transistores | Um transistor e um capacitor |
| Leitura | Direta: a célula dirige a linha de bit | Destrutiva: exige regravação |
| Refresh | Não precisa | Precisa. Janela de 64 ms no exemplo de Drepper, e 32 ms em DDR5 segundo a Wikipedia |
| Densidade | Menor | Maior: célula muitas vezes menor, segundo Drepper |
| Custo por bit | Maior | Menor, segundo a nota da MSU |
| Uso típico nesta trilha | Cache | Memória principal |
A tabela pede uma conta. O custo de uma memória tem várias partes, como silício, processo de fabricação, encapsulamento e volume de venda, e a aula não tem preço de mercado para nenhuma delas. Mas a parte que depende só da arquitetura da célula pode ser contada. Contar peças por bit é uma primeira aproximação honesta: ela não diz o preço, mas diz quanto silício cada bit exige. Para 1 GiB, são 8 × 2³⁰ bits, cerca de 8,59 × 10⁹ bits. Em SRAM, isso dá 6 × 8,59 × 10⁹, cerca de 5,15 × 10¹⁰ transistores. Em DRAM, dá 8,59 × 10⁹ transistores e a mesma quantidade de capacitores. A razão de transistores é 6 para 1, e a seção 7 reproduz o número com o programa. O capacitor da DRAM, porém, é uma estrutura diferente do transistor, e a aula não compara áreas em micrômetros quadrados. Por isso a conta diz quantas peças existem, e não quanto cada uma custa.
Uma leitura rápida da tabela: a SRAM troca peças por velocidade, e a DRAM troca manutenção por densidade.
4.7 Flash: carga presa numa porta isolada
A célula flash parte de um MOSFET comum com uma porta extra. Essa porta extra se chama porta flutuante, porque não tem ligação elétrica com nada, e fica isolada por uma camada de óxido. Segundo a Wikipedia, os elétrons colocados nela ficam presos, porque a camada isolante os envolve. A carga presa bloqueia parte do campo elétrico da porta de controle, e a Wikipedia diz que isso aumenta a tensão de limiar, VT, a partir da qual o transistor conduz. Essa diferença é o que a leitura detecta: uma tensão intermediária na porta de controle faz o transistor conduzir ou não, conforme a carga presa.
A carga fica ali sem energia, e essa é a persistência da flash. O que a aula não confirmou é quantos anos ela dura, porque nenhuma fonte primária sobre isso foi lida. A seção de confirmação diz o que foi conferido.

Uma célula flash raramente aparece sozinha. A Wikipedia descreve a organização NAND como uma cadeia: a fonte de uma célula liga ao dreno da seguinte, e as células ligadas em série formam uma string. A figura desenha quatro células, C0 a C3, cada uma com a sua palavra WL0 a WL3 na porta. Para ler C2, a palavra WL2 vai a 0 V, que é o nível de leitura da célula escolhida. As outras palavras recebem uma tensão de passagem, que faz as células vizinhas conduzirem sem depender do próprio bit. Assim a corrente atravessa a cadeia inteira e chega à linha de bit, e o valor de C2 controla a passagem. Os transistores de seleção dos extremos, que completam a cadeia, não estão desenhados. A figura é uma cadeia simplificada, e a seção “O que não foi confirmado” diz o que ficou fora.
4.8 Páginas, blocos e a escrita em outra página
Uma string de NAND é organizada em páginas, e as páginas em blocos. Segundo a Wikipedia, leitura e programação acontecem por página, com páginas típicas de 4 KiB a 16 KiB. O apagamento acontece no bloco inteiro, que reúne várias páginas. Essa assimetria tem uma consequência direta: uma página que já tem dados não pode ser reescrita no mesmo lugar. O conteúdo novo vai para uma página livre, a antiga é marcada como inválida, e o bloco só volta a ser usado depois de apagado por inteiro.
A diferença para a NOR também pesa. A Wikipedia diz que a NOR oferece barramento de endereço completo e acesso aleatório, o que serve para executar código direto na memória. A NAND não oferece barramento externo de endereço aleatório, e os dados são lidos em páginas. Essa é a razão de a NAND servir para armazenamento em massa.
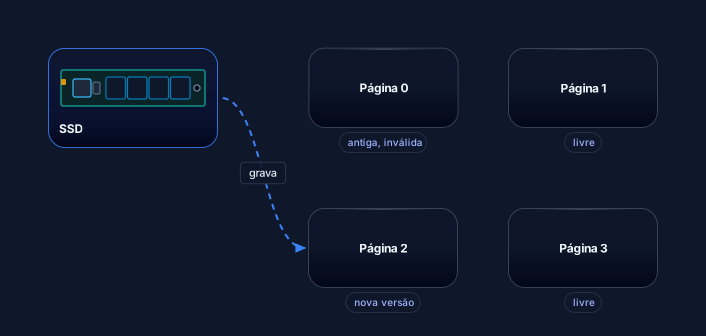
A figura mostra o caso mais comum. O SSD recebe a versão nova de um dado. A página 0 guarda a versão antiga, que agora está inválida e aparece com o estado de erro. A versão nova vai para a página 2, que estava livre. As páginas 1 e 3 continuam livres, e o bloco não é apagado nessa escrita. Quando as páginas livres acabarem, a controladora precisa copiar as páginas válidas para outro bloco e apagar o antigo, e esse apagamento é o custo discutido no erro 3 da seção 6. A figura não mostra a controladora nem os canais, porque a aula não confirmou a arquitetura de um SSD real.
4.9 Disco magnético: busca, espera e transferência
O disco guarda bits como orientação magnética num prato que gira, e uma cabeça de leitura fica sobre ele na ponta de um braço. Para ler um setor aleatório, três tempos se somam. Primeiro o braço move a cabeça até a trilha certa: é a busca. Depois a cabeça espera o setor desejado passar por baixo dela: é a latência de rotação. Por fim, o setor é transferido.
A latência de rotação média é meia volta do prato. A 7.200 rpm, uma volta dura 60.000 ms divididos por 7.200, cerca de 8,33 ms, e meia volta dá 4,17 ms. A Wikipedia tem essa mesma linha numa tabela de desempenho de HDD, o que confirma a conta. A busca média de 8,5 ms vem de uma ficha antiga da Seagate, de um modelo BarraCuda 7200.7, copiada em um site de manuais, e a ficha original não foi aberta nesta consulta. A própria Wikipedia dá cerca de 9 ms para unidades de mesa, sem citar fonte. Com 9 ms, o acesso aleatório fica em 13,17 ms, e a conclusão da seção 4.10 não muda.
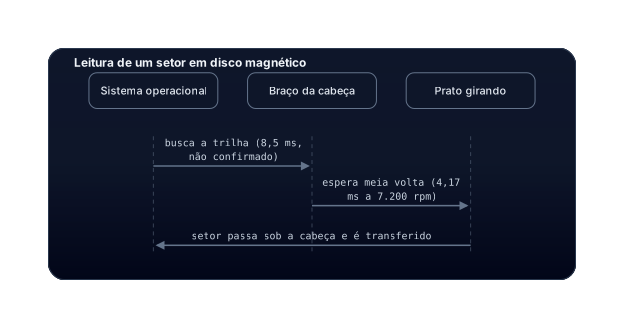
A sequência tem uma regra: o braço se move a cada setor aleatório, e o prato continua girando durante a busca. A figura mostra as três esperas em ordem. A busca de 8,5 ms está marcada como não confirmada, e a meia volta de 4,17 ms vem da conta a 7.200 rpm. A transferência do setor aparece como a última mensagem, mas não entra na conta da seção 4.10, porque a aula não mediu a taxa de transferência. A soma das duas esperas é um modelo simples, que supõe que o setor certo chega em posição aleatória quando o braço termina a busca.
4.10 Os números de uma CPU de referência
Os números desta aula usam a mesma CPU de referência da aula Hierarquia de memória e localidade: um núcleo Zen 4 convertido a 4,0 GHz, em que cada ciclo dura 0,25 ns. O artigo do Chips and Cheese sobre o Ryzen Z1, de 12 de fevereiro de 2024, dá as latências do núcleo: L1 de 4 ciclos, L2 de 14 ciclos e L3 um pouco acima de 50 ciclos. Para a memória principal, o mesmo artigo dá 123,9 ns no Z1, que usa LPDDR5, uma memória de aparelho portátil e não a DRAM DDR5 de um desktop.
A conversão para nanossegundos depende do clock, e o artigo não informa o clock do teste. Por isso os 4,0 GHz são uma convenção desta aula, e não uma medida. A diferença aparece no próprio artigo: o L3 do Z1 é dado como 14,16 ns, e o de núcleos Zen 4 de desktop como 10,46 ns. Com a convenção de 4,0 GHz, 50 ciclos viram 12,5 ns, e o L3 do Z1 corresponderia a cerca de 57 ciclos. A tabela abaixo usa a convenção, e a seção de confirmação mostra a faixa.
| Nível ou operação | Ciclos a 4,0 GHz | Tempo | Situação |
|---|---|---|---|
| L1 (SRAM) | 4 | 1 ns | Medido no artigo, em ciclos |
| L2 (SRAM) | 14 | 3,5 ns | Medido no artigo, em ciclos |
| L3 (SRAM) | cerca de 50 | 12,5 ns | Medido no artigo, em ciclos |
| DRAM (Z1, LPDDR5) | cerca de 496 | 123,9 ns | Medido no artigo, em ns |
| SSD NVMe | cerca de 60.000 | 15 µs | Não confirmado |
| Disco: busca de 8,5 ms mais meia volta | cerca de 50,7 milhões | 12,67 ms | Busca não confirmada, meia volta calculada |
Com essa escala, um acesso aleatório ao disco custa cerca de um milhão de vezes um acerto no L3. A conta exata sai do programa da seção 7, que dá a razão de 1,01 × 10⁶. O mesmo número aparece na tabela e na figura 10, e os dois vêm da mesma conta. A latência da DRAM da tabela é a do Z1, e a aula sobre cache, ainda não escrita, precisará de outra medida antes de generalizar esse valor.
5. Detalhes e bordas
A SRAM e a DRAM perdem o dado quando a energia cai, e isso é o que as torna voláteis. A diferença entre elas aparece enquanto a energia está ligada. A SRAM mantém o bit sem nenhuma atualização, porque o laço se sustenta. A DRAM precisa do refresh da seção 4.5 o tempo todo, mesmo com o computador ligado e em repouso.
Drepper menciona variantes da célula de seis transistores, sem detalhá-las no trecho consultado. A aula não mediu nenhuma delas.
A flash tem uma fragilidade que a DRAM não tem: o desgaste. A Wikipedia diz que a flash tem um número finito de ciclos de programação e apagamento, abreviados P/E, e que apagar a célula fica mais lento com o uso. O controlador do SSD tenta espalhar as escritas para que nenhum bloco se desgaste antes dos outros, mas essa prática não foi confirmada por fonte nesta aula. O que a aula confirma é a regra física: a célula não aguenta infinitas trocas.
A NOR e a NAND se dividem pelo tipo de acesso. A NOR serve para executar código, porque tem barramento de endereço completo. A NAND serve para guardar muita informação, porque lê em páginas. A seção 4.8 se concentra na NAND porque é a organização que a aula descreve para armazenamento em massa.
O disco magnético tem um detalhe que a conta da seção 4.9 deixa à mostra. Quando os setores lidos estão em sequência, o braço quase não se move, e a espera fica restrita à rotação. Quando os setores estão espalhados, cada leitura paga uma busca nova. É a mesma ideia de localidade da aula 4.1, aplicada a um meio mecânico.
6. Erros comuns e boas práticas
Erro 1: achar que SSD e RAM são a mesma coisa com preços diferentes. Quem já perdeu um arquivo que existia só na memória aprendeu a diferença sem precisar de tabela. A RAM é volátil, e o SSD é não volátil. A RAM responde em ciclos, e o SSD responde em microssegundos. Boa prática: decidir o que precisa sobreviver ao desligamento antes de decidir onde o dado mora.
Erro 2: achar que a DRAM guarda o bit sozinha, como um registrador. A DRAM depende do refresh do controlador, e uma DRAM que deixasse de ser atualizada perderia os dados. Boa prática: ao olhar para a memória principal, pensar nela como um serviço contínuo, que consome tempo e energia só para continuar sendo memória.
Erro 3: achar que reescrever uma página só mexe naquela página. Pelo que a seção 4.8 explica, reescrever uma página com dados exige colocar o conteúdo novo em outra página livre e, quando não há mais páginas livres, copiar o que está válido e apagar um bloco inteiro. Boa prática: agrupar escritas pequenas em blocos maiores, para que o custo de cópia e apagamento se espalhe por mais dados. A aula não mediu esse ganho, mas a conta sai da própria física.
Erro 4: medir um disco pela taxa de transferência e concluir que ele é rápido. A taxa vale para leituras sequenciais. Num acesso aleatório, a busca e a espera de rotação dominam a conta, como a seção 4.9 mostra com 12,67 ms. Boa prática: ler dados em sequência sempre que o programa permitir, e lembrar que essa é a localidade espacial da aula 4.1 em outro meio.
Erro 5: tratar a SRAM como memória mais rápida porque é mais cara. O preço sai do projeto da célula. A velocidade sai do mecanismo de leitura: o laço de seis transistores é rápido porque a própria célula dirige a linha de bit. Boa prática: comparar memórias pelo mecanismo de leitura, e não pela etiqueta de preço.
Erro 6: usar o número de transistores por bit como preço. A contagem da seção 4.6 mostra quanto silício cada bit exige, e não quanto ele custa. Preço depende também de processo, rendimento e volume, e nenhum desses entrou na conta. Boa prática: usar a contagem para comparar a arquitetura, e buscar preço em fonte de mercado antes de fechar uma decisão de compra.
7. O programa que confere as contas
O programa abaixo refaz as contas desta aula com a convenção de 4,0 GHz e com os valores das fontes. Ele não simula o circuito: só confere aritmética, para que nenhum número da aula dependa de uma conta de cabeça. A conta de transistores por GiB foi acrescentada nesta revisão e aparece na seção 4.6.
# Contas da aula 4.2 com a CPU de referência: núcleo Zen 4, convertido a 4,0 GHz.
clock_hz = 4.0e9
ciclo_ns = 1e9 / clock_hz
print(f"ciclo a 4,0 GHz: {ciclo_ns:.2f} ns")

# Refresh: 8192 linhas, janela de 64 ms, um comando por linha por janela
linhas = 8192
janela_ms = 64
intervalo_us = janela_ms * 1000 / linhas
comandos_por_s = linhas / (janela_ms / 1000)
print(f"intervalo entre comandos de refresh: {intervalo_us:.4f} us")
print(f"comandos de refresh por segundo: {comandos_por_s:.0f}")

# Disco a 7200 rpm, busca média de 8,5 ms (ficha antiga, não confirmada)
rpm = 7200
meia_volta_ms = 60_000 / rpm / 2
busca_ms = 8.5
acesso_ms = busca_ms + meia_volta_ms
print(f"meia volta a 7200 rpm: {meia_volta_ms:.2f} ms")
print(f"busca mais espera de meia volta: {acesso_ms:.2f} ms")

# Comparação com o L3 de 50 ciclos
l3_ns = 50 * ciclo_ns
print(f"L3 de 50 ciclos: {l3_ns:.1f} ns")
print(f"disco em ciclos: {acesso_ms * 1e6 / ciclo_ns:.2e}")
print(f"vezes mais lento que o L3: {acesso_ms * 1e6 / l3_ns:.2e}")

# Compartilhamento de carga, modelo simplificado da MSU, com Cbit = 10 Cs
Cs, Cbit, Vs = 1.0, 10.0, 1.0
Vf = Cs * Vs / (Cs + Cbit)
print(f"tensão final na linha de bit (Cbit = 10 Cs, Vs = 1): {Vf:.4f} = Vs / 11")

# Transistores e capacitores por byte e por GiB
bits_por_byte = 8
bits_gib = 8 * 2**30
print(f"1 byte em SRAM 6T: {bits_por_byte * 6} transistores")
print(f"1 byte em DRAM 1T1C: {bits_por_byte} transistores e {bits_por_byte} capacitores")
sram_gib = bits_gib * 6
dram_gib = bits_gib
print(f"1 GiB em SRAM 6T: {sram_gib:.3e} transistores")
print(f"1 GiB em DRAM 1T1C: {dram_gib:.3e} transistores e {dram_gib:.3e} capacitores")
print(f"razão de transistores SRAM/DRAM: {sram_gib / dram_gib:.0f}")
O programa foi executado com python3 -I contas.py, no modo isolado, e esta é a saída real:
ciclo a 4,0 GHz: 0.25 ns
intervalo entre comandos de refresh: 7.8125 us
comandos de refresh por segundo: 128000
meia volta a 7200 rpm: 4.17 ms
busca mais espera de meia volta: 12.67 ms
L3 de 50 ciclos: 12.5 ns
disco em ciclos: 5.07e+07
vezes mais lento que o L3: 1.01e+06
tensão final na linha de bit (Cbit = 10 Cs, Vs = 1): 0.0909 = Vs / 11
1 byte em SRAM 6T: 48 transistores
1 byte em DRAM 1T1C: 8 transistores e 8 capacitores
1 GiB em SRAM 6T: 5.154e+10 transistores
1 GiB em DRAM 1T1C: 8.590e+09 transistores e 8.590e+09 capacitores
razão de transistores SRAM/DRAM: 6
A saída confere com o texto: o ciclo de 0,25 ns, o refresh a cada 7,8125 µs, o disco de 12,67 ms, a razão de cerca de um milhão e a razão de 6 em transistores por GiB. O valor de 0,0909 é a fração do modelo simplificado e não é uma medida de chip.
8. Exercícios
- Um byte é guardado em SRAM de seis transistores e, em outro chip, em DRAM de um transistor e um capacitor. Quantos transistores cada um usa para esse byte, e quantos capacitores a DRAM usa?
Resposta: a SRAM usa 8 × 6 = 48 transistores. A DRAM usa 8 transistores e 8 capacitores. A conta é a mesma linha do programa da seção 7.
- Um chip de DRAM tem 8192 linhas e uma janela de refresh de 64 ms. Qual é o intervalo médio entre dois comandos de refresh, e quantos comandos saem por segundo, supondo um comando por linha a cada janela?
Resposta: 64 ms dividido por 8192 dá 7,8125 µs. Como são 8192 comandos a cada 64 ms, saem 128 000 comandos por segundo. A suposição de um comando por linha é o exemplo de Drepper, e não a especificação de um chip atual.
- Um disco a 7.200 rpm tem busca média de 8,5 ms. Quanto leva um acesso aleatório que espera meia volta, e quantas vezes ele é mais lento que um acerto no L3 de 50 ciclos, a 4,0 GHz?
Resposta: 8,5 ms mais 4,17 ms dão 12,67 ms. O L3 de 50 ciclos, a 4,0 GHz, leva 12,5 ns. A razão é de cerca de 1,01 milhão. O resultado depende da busca de 8,5 ms, que vem de uma ficha antiga e está marcada como não confirmada. Com a busca de 9 ms, citada pela Wikipedia sem fonte, o acesso sobe para 13,17 ms, e a razão para cerca de 1,05 milhão.
- Por que um SSD não reescreve uma página no mesmo lugar?
Resposta: uma página só é programada depois que o bloco que a contém foi apagado. Como o apagamento acontece no bloco inteiro, reescrever uma página com dados exige colocar o conteúdo novo em outra página livre e marcar a antiga como inválida. Quando não há página livre, o bloco válido precisa ser copiado e o bloco inteiro apagado antes. Por isso a reescrita tem custo de cópia e, às vezes, de apagamento.
- Por que a leitura de uma DRAM precisa ser seguida de uma regravação?
Resposta: a leitura divide a carga do capacitor com a linha de bit, e isso esvazia o capacitor. A saída do amplificador de leitura é enviada de volta ao capacitor para recarregá-lo. Sem essa regravação, o valor lido não ficaria guardado na célula.
- No núcleo da SRAM, Q vale 1. Quanto vale Qn, e por quê?
Resposta: Qn vale 0. A porta de P2 e a de N2 recebem Q igual a 1: o PMOS desliga e o NMOS conduz, puxando Qn para 0. Esse 0 chega às portas de P1 e N1, que mantêm Q em 1. Os dois lados do laço ficam consistentes, e é por isso que o estado se sustenta.
- Um chip de SRAM e um de DRAM têm a mesma capacidade de 1 GiB, e a aula conta só transistores. Quantos transistores cada chip tem, e quantos capacitores tem a DRAM? Por que essa conta não basta para dizer qual dos dois custa mais?
Resposta: a SRAM tem 6 × 2³³ bits, cerca de 5,15 × 10¹⁰ transistores. A DRAM tem 2³³ bits, cerca de 8,59 × 10⁹ transistores e a mesma quantidade de capacitores. A conta mostra que a SRAM exige seis vezes mais transistores. Ela não basta para dizer o custo, porque o preço depende também da área de cada estrutura, do processo de fabricação, do rendimento e do volume. A aula não tem esses dados.
9. Glossário
Bit: menor quantidade de informação, um valor 0 ou 1.
Célula: menor parte de um chip de memória que guarda um bit.
Volátil: memória que perde o conteúdo quando a energia some.
Não volátil: memória que mantém o conteúdo sem energia.
SRAM: memória estática feita de laços de transistores, rápida e cara por bit, que não precisa de refresh enquanto há energia.
DRAM: memória dinâmica feita de um transistor e um capacitor por bit, mais barata e densa, que precisa de refresh.
Capacitor: componente que guarda carga elétrica, e é a peça que guarda o bit numa DRAM.
Transistor de acesso: transistor que liga uma célula à linha de bit quando a linha de palavra está ativa.
Linha de palavra (WL): fio que controla os transistores de acesso de uma linha de células.
Linha de bit (BL e BLn): fios por onde o bit é lido e escrito. BLn é a linha complementar de BL.
Pré-carga: colocação das linhas de bit em um nível conhecido antes de uma leitura.
Amplificador de leitura: circuito que compara as duas linhas de bit e decide o valor pela diferença entre elas.
Leitura destrutiva: leitura que altera o conteúdo da célula, como na DRAM, e por isso exige regravação.
Refresh: leitura seguida de regravação, feita periodicamente para repor a carga que escoa do capacitor.
Retenção: tempo que uma célula mantém o bit sem atualização.
Limiar de leitura: nível de carga ou de tensão abaixo do qual o circuito lê o outro valor.
Porta flutuante: porta isolada de um transistor flash, sem ligação elétrica, onde os elétrons ficam presos.
Tensão de passagem: tensão aplicada às palavras não lidas de uma cadeia NAND, para que as células vizinhas conduzam.
NAND: tipo de flash organizado em cadeias, lido e escrito em páginas e apagado em blocos.
NOR: tipo de flash com barramento de endereço completo, que permite acesso aleatório a cada byte.
Página: menor unidade de leitura e programação de uma NAND.
Bloco: menor unidade de apagamento de uma NAND, formada por várias páginas.
Controladora: circuito do SSD que recebe os pedidos do sistema e os distribui pelos chips.
Busca (seek): movimento do braço do disco até a trilha desejada.
Latência de rotação: espera até o setor desejado passar sob a cabeça de leitura.
Rpm: rotações por minuto do prato do disco.
O que não foi confirmado
Os números de tempo desta aula vêm de uma fonte primária, do próprio artigo do Chips and Cheese, e de contas que o texto indica. Mesmo assim, há lacunas que precisam ser ditas com clareza.
A CPU de referência usa 4,0 GHz como convenção, porque o artigo do Chips and Cheese não informa o clock do teste. O mesmo artigo dá 14,16 ns de L3 no Z1 e 10,46 ns para núcleos Zen 4 de desktop. Com 4,0 GHz, esses valores equivalem a cerca de 57 e 42 ciclos. Os ciclos da tabela da seção 4.10 valem para a convenção, e não para um clock medido.
A busca média de 8,5 ms vem de uma ficha de modelo antigo, a BarraCuda 7200.7, copiada em um site de manuais. A ficha original da Seagate devolveu erro 403 nesta consulta, e nenhum modelo atual foi verificado. A Wikipedia dá cerca de 9 ms para unidades de mesa, sem citação. Os 4,17 ms de meia volta são cálculo a partir dos 7.200 rpm, e a soma das duas esperas é um modelo: ela supõe que o setor certo chega em posição aleatória ao fim da busca.
A latência de leitura de uma página NAND e de um SSD inteiro não foi confirmada. A aula não cita número de datasheet para isso. A aula 4.1 dá 15 µs para um SSD NVMe, e esse valor também não foi verificado aqui.
A latência de 123,9 ns da DRAM é do Z1, com LPDDR5, e não de uma DRAM DDR5 de desktop. A aula não tem outra medida de DRAM de desktop com fonte primária nesta consulta. O intervalo de 60 a 90 ns que aparecia em versões anteriores da aula 4.1 não tem fonte e não entra nesta aula.
Os valores de 32 ms e de 16 ms para DDR5 vêm da Wikipedia e não foram conferidos no texto do JEDEC. Um valor de tREFI de 3,9 µs apareceu em resultado de busca, citando uma nota da Micron, mas essa nota não foi lida, e por isso o valor não entra no texto como fato. O exemplo de 8192 linhas e 7,8125 µs descreve a organização de um chip da época do texto de Drepper, de 2007, e não de um DDR5.
O tempo de retenção de uma célula flash sem energia não foi confirmado. Afirmações sobre anos de retenção apareceram em resultados de busca, sem leitura de fonte primária. O texto desta aula não diz quantos anos.
O tempo de retenção de uma DRAM sem refresh também não foi confirmado. A nota da MSU traz um exemplo didático, com corrente de fuga de 1 nA e capacitor de 50 fF, que dá cerca de 50 µs. Esse número é uma estimativa de aula, não uma especificação, e não concorda com a janela de 64 ms. A aula não resolve a diferença.
A pré-carga da leitura de SRAM não foi conferida em chip específico. A figura 03 e a figura 04 adotam BL e BLn em 1 V antes da leitura. A nota da MSU fala em pré-carga das linhas de bit, sem detalhar em todo o ciclo a polaridade de BLn. Nenhuma fonte de fabricante foi consultada para resolver essa diferença.
Os símbolos de transistor das figuras 02, 03 e 08 são blocos ci de três pinos, porque o ArchFlow não tem elemento de transistor. Eles não têm a bolinha que marca PMOS, e a figura 02 usa o rótulo do nome para dizer qual é qual. A figura 03 representa o núcleo como um bloco com as saídas q e qn, e não desenha os seis transistores ao mesmo tempo. A figura 08 omite os transistores de seleção dos extremos da cadeia NAND.
A conta de compartilhamento de carga usa Cbit igual a dez vezes Cs apenas como exemplo. A aula não confirmou a relação entre a capacitância da célula e a da linha em nenhum chip.
A tensão de passagem das palavras não lidas da cadeia NAND aparece na figura 08 como “passagem”, sem valor. O valor real não foi consultado.
A figura 07 é uma curva esquemática, com constante escolhida para o desenho. A figura 09 mostra o caso mais simples de escrita, e não a controladora de um SSD real. A figura 10 não desenha a transferência em escala de tempo.
As figuras de DRAM e de SRAM mostram a leitura de uma célula. Elas não mostram o comportamento de um banco inteiro de memória, nem o tempo de decodificação de endereço.
A flash tem variantes, como a charge-trap usada em flash 3D, que apareceram em resultados de busca, mas não foram lidas em fonte primária, e por isso não entram no texto.
Os mecanismos de tunelamento de Fowler-Nordheim e de desgaste descritos na seção 4.7 e na seção 5 vêm da leitura da Wikipedia feita em 2 de novembro de 2026. Nesta revisão, conferi de novo a porta flutuante, o aumento da tensão de limiar, a cadeia NAND, as páginas de 4 a 16 KiB, a leitura por página e a falta de barramento de endereço aleatório. O nome técnico Fowler-Nordheim e a lista de causas do desgaste não foram reconferidos nesta revisão.
A descrição da tradução de endereços do SSD e a escrita em páginas de uma controladora de fabricante não foram confirmadas. A figura 09 é um modelo.
As categorias de velocidade e custo da figura 01 são qualitativas. A aula não mediu preço por gigabyte, e não há valor de mercado para nenhuma das famílias nesta consulta.
Fontes
Consultadas em 2 de novembro de 2026.
- Drepper, Ulrich. What Every Programmer Should Know About Memory. Red Hat, 21 nov. 2007 (versão 1.0). Seções 2.1.1 (SRAM), 2.1.2 (DRAM) e o trecho sobre refresh a cada 64 ms, o exemplo de 8192 linhas e o limite de 50 % dos acessos em algumas cargas. Disponível em: https://people.freebsd.org/~lstewart/articles/cpumemory.pdf
- Mason, A. ECE 410, Lecture Notes 13.2 a 13.22, sobre a célula SRAM de seis transistores, os modos hold e read, a célula DRAM de um transistor, a equação de compartilhamento de carga, a leitura destrutiva e o refresh. Michigan State University. Disponível em: https://www.egr.msu.edu/classes/ece410/mason/files/Ch13.pdf
- Wikipedia (em inglês). “Flash memory”, seções sobre a porta flutuante, a tensão de limiar, as cadeias NAND, as páginas de 4 KiB a 16 KiB, a leitura por página, o apagamento por bloco, a falta de barramento de endereço aleatório e os ciclos de programação e apagamento. Disponível em: https://en.wikipedia.org/wiki/Flash_memory
- Wikipedia (em inglês). “Hard disk drive performance characteristics”, tabela de latência de rotação de 7.200 rpm (4,17 ms) e a menção a cerca de 9 ms de busca em unidades de mesa, sem citação. Disponível em: https://en.wikipedia.org/wiki/Hard_disk_drive_performance_characteristics
- Wikipedia (em inglês). “DDR5 SDRAM”, seção sobre refresh. Janela de 32 ms até 85 °C e de 16 ms entre 85 °C e 95 °C. Disponível em: https://en.wikipedia.org/wiki/DDR5_SDRAM
- Chips and Cheese. “AMD’s Mild Hybrid Strategy: Ryzen Z1 in ASUS’s ROG Ally”, publicado em 12 de fevereiro de 2024. L1 de 4 ciclos, L2 de 14 ciclos, L3 um pouco acima de 50 ciclos, L3 de 14,16 ns no Z1, 10,46 ns em Zen 4 de desktop, e 123,9 ns de memória principal com LPDDR5. Disponível em: https://chipsandcheese.com/p/amds-mild-hybrid-strategy-ryzen-z1-in-asuss-rog-ally
- Seagate. BarraCuda 7200.7, ficha técnica antiga, citada em cópia de manual. A fonte original não pôde ser aberta nesta consulta (erro 403). Usada apenas para a busca média de 8,5 ms, marcada como não confirmada. Disponível em: https://manualmachine.com/seagate/barracuda72007/10193646-datasheet