Trilha de Kotlin · parte 45 de 59
Mensageria com Kafka
Por que pôr um broker entre dois sistemas, como o Kafka ordena e entrega mensagens, e um produtor e um consumidor em Kotlin com reentrega medida.
avançadoPublicada em · 12 min de leitura
Mensageria com Kafka
Pense no caderno de protocolo de uma repartição. Cada documento ganha uma linha numerada, ninguém arranca página, e cada setor deixa um dedo na última linha que leu. A analogia falha num ponto: a repartição tem um caderno só, e o Kafka divide cada fluxo em cadernos chamados partições. A ordem vale dentro de cada caderno, e só dentro dele.
A aula usa um caso só: quando um pagamento é confirmado, o serviço de pedidos publica um evento PedidoPago, e o faturamento o consome. O currículo cita o Azure Service Bus, mas esta aula usa o Kafka, cuja imagem oficial pôde ser executada aqui.
o mapa da aula
As seções 1 a 4 tratam do problema, do modelo, da ordem e das entregas. A 5 monta o código, a 6 faz os experimentos, e as 7 e 8 cuidam do reequilíbrio e do .
1. o problema da chamada síncrona
Imagine que o serviço de pedidos chama o faturamento com um POST e só responde ao cliente depois que o faturamento responde. Se o faturamento está fora do ar, a chamada falha, e o cliente vê erro para um pedido que já foi pago. Se ele está só lento, o pedido inteiro fica lento junto, porque a chamada síncrona herda a velocidade do mais lento. A mensageria afrouxa esse acoplamento. O serviço de pedidos grava o fato num , o servidor que guarda as mensagens, e responde ao cliente. O faturamento lê quando puder. A falha deixa de ser um erro imediato e vira atraso, mas surge uma peça a mais que precisa estar de pé: o próprio broker.
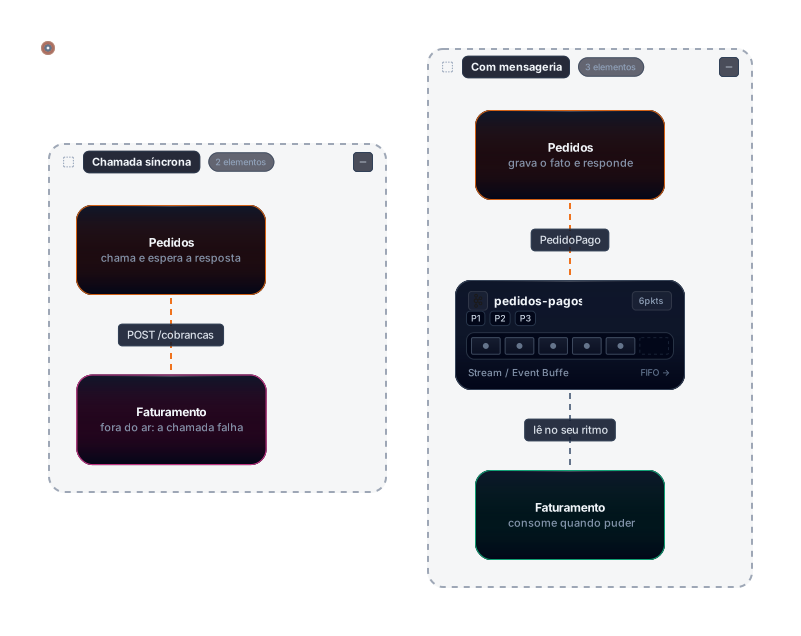
Na figura, a chamada de cima fica bloqueada, e o registro de baixo sobrevive à queda do consumidor.
2. o modelo do Kafka
Um broker guarda os registros e atende produtores e consumidores. Cada registro tem chave, valor e timestamp. Os registros entram num tópico, dividido em partições, que podem estar em brokers diferentes. Cada partição é uma sequência ordenada, e a posição de um registro nela é o , que começa em 0.
Produtor publica e consumidor lê. Consumidores com o mesmo identificador de grupo formam um grupo, e cada partição é consumida por exatamente um consumidor do grupo por vez. Cada grupo guarda o próprio offset. O broker desta aula é a imagem apache/kafka:4.2.2, com um nó e replicação 1. No log do contêiner, o metadado do cluster aparece no tópico interno __cluster_metadata, o que indica o modo KRaft, sem ZooKeeper.
3. ordem e
A introdução da documentação diz que eventos com a mesma chave caem na mesma partição, e que o consumidor lê os eventos de cada partição “in exactly the same order as they were written”. Pela documentação de design, o Kafka usa a chave para fazer um hash e escolher a partição.
Disso saem duas consequências. A ordem existe dentro da partição, nunca no tópico inteiro. E chaves diferentes podem cair na mesma partição e dividir a mesma ordem. Foi o que aconteceu na seção 5: bruno e carla caíram na partição 2.
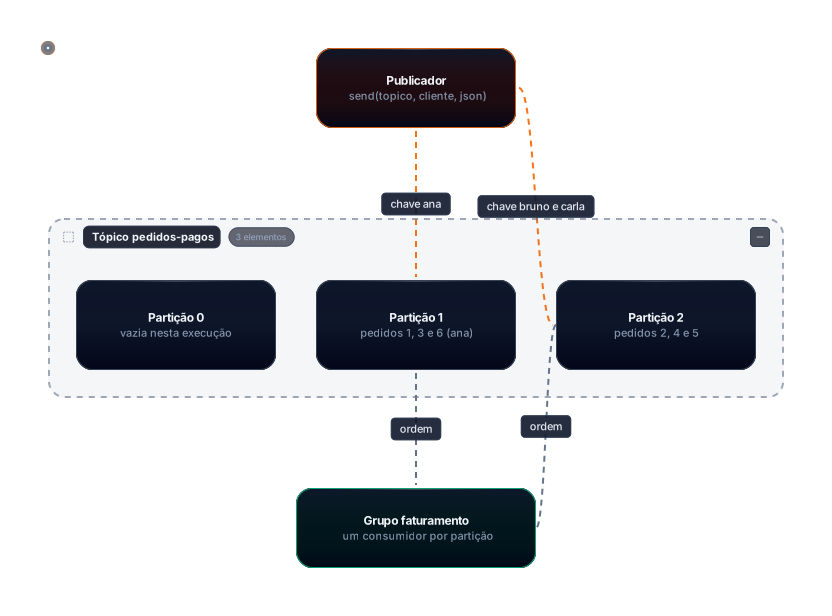
A figura reproduz a execução da seção 5.
4. entrega: três semânticas e a idempotência
A documentação de design define três semânticas. Em “at most once”, a mensagem pode se perder, mas não é reentregue. Em “at least once”, nenhuma se perde, e algumas podem chegar duas vezes. Em “exactly once”, cada mensagem é processada uma vez só. A diferença vem da ordem entre processar e gravar o offset: gravar antes permite perder, gravar depois permite reentregar. Por padrão, o Kafka garante “at-least-once delivery”. Exactly-once depende de transações e de cooperação do destino, e fica fora desta aula.
Como o padrão reentrega, o consumidor precisa ser idempotente: processar o mesmo registro duas vezes deve dar o mesmo resultado. No faturamento, isso significa conferir se o pedido já foi cobrado. A documentação dá o exemplo de chave primária, em que receber a mensagem duas vezes apenas “overwrites a record with another copy of itself”. Idempotência em APIs está em Design avançado de API: paginação, versionamento e idempotência.
Pergunta de entrevistaAt-most-once, at-least-once e exactly-once: o que você escolheria?
At-most-once pode perder mensagens, porque o offset é gravado antes do processamento. At-least-once não perde, mas pode reentregar, então o consumidor precisa ser idempotente. Exactly-once exige transações e a cooperação do destino. Eu escolho at-least-once com processamento idempotente, e trato exactly-once como efeito a ser construído, não como uma opção de configuração.
5. produtor e consumidor com Spring Kafka
O projeto usa spring-boot-starter-kafka. Com o Spring Boot 4.1.2, o BOM gerencia spring-kafka 4.1.2 e kafka-clients 4.2.2. O Kotlin foi fixado em 2.4.21, porque o BOM traz 2.3.21. O NewTopic cria o tópico com três partições. Conferi com kafka-topics --describe: PartitionCount: 3 e ReplicationFactor: 1.
import org.apache.kafka.clients.admin.NewTopic
import org.springframework.beans.factory.annotation.Value
import org.springframework.boot.autoconfigure.SpringBootApplication
import org.springframework.boot.runApplication
import org.springframework.context.annotation.Bean
import org.springframework.kafka.config.TopicBuilder

@SpringBootApplication
class AplicacaoKafka {
    @Bean
    fun topico(@Value("\${app.topico}") nome: String): NewTopic =
        TopicBuilder.name(nome).partitions(3).replicas(1).build()
}

fun main(args: Array<String>) {
    runApplication<AplicacaoKafka>(*args)
}
O produtor é um KafkaTemplate, que segundo a documentação “wraps a producer and provides convenience methods to send data to Kafka topics”. O .get() espera a confirmação do broker só para o experimento terminar. Em produção ele bloqueia a thread, e o retorno deve ser tratado de forma assíncrona. A injeção pelo construtor segue Injeção de dependência e IoC no Spring.
import kotlinx.serialization.Serializable

@Serializable
data class PedidoPago(val id: Int, val cliente: String, val valor: Int)
import kotlinx.serialization.json.Json
import org.springframework.beans.factory.annotation.Value
import org.springframework.boot.ApplicationArguments
import org.springframework.boot.ApplicationRunner
import org.springframework.kafka.core.KafkaTemplate
import org.springframework.stereotype.Component
@Component
class Publicador(
private val kafka: KafkaTemplate<String, String>,
@Value("\${app.topico}") private val topico: String,
@Value("\${app.publicar:false}") private val publicar: Boolean,
@Value("\${app.invalido-id:0}") private val invalidoId: Int,
@Value("\${app.clientes:ana,bruno,ana,carla,bruno,ana}") private val clientes: List<String>,
) : ApplicationRunner {
override fun run(args: ApplicationArguments) {
if (!publicar) return
clientes.forEachIndexed { i, cliente ->
val id = i + 1
val valor = if (id == invalidoId) -1 else id * 100
val json = Json.encodeToString(PedidoPago(id, cliente, valor))
kafka.send(topico, cliente, json).get()
}
println("publicados ${clientes.size} pedidos")
}
}O valor viaja como String com JSON, produzido por kotlinx.serialization; a escolha entre bibliotecas está em Serialização com kotlinx.serialization e Jackson. O ConsumerRecord expõe partição e offset.
import kotlinx.serialization.json.Json
import org.apache.kafka.clients.consumer.ConsumerRecord
import org.springframework.beans.factory.annotation.Value
import org.springframework.kafka.annotation.KafkaListener
import org.springframework.stereotype.Component

@Component
class ConsumidorFaturamento(
    @Value("\${app.pausa-id:0}") private val pausaId: Int,
) {
    @KafkaListener(topics = ["\${app.topico}"], groupId = "faturamento")
    fun consumir(registro: ConsumerRecord<String, String>) {
        val pedido = Json.decodeFromString<PedidoPago>(registro.value())
        println("recebido pedido=${pedido.id} particao=${registro.partition()} offset=${registro.offset()}")
        require(pedido.valor > 0) { "valor inválido: ${pedido.valor}" }
        if (pedido.id == pausaId) {
            println("travou no pedido=${pedido.id}")
            Thread.sleep(60_000)
        }
        println("processado pedido=${pedido.id}")
    }
}app:
topico: pedidos-pagos
spring:
main:
banner-mode: off
kafka:
bootstrap-servers: localhost:9092
consumer:
auto-offset-reset: earliest
listener:
ack-mode: record
logging:
level:
org.apache.kafka: WARN
org.springframework.kafka: WARNCom seis pedidos publicados, o consumidor lê as duas partições com offsets próprios. A saída está filtrada: mantive só as linhas que o programa escreve.
publicados 6 pedidos
recebido pedido=2 particao=2 offset=0
processado pedido=2
recebido pedido=4 particao=2 offset=1
processado pedido=4
recebido pedido=5 particao=2 offset=2
processado pedido=5
recebido pedido=1 particao=1 offset=0
processado pedido=1
recebido pedido=3 particao=1 offset=1
processado pedido=3
recebido pedido=6 particao=1 offset=2
processado pedido=6
Os pedidos 1, 3 e 6 (ana) estão na partição 1, com offsets 0 a 2. Os pedidos 2, 4 e 5 (bruno, carla e bruno) estão na partição 2, com offsets 0 a 2. A ordem entre as partições não aparece porque não é garantida.
6. e falha no meio
O grupo grava no broker até onde leu. O Spring Kafka define enable.auto.commit como false a partir da versão 2.3, e o modo padrão é BATCH. Aqui usamos RECORD, que grava o offset “when the listener returns after processing the record”.
Os experimentos desta seção usaram um tópico novo, pedidos-exp2, e não o pedidos-pagos da seção 5. Nele, os seis registros caíram todos na partição 1, o que não bate com a distribuição da seção 5. Não investiguei a causa. Os offsets abaixo valem para essa execução.
O primeiro experimento mata o consumidor no meio do processamento. O programa imprime travou no pedido=3 e dorme 60 segundos. Então recebe kill -9, que encerra o processo sem gravar nada.
publicados 6 pedidos
recebido pedido=1 particao=1 offset=0
processado pedido=1
recebido pedido=2 particao=1 offset=1
processado pedido=2
recebido pedido=3 particao=1 offset=2
travou no pedido=3
Depois do kill, o grupo estava assim (colunas de identificação do consumidor omitidas, porque variam):
GROUP        TOPIC         PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
faturamento  pedidos-exp2  0          -               0               -
faturamento  pedidos-exp2  1          2               6               4
faturamento  pedidos-exp2  2          -               0               -
O CURRENT-OFFSET 2 mostra que os offsets 0 e 1 foram commitados, e o LOG-END-OFFSET 6 que existem seis registros.
O segundo experimento sobe o mesmo programa sem publicar nada.
recebido pedido=3 particao=1 offset=2
processado pedido=3
recebido pedido=4 particao=1 offset=3
processado pedido=4
recebido pedido=5 particao=1 offset=4
processado pedido=5
recebido pedido=6 particao=1 offset=5
processado pedido=6
O pedido 3 foi relido no offset 2. Os pedidos 1 e 2 não voltaram. A primeira reentrega chegou 44,1 segundos depois do kill -9. Esse número se aproxima do session.timeout.ms padrão de 45 segundos, que a documentação define como o tempo em que o broker espera heartbeats antes de remover o cliente. A ligação causal é inferência minha a partir do número: não olhei os logs internos do broker.
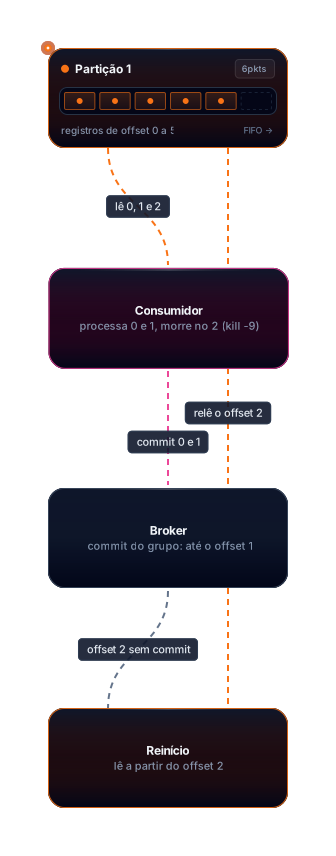
A figura resume a sequência: o commit para em 1, e o reinício volta ao 2.
O terceiro experimento faz o processamento falhar sem matar o processo. O pedido 3 ganha valor negativo, e o require lança IllegalArgumentException.
publicados 6 pedidos
recebido pedido=1 particao=1 offset=0
processado pedido=1
recebido pedido=2 particao=1 offset=1
processado pedido=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=3 particao=1 offset=2
recebido pedido=4 particao=1 offset=3
processado pedido=4
recebido pedido=5 particao=1 offset=4
processado pedido=5
recebido pedido=6 particao=1 offset=5
processado pedido=6
O DefaultErrorHandler tenta de novo o mesmo registro. A documentação diz que o padrão é FixedBackOff(0L, 9), nove novas tentativas sem espera. A saída mostra dez entregas do pedido 3. Depois, o registro é apenas registrado no log e seu offset é commitado, e o consumidor segue no pedido 4. O pedido 3 sai do fluxo, e a única marca dele é uma linha de erro.
7. reequilíbrio do grupo
Quando um consumidor entra ou sai, o broker redistribui as partições entre os membros restantes, e cada partição continua com um consumidor por vez. Não medi um grupo com dois consumidores nesta aula.
8. dead letter topic
Para não perder o registro que esgotou as tentativas, o Spring Kafka oferece o DeadLetterPublishingRecoverer, que publica o registro falho num outro tópico para inspeção e reprocessamento. Esse recoverer não foi executado nesta aula.
9. erros comuns e boas práticas
Quem diz que nunca viu uma mensagem processada duas vezes ainda não deixou um consumidor cair no meio de um pedido.
Tratar “exactly once” como botão de configuração. A garantia depende de transações e de cooperação do destino.
Commitar antes de processar. Se o processo cai depois do commit, o pedido some e nunca é cobrado. A ordem certa é processar e depois commitar, aceitando a reentrega.
Consumidor sem idempotência cobra duas vezes na primeira reentrega.
Trocar a chave por algo que muda a cada evento espalha os pedidos de um cliente por partições diferentes, e a ordem por cliente se perde.
10. exercícios
Exercício 1, guiado. Mude a pausa para o pedido 5 e preveja quais pedidos voltam depois do kill -9. Depois rode.
Resposta: voltam os pedidos 5 e 6. O 5 estava em processamento e não foi commitado, e o 6 nunca tinha sido lido. Os pedidos 1 a 4 já tinham commit. Essa previsão vale para o tópico pedidos-exp2, onde a seção 6 põe todos os registros na partição 1.
recebido pedido=5 particao=1 offset=4
processado pedido=5
recebido pedido=6 particao=1 offset=5
processado pedido=6
Exercício 2. Na primeira execução, troque ack-mode para batch e preveja o que o reinício processa.
Resposta: com BATCH, o offset só é gravado ao fim do poll, e o travamento vem antes. Nada foi commitado, e o reinício volta ao início. Abaixo está a saída do reinício. A saída da primeira execução não foi copiada para a nota:
recebido pedido=1 particao=1 offset=0
processado pedido=1
recebido pedido=2 particao=1 offset=1
processado pedido=2
recebido pedido=3 particao=1 offset=2
processado pedido=3
recebido pedido=4 particao=1 offset=3
processado pedido=4
recebido pedido=5 particao=1 offset=4
processado pedido=5
recebido pedido=6 particao=1 offset=5
processado pedido=6
11. glossário
- Broker: servidor que guarda os registros e atende produtores e consumidores.
- Tópico e partição: fluxo de registros e sequência ordenada dentro dele, onde a ordem vale.
- Offset: posição do registro na partição, a partir de 0.
- Chave: valor que define a partição, por hash.
- Grupo de consumidores: consumidores com o mesmo
group.id, que dividem as partições. - Commit de offset: gravação do ponto até onde o grupo leu.
- Reentrega e idempotência: nova entrega do registro sem commit, e processamento cujo resultado não muda ao repetir.
- Dead letter topic: tópico para registros que falharam além das tentativas.
o que não foi confirmado ou medido
- Ambiente: Mac com Apple silicon, Docker Desktop, broker de um nó. Não testei cluster, falha de broker, TLS nem autenticação.
- Rodadas: as saídas vêm de JDK 25, e tudo foi refeito com JDK 21 (Temurin 21.0.8), com contêiner novo em cada JDK. As saídas dos experimentos são iguais nas duas. A reentrega foi de 44,1 s com JDK 25 e de 45,5 s com JDK 21, uma medição por rodada. Os exercícios rodaram só com JDK 25.
- Partições: a distribuição depende do número de partições e do hash, e os valores valem para esta configuração.
- Distribuição divergente: a seção 5 (tópico
pedidos-pagos) e a seção 6 (pedidos-exp2) mostram partições diferentes para as mesmas chaves. A causa não foi investigada. - Saídas: filtradas para as linhas que o programa escreve.
- Não executado: dead letter topic, exactly-once, reequilíbrio com dois consumidores, Testcontainers para Kafka, Schema Registry, Kafka Streams e Kafka Connect.
- Versões: Spring Boot 4.1.2 é a última versão final da linha 4.1.x no Maven Central. As outras aulas da fase 6 usam 4.1.1, Kotlin 2.3.21 e Maven, e esta aula usa Gradle e Kotlin 2.4.21, sem teste cruzado com elas.
Fontes
Consultadas em 04/11/2026.
- Apache Kafka 4.2, Design: https://kafka.apache.org/42/design/design/
- Apache Kafka 4.2, Introdução: https://kafka.apache.org/42/getting-started/introduction/
- Apache Kafka 4.2, configurações do consumidor: https://kafka.apache.org/42/configuration/consumer-configs/
- Spring for Apache Kafka 4.1.2, commit de offsets: https://docs.spring.io/spring-kafka/reference/kafka/receiving-messages/message-listener-container.html
- Spring for Apache Kafka 4.1.2, tratamento de erros: https://docs.spring.io/spring-kafka/reference/kafka/annotation-error-handling.html
- Spring for Apache Kafka 4.1.2, serialização: https://docs.spring.io/spring-kafka/reference/kafka/serdes.html
- Spring for Apache Kafka 4.1.2, envio de mensagens: https://docs.spring.io/spring-kafka/reference/kafka/sending-messages.html
- BOM do Spring Boot 4.1.2: https://repo1.maven.org/maven2/org/springframework/boot/spring-boot-dependencies/4.1.2/spring-boot-dependencies-4.1.2.pom
Relacionados
- Nova ordem da trilha de Kotlin
- Serialização com kotlinx.serialization e Jackson
- Exceções e primeiro teste automatizado
- Testes com Kotest, MockK e Testcontainers
- Spring Boot com controllers suspend
- HTTP e REST
- Clientes HTTP com RestClient e WebClient
- Design avançado de API: paginação, versionamento e idempotência
- Injeção de dependência e IoC no Spring