Trilha de Kotlin · parte 46 de 59
SQL e modelagem relacional essencial
Tabelas, chaves, restrições, JOIN, agregação e normalização com clientes e pedidos, rodados no PostgreSQL 18.6 antes de qualquer ORM.
intermediárioPublicada em · 12 min de leitura
SQL e modelagem relacional essencial
Pense num caderninho de fiado de padaria. O padeiro anota o que cada freguês levou, e tudo parece certo até o mesmo cliente aparecer com duas grafias do nome. Um banco relacional é esse caderninho com regras: ele recusa o que quebra as regras antes de gravar. A analogia falha porque o padeiro faz a conta de cabeça, e o banco precisa do SQL para pedir a conta.
Esta aula não usa Spring nem JPA. Roda no psql, num contêiner com o PostgreSQL 18.6, a versão estável mais recente segundo a página oficial consultada em 04/11/2026. Não testei na 17. Para reproduzir:
docker run -d --name pg-sql-aula -e POSTGRES_PASSWORD=aula71 -p 127.0.0.1:5439:5432 postgres:18.6
docker exec pg-sql-aula psql -U postgres -c "CREATE DATABASE loja;"
docker exec -it pg-sql-aula psql -U postgres -d loja
Se o CREATE DATABASE falhar logo após o docker run, espere o servidor subir. As saídas usam -P null=NULL, que exibe . No psql interativo, use \pset null NULL.
o mapa da aula
Tabelas, tipos, comandos, modelagem, índice e , nessa ordem, com erros comuns, exercícios e glossário no fim.
1. por que um banco relacional
No servidor da aula HTTP e REST, os pedidos sumiam ao reiniciar, porque ficavam na memória do processo. Ele também recebe uma consulta em SQL e escolhe como executá-la, e recusa dados que violam as regras declaradas.
2. o modelo relacional: , linha, coluna e chaves
Uma tabela guarda um tipo de coisa: cada linha é uma ocorrência, e cada coluna é um atributo com tipo. A (PRIMARY KEY) identifica a linha. A (FOREIGN KEY) aponta para a chave de outra tabela, e o banco confere que o valor exista. Um cliente tem muitos pedidos (1:N). Um pedido tem muitos produtos, e um produto aparece em muitos pedidos (N:N). A N:N usa a itens_pedido.
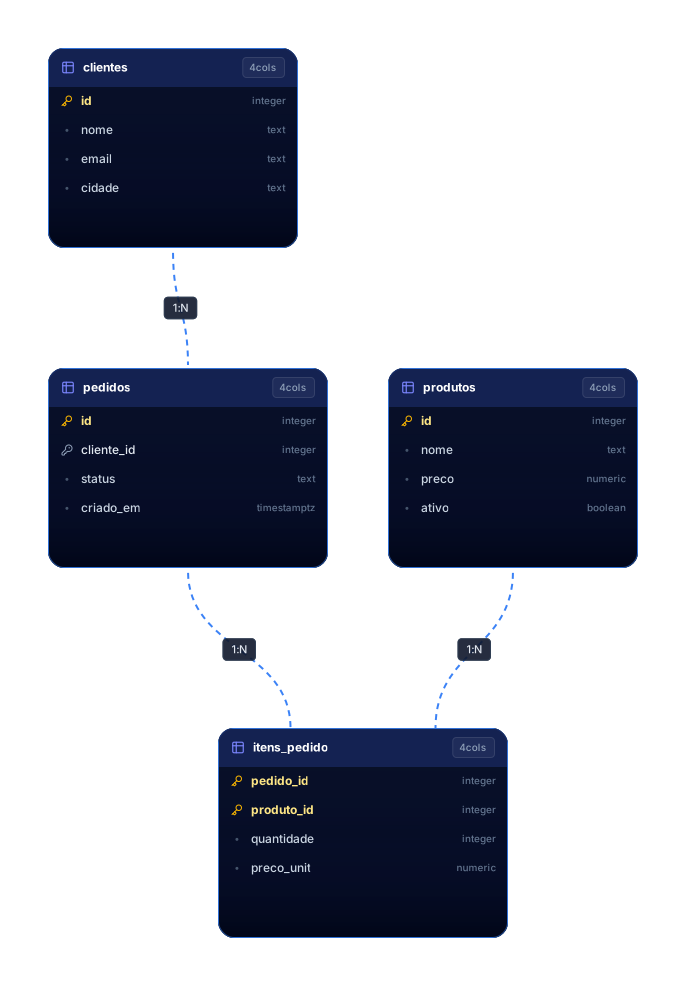
Leia de cima para baixo: pedidos leva a chave de clientes.
3. tipos de dados e NULL
timestamptz guarda um instante: a documentação diz que ele é convertido para UTC e que o fuso original não é mantido. Para dinheiro, use numeric(10,2), e não float, porque a documentação diz que real e double precision são inexatos. O primeiro SELECT mostra o problema.
NULL é ausência de valor. Uma comparação com NULL resulta em desconhecido, por isso NULL = NULL não dá verdadeiro. A documentação manda usar IS NULL.
SELECT 0.1::float8 + 0.2::float8 AS soma_float,
       0.1::float8 + 0.2::float8 = 0.3::float8 AS igual_float,
       0.1::numeric + 0.2::numeric = 0.3::numeric AS igual_numeric;
SELECT NULL = NULL AS igual, NULL IS NULL AS e_nulo, 1 = NULL AS comparacao;
soma_float | igual_float | igual_numeric
---------------------+-------------+---------------
0.30000000000000004 | f | t
(1 row)
igual | e_nulo | comparacao
-------+--------+------------
NULL | t | NULL
(1 row)4. DDL: criando as tabelas
DDL cria a estrutura. PRIMARY KEY exige valor único e não nulo. UNIQUE impede repetição, e NOT NULL proíbe NULL. CHECK testa cada linha; a documentação diz que ele passa com NULL, por isso preco também tem NOT NULL. FOREIGN KEY não cria índice nas colunas que aponta (seção 11). O preco_unit repete o preço de propósito: o item guarda o valor pago.
CREATE TABLE clientes (
    id     integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    nome   text NOT NULL,
    email  text NOT NULL UNIQUE,
    cidade text
);
CREATE TABLE produtos (
    id     integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    nome   text NOT NULL,
    preco  numeric(10,2) NOT NULL CHECK (preco >= 0),
    ativo  boolean NOT NULL DEFAULT true
);
CREATE TABLE pedidos (
    id          integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    cliente_id  integer NOT NULL,
    status      text NOT NULL CHECK (status IN ('aberto', 'pago', 'cancelado')),
    criado_em   timestamptz NOT NULL DEFAULT now(),
    FOREIGN KEY (cliente_id) REFERENCES clientes (id)
);
CREATE TABLE itens_pedido (
    pedido_id   integer NOT NULL,
    produto_id  integer NOT NULL,
    quantidade  integer NOT NULL CHECK (quantidade > 0),
    preco_unit  numeric(10,2) NOT NULL,
    PRIMARY KEY (pedido_id, produto_id),
    FOREIGN KEY (pedido_id) REFERENCES pedidos (id),
    FOREIGN KEY (produto_id) REFERENCES produtos (id)
);
CREATE TABLE
CREATE TABLE
CREATE TABLE
CREATE TABLE5. DML: inserir, alterar e apagar
DML são INSERT, UPDATE e DELETE. Sem WHERE, um UPDATE atinge todas as linhas. O DELETE tem o mesmo risco, e a seção 13 o mostra com saída real. Para testar sem estrago, BEGIN deixa a mudança pendente até o COMMIT, e o ROLLBACK a desfaz. Carla não tem cidade nem pedido, e isso volta nas seções 7 e 8.
INSERT INTO clientes (nome, email, cidade) VALUES
    ('Ana', 'ana@exemplo.com', 'Recife'),
    ('Bruno', 'bruno@exemplo.com', 'Olinda'),
    ('Carla', 'carla@exemplo.com', NULL);
INSERT INTO produtos (nome, preco) VALUES ('Caneca', 25.90), ('Camiseta', 59.90), ('Adesivo', 4.50);
INSERT INTO pedidos (cliente_id, status) VALUES (1, 'pago'), (1, 'aberto'), (2, 'pago'), (2, 'cancelado');
INSERT INTO itens_pedido (pedido_id, produto_id, quantidade, preco_unit) VALUES
    (1, 1, 2, 25.90), (1, 3, 5, 4.50), (2, 2, 1, 59.90),
    (3, 1, 1, 25.90), (3, 2, 2, 59.90), (4, 3, 10, 4.50);
UPDATE pedidos SET status = 'pago' WHERE id = 2;
BEGIN;
UPDATE pedidos SET status = 'cancelado';
SELECT status, COUNT(*) FROM pedidos GROUP BY status ORDER BY status;
ROLLBACK;
SELECT status, COUNT(*) FROM pedidos GROUP BY status ORDER BY status;
INSERT 0 3
INSERT 0 3
INSERT 0 4
INSERT 0 6
UPDATE 1
BEGIN
UPDATE 4
status | count
-----------+-------
cancelado | 4
(1 row)
ROLLBACK
status | count
-----------+-------
cancelado | 1
pago | 3
(2 rows)O SELECT da transação viu os quatro pedidos cancelados. Depois do ROLLBACK, na mesma sessão, o SELECT mostra pago 3. Isso também prova que o UPDATE do pedido 2, feito fora de BEGIN, já estava gravado, porque o ROLLBACK só desfez o bloco.
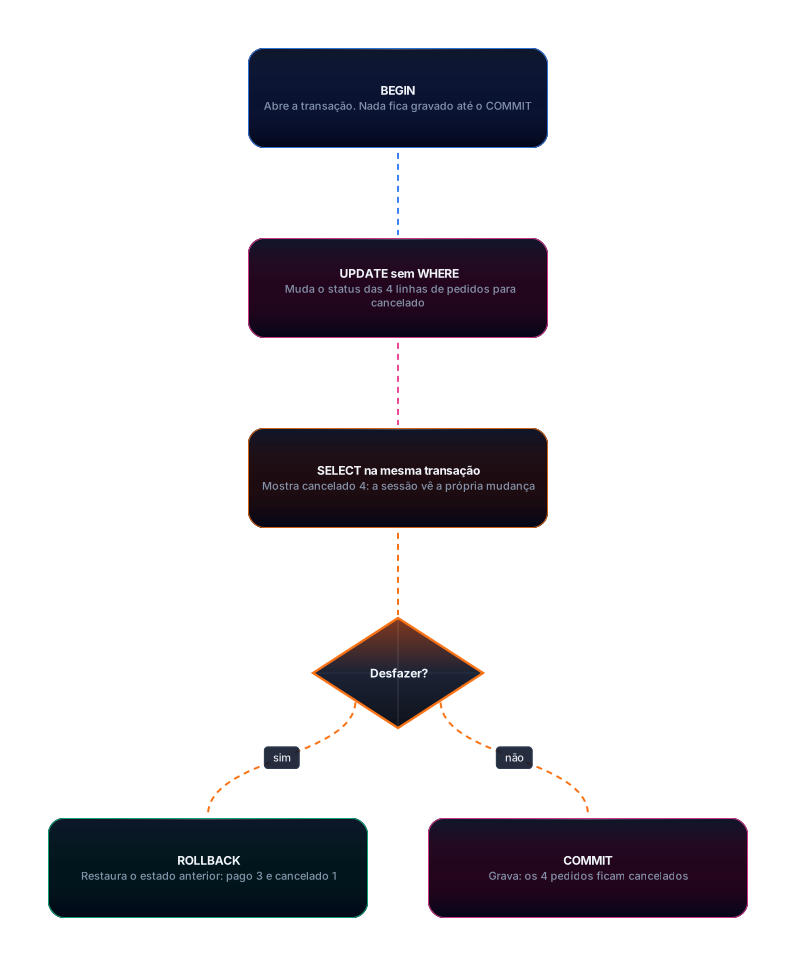
Leia de cima para baixo: o losango é a decisão, com “sim” para o ROLLBACK e “não” para o COMMIT.
6. as recusas do banco
Estes quatro comandos violam uma restrição cada um. Os nomes, como clientes_email_key, são gerados pelo PostgreSQL quando não os damos.
INSERT INTO clientes (nome, email, cidade) VALUES (NULL, 'eva@exemplo.com', 'Recife');
INSERT INTO clientes (nome, email, cidade) VALUES ('Ana Duplicada', 'ana@exemplo.com', 'Recife');
INSERT INTO itens_pedido (pedido_id, produto_id, quantidade, preco_unit) VALUES (1, 2, 0, 59.90);
INSERT INTO pedidos (cliente_id, status) VALUES (99, 'aberto');
ERROR: null value in column "nome" of relation "clientes" violates not-null constraint
DETAIL: Failing row contains (4, null, eva@exemplo.com, Recife).
ERROR: duplicate key value violates unique constraint "clientes_email_key"
DETAIL: Key (email)=(ana@exemplo.com) already exists.
ERROR: new row for relation "itens_pedido" violates check constraint "itens_pedido_quantidade_check"
DETAIL: Failing row contains (1, 2, 0, 59.90).
ERROR: insert or update on table "pedidos" violates foreign key constraint "pedidos_cliente_id_fkey"
DETAIL: Key (cliente_id)=(99) is not present in table "clientes".7. SELECT: filtrar, ordenar e limitar
WHERE escolhe linhas, ORDER BY ordena e LIMIT corta. Sem ORDER BY, a documentação diz que a ordem não é especificada. Nos três últimos comandos, = NULL não retorna linha, IS NULL retorna Carla, e <> deixa Carla de fora.
SELECT id, cliente_id, status
FROM pedidos
WHERE status <> 'cancelado'
ORDER BY id DESC
LIMIT 2;
SELECT nome FROM clientes WHERE cidade = NULL;
SELECT nome FROM clientes WHERE cidade IS NULL;
SELECT nome FROM clientes WHERE cidade <> 'Recife';
id | cliente_id | status
----+------------+--------
3 | 2 | pago
2 | 1 | pago
(2 rows)
nome
------
(0 rows)
nome
-------
Carla
(1 row)
nome
-------
Bruno
(1 row)8. : INNER e LEFT
INNER JOIN devolve só os pares que existem dos dois lados. LEFT JOIN mantém a tabela da esquerda e preenche com NULL o que não tem par. Carla mostra a diferença.
SELECT c.nome, p.id AS pedido
FROM clientes c
INNER JOIN pedidos p ON p.cliente_id = c.id
ORDER BY p.id;
SELECT c.nome, p.id AS pedido
FROM clientes c
LEFT JOIN pedidos p ON p.cliente_id = c.id
ORDER BY c.id, p.id;
nome | pedido
-------+--------
Ana | 1
Ana | 2
Bruno | 3
Bruno | 4
(4 rows)
nome | pedido
-------+--------
Ana | 1
Ana | 2
Bruno | 3
Bruno | 4
Carla | NULL
(5 rows)9. agregação: GROUP BY e HAVING
COUNT, SUM e AVG reduzem linhas a um valor. GROUP BY faz a conta por grupo, HAVING filtra grupos depois dela, e WHERE filtra linhas antes. O COUNT(DISTINCT p.id) é preciso porque a junção repete o pedido por item.
SELECT p.id AS pedido, SUM(i.quantidade * i.preco_unit) AS total
FROM pedidos p
JOIN itens_pedido i ON i.pedido_id = p.id
GROUP BY p.id
ORDER BY p.id;
SELECT c.nome, COUNT(DISTINCT p.id) AS pedidos, SUM(i.quantidade * i.preco_unit) AS faturado
FROM clientes c
JOIN pedidos p ON p.cliente_id = c.id
JOIN itens_pedido i ON i.pedido_id = p.id
WHERE p.status <> 'cancelado'
GROUP BY c.nome
HAVING SUM(i.quantidade * i.preco_unit) > 100
ORDER BY c.nome;
pedido | total
--------+--------
1 | 74.30
2 | 59.90
3 | 145.70
4 | 45.00
(4 rows)
nome | pedidos | faturado
-------+---------+----------
Ana | 2 | 134.20
Bruno | 1 | 145.70
(2 rows)10. modelagem: 1:N, N:N e
Na 1:N, a chave estrangeira fica do lado dos muitos: cada pedido guarda cliente_id, porque uma lista dentro do cliente cresceria sem limite. Na N:N, quantidade e preco_unit pertencem ao item. A normalização separa colunas para que cada fato fique num lugar só: cada coluna depende da chave inteira e de nada além dela. A planilha abaixo repete os dados do cliente.
CREATE TABLE pedidos_planilha (
    pedido_numero  integer,
    cliente_nome   text,
    cliente_cidade text,
    produto_nome   text,
    preco_unit     numeric(10,2),
    quantidade     integer
);
INSERT INTO pedidos_planilha VALUES
    (1, 'Ana', 'Recife', 'Caneca', 25.90, 2),
    (1, 'Ana', 'Recife', 'Adesivo', 4.50, 5),
    (2, 'Ana', 'Recife', 'Camiseta', 59.90, 1);
UPDATE pedidos_planilha SET cliente_cidade = 'Jaboatão' WHERE pedido_numero = 1;
SELECT cliente_nome, cliente_cidade, COUNT(*) AS linhas
FROM pedidos_planilha
GROUP BY cliente_nome, cliente_cidade
ORDER BY cliente_cidade;
DROP TABLE pedidos_planilha;
CREATE TABLE
INSERT 0 3
UPDATE 2
cliente_nome | cliente_cidade | linhas
--------------+----------------+--------
Ana | Jaboatão | 2
Ana | Recife | 1
(2 rows)
DROP TABLEAo atualizar só o pedido 1, Ana ficou com duas cidades, e o banco não sabe que as linhas falam da mesma pessoa. A versão normalizada guarda a cidade uma vez, em clientes.
11. índice
Índice é uma estrutura auxiliar para achar linhas sem ler a tabela inteira. A documentação diz que o planejador só o usa quando o considera mais eficiente, e que cada índice custa trabalho a cada escrita. Comparamos o EXPLAIN com 200 mil linhas. Sem EXPLAIN ANALYZE, o plano não traz tempos de execução.
CREATE TABLE eventos AS SELECT g AS id, md5(g::text) AS payload FROM generate_series(1, 200000) AS g;
ANALYZE eventos;
EXPLAIN SELECT payload FROM eventos WHERE id = 150000;
CREATE INDEX eventos_id_idx ON eventos (id);
ANALYZE eventos;
EXPLAIN SELECT payload FROM eventos WHERE id = 150000;
SELECT 200000
ANALYZE
QUERY PLAN
-----------------------------------------------------------
Seq Scan on eventos (cost=0.00..4228.00 rows=1 width=33)
Filter: (id = 150000)
(2 rows)
CREATE INDEX
ANALYZE
QUERY PLAN
-------------------------------------------------------------------------------
Index Scan using eventos_id_idx on eventos (cost=0.42..8.44 rows=1 width=33)
Index Cond: (id = 150000)
(2 rows)Antes, o plano é um Seq Scan, com custo estimado de 4228. Depois, um Index Scan por eventos_id_idx, com custo de 8.44. São estimativas, que variam com a versão.
Criar a chave estrangeira não cria índice. A seção 4 já avisou isso, e a consulta abaixo mostra os índices das tabelas de pedidos:
SELECT tablename, indexname, indexdef
FROM pg_indexes
WHERE schemaname = 'public' AND tablename IN ('pedidos', 'itens_pedido')
ORDER BY tablename, indexname;
tablename | indexname | indexdef
--------------+-------------------+--------------------------------------------------------------------------------------------------
itens_pedido | itens_pedido_pkey | CREATE UNIQUE INDEX itens_pedido_pkey ON public.itens_pedido USING btree (pedido_id, produto_id)
pedidos | pedidos_pkey | CREATE UNIQUE INDEX pedidos_pkey ON public.pedidos USING btree (id)
(2 rows)Só há índices das chaves primárias. Sem índice em pedidos.cliente_id, buscar os pedidos de um cliente obriga a ler a tabela inteira. Em itens_pedido, a chave primária é (pedido_id, produto_id), e um índice composto ajuda sobretudo buscas que começam pela primeira coluna. Por isso pedido_id já está indexado, enquanto produto_id, que também é chave estrangeira, não tem índice.
12. transação em um parágrafo
BEGIN abre uma transação, COMMIT grava e ROLLBACK desfaz. É a atomicidade da seção 5. Com JPA, a anotação @Transactional faz esse papel por você, como explica JPA básico: entidades, repositórios e @Transactional.
Pergunta de entrevistaQuando um índice ajuda e quando atrapalha?
Um índice acelera busca e ordenação pelas colunas indexadas, mas ocupa espaço e deixa INSERT, UPDATE e DELETE mais lentos, porque o índice também precisa mudar. Ajuda em filtros seletivos e em junções pelas chaves estrangeiras. Não ajuda quando a consulta lê boa parte da tabela, ou quando a coluna tem poucos valores distintos. Eu confirmo com EXPLAIN, e não crio índice por palpite.
13. erros comuns e boas práticas
Quem nunca rodou um DELETE sem WHERE ainda não trabalhou com dados de verdade. Envolva o comando num BEGIN e confira a contagem antes do COMMIT. Também erram quem compara com =, guarda dinheiro em float, usa COUNT(*) num LEFT JOIN ou depende da ordem sem ORDER BY.
O bloco abaixo apaga os itens do pedido 4 dentro de uma transação e desfaz tudo com ROLLBACK.
BEGIN;
DELETE FROM itens_pedido WHERE pedido_id = 4;
ROLLBACK;
BEGIN
DELETE 1
ROLLBACKO DELETE 1 é a contagem que você confere antes do COMMIT. Se a contagem fosse igual ao total de linhas da tabela, você saberia que faltou o WHERE antes de gravar. Como o ROLLBACK veio em seguida, nada foi apagado de fato.
Observação minha, não medida: chave estrangeira sem índice tende a forçar a varredura da tabela filha. Para um esquema que evolui, veja Migrations com Liquibase.
14. exercícios
Exercício 1 (guiado). Liste cada cliente com a quantidade de pedidos, incluindo quem não tem nenhum. Escreva antes o resultado esperado para Carla.
SELECT c.nome, COUNT(p.id) AS pedidos
FROM clientes c
LEFT JOIN pedidos p ON p.cliente_id = c.id
GROUP BY c.nome
ORDER BY c.nome;
nome | pedidos
-------+---------
Ana | 2
Bruno | 2
Carla | 0
(3 rows)Ana e Bruno têm 2 pedidos cada, e Carla tem 0. Com COUNT(*) no lugar de COUNT(p.id), Carla apareceria com 1 (seção 13).
Exercício 2. Calcule o faturamento por produto, sem pedidos cancelados, mostrando só os produtos acima de 50, do maior para o menor.
SELECT pr.nome, SUM(i.quantidade * i.preco_unit) AS faturado
FROM produtos pr
JOIN itens_pedido i ON i.produto_id = pr.id
JOIN pedidos p ON p.id = i.pedido_id
WHERE p.status <> 'cancelado'
GROUP BY pr.nome
HAVING SUM(i.quantidade * i.preco_unit) > 50
ORDER BY faturado DESC;
nome | faturado
----------+----------
Camiseta | 179.70
Caneca | 77.70
(2 rows)Camiseta fatura 179.70 e Caneca fatura 77.70. O adesivo, com 22.50, fica de fora.
15. glossário
- tabela: conjunto de linhas de um mesmo tipo de coisa.
- chave primária: conjunto de colunas que identifica cada linha.
- chave estrangeira: coluna que aponta para a chave primária de outra tabela.
- NULL: ausência de valor, que não é igual a nada.
- JOIN: combinação de linhas de duas tabelas pela condição do ON.
- tabela de associação: tabela intermediária de uma relação N:N.
- normalização: separação de colunas para que cada fato fique num lugar só.
- índice: estrutura que localiza linhas sem ler a tabela inteira.
- transação: grupo de comandos que acontece por completo ou não acontece.
o que não foi confirmado ou medido
- Testado só no PostgreSQL 18.6, em arm64, com Docker Desktop no macOS. A 17 e a 19 não foram testadas.
- As saídas vieram de um arquivo rodado com
psql -fnuma sessão só, com-Xe-P null=NULL. Nas linhas ERROR, o psql põe antes o prefixopsql:arquivo:linha, que foi tirado dos blocos. O modo interativo não foi rodado. - Os custos do EXPLAIN são estimativas. Não medi tempo.
- ON DELETE e concorrência entre sessões não foram testados.
Fontes
Consultadas em 04/11/2026.
- PostgreSQL 18, Numeric Types: https://www.postgresql.org/docs/18/datatype-numeric.html
- PostgreSQL 18, Date/Time Types: https://www.postgresql.org/docs/18/datatype-datetime.html
- PostgreSQL 18, Constraints: https://www.postgresql.org/docs/18/ddl-constraints.html
- PostgreSQL 18, Comparison Functions and Operators: https://www.postgresql.org/docs/18/functions-comparison.html
- PostgreSQL 18, Sorting Rows: https://www.postgresql.org/docs/18/queries-order.html
- PostgreSQL 18, Indexes: https://www.postgresql.org/docs/18/indexes-intro.html
- PostgreSQL, página inicial: https://www.postgresql.org/