Hardware e sistemas operacionais · parte 21 de 27
Endereçamento, alinhamento e endianness: como a CPU acha um byte e por que a ordem importa
Como a CPU encontra um byte pelo endereço, por que um inteiro desalinhado pode custar outra busca de linha de cache e o que muda entre little e big-endian.
intermediárioPublicada em · 35 min de leitura
Imagine uma rua comprida com uma casa por byte, numeradas a partir do zero. O número da casa é o endereço, e o morador de cada casa é o valor de um byte, de 0 a 255. Um inteiro de 32 bits ocupa quatro casas vizinhas. Até aqui a analogia funciona. A dúvida aparece quando você pergunta de que lado começa o número: a casa de menor número guarda o algarismo mais significativo ou o menos significativo? Essa escolha tem nome, endianness, e muda de processador para processador e de protocolo para protocolo.
Esta aula trata de três coisas que parecem pequenas e aparecem em todo código que lê ou escreve dados binários. A primeira é como a CPU encontra um byte pelo endereço. A segunda é por que um dado que começa no lugar errado custa mais, e em quais arquiteturas isso vira erro. A terceira é por que dois programas que concordam em tudo discordam do número 300 quando trocam um arquivo ou um pacote de rede.
Os pré-requisitos são a aula Bits e binário, que apresenta a base 2 e o hexadecimal usados aqui, e a aula Ciclo de instrução e unidade de controle, que mostra a CPU buscando e executando instruções que leem a memória. Uma observação sobre os números: as contas de linha de cache usam a CPU de referência da trilha, um Zen 4 com linha de 64 bytes. As medições foram feitas em outra máquina, um Apple M1 Max com linha de 128 bytes, e os dois conjuntos de números não se misturam.
Mapa da aula
| Seção | Pergunta que responde |
|---|---|
| 1. A memória como vetor de bytes | O que a CPU vê quando lê a memória? |
| 2. Palavra, barramento e endereço de byte | Quantos bytes entram numa transferência, e o que é uma palavra? |
| 3. Alinhamento natural e padding | Quando um endereço está alinhado, e por que o compilador deixa espaços vazios? |
| 4. O custo do acesso desalinhado | O que o hardware faz com um inteiro que cruza a fronteira de uma linha, e quanto isso custa? |
| 5. Endianness: little-endian e big-endian | Em que ordem os bytes de um inteiro ficam na memória? |
| 6. Onde a ordem aparece na prática | Quais protocolos, arquivos e processadores usam cada ordem? |
| 7. Erros comuns e boas práticas | Onde os programas costumam errar com endereços e ordem de bytes? |
| 8. Exercícios | Questões com resposta de referência |
| 9. Glossário | Termos desta aula |
| O que não foi confirmado | Quais afirmações ficaram sem fonte primária ou sem medição? |
| Fontes | De onde vêm os fatos, e quando foram consultados? |
1. A memória como vetor de bytes
Para a CPU, a memória principal é um vetor enorme de bytes. Um byte tem oito bits, e cada um deles tem um endereço, que é o número de ordem dentro do vetor, contado a partir de zero. Quando uma instrução pede um dado, ela não diz “me dê a variável contador”. Ela diz algo como “leia os quatro bytes que começam no endereço 0x1000”. O nome da variável existe só no código-fonte. O compilador transforma o nome em endereço, ou em deslocamento a partir de um registrador, antes de o programa rodar.
A figura abaixo mostra dezesseis bytes seguidos com os códigos ASCII da frase BYTES-DA-MEMORIA. Cada caixa é um byte, com a posição em cima e o valor em hexadecimal embaixo. O byte destacado está na posição 9 e vale 0x4D, a letra M.
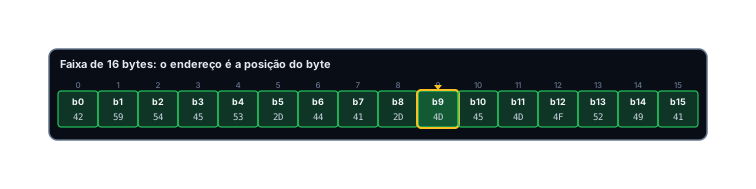
Leia a figura da esquerda para a direita. Os números em cima são os endereços relativos ao início da faixa, e o valor embaixo é o conteúdo daquele byte. O byte não tem nada de especial. Quem dá sentido a ele é o programa que o lê, e por isso o mesmo endereço pode guardar uma letra, um pedaço de inteiro ou uma instrução.
Como o endereço é a posição dentro de um vetor, a aritmética é a mesma de um array em C. O quarto byte a partir de 0x1000 está em 0x1000 + 3, ou seja, em 0x1003. Os endereços contam bytes, e não palavras. Essa escolha tem consequências, e a seção 2 mostra quais.
2. Palavra, barramento e endereço de byte
Antes de falar de alinhamento, vale fixar dois termos que costumam confundir. O primeiro é palavra. Ela não tem um tamanho universal. O manual da Intel usa palavra para 16 bits, dupla palavra para 32 bits e quádrupla palavra para 64 bits, e outros manuais dão outro sentido à mesma palavra. Nesta aula, “palavra” significa só a largura natural dos registradores de uso geral. Quando o texto quiser 32 bits, vai dizer 32 bits.
O segundo termo é barramento. Entre a CPU e a RAM há conjuntos de fios em paralelo. Um conjunto leva o endereço da CPU para a memória, e outro leva os bytes de volta. A quantidade de fios define quanto pode ser transferido de uma vez. Com n fios de endereço, o hardware distingue 2 elevado a n endereços. Com 32 fios, são 2 elevado a 32 bytes, ou 4 GiB. Um endereço de 64 bits, como o dos registradores de uso geral de processadores de 64 bits, oferece muito mais espaço do que qualquer placa instala. A largura efetiva que o hardware usa costuma ser menor, mas o valor exato depende da arquitetura e da configuração, e não foi conferido nesta aula.
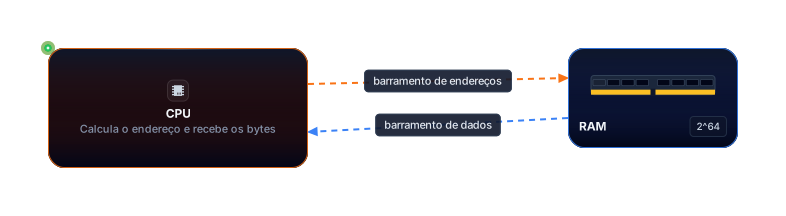
A figura mostra os dois sentidos. O endereço sai da CPU, e os bytes voltam da RAM. A largura do barramento de dados não é a mesma coisa que a largura do registrador: um registrador de 64 bits pode receber uma transferência menor ou maior, conforme a instrução. O que a instrução pede é a quantidade de bytes que ela quer ler, e o hardware se encarrega de buscar as linhas que contêm esses bytes.
Os processadores de uso geral atuais enderecam bytes. O manual da Intel mostra isso na figura 4-2, em que um byte, uma palavra e uma dupla palavra aparecem com o endereço do primeiro byte. A especificação RISC-V diz que o espaço de endereços de cada hart é formado por bytes. Arquiteturas antigas ou especializadas podem contar palavras inteiras, e nesses casos o endereço 1 significa a segunda palavra, e não o segundo byte. Quando esta aula fala em endereço, é sempre endereço de byte.
3. Alinhamento natural e padding
Um acesso de k bytes está alinhado quando o endereço é múltiplo de k. O manual da Intel escreve a regra com outras palavras, na seção 4.1.1: palavras começam em endereços pares, duplas palavras em endereços divisíveis por 4 e quádruplas palavras em endereços divisíveis por 8. Um inteiro de 4 bytes em 0x1004 está alinhado, porque 0x1004 é divisível por 4. O mesmo inteiro em 0x1006 não está. Ele é par, mas não é múltiplo de 4.
O alinhamento importa para quem escreve struct, porque o compilador o garante inserindo espaços vazios. Esses espaços se chamam padding. A ideia é simples: se um campo de 8 bytes precisa começar num múltiplo de 8, o compilador deixa livres os bytes que vêm antes dele. A figura mostra o efeito com os mesmos três campos, um bool, um int64 e outro bool, em duas ordens.
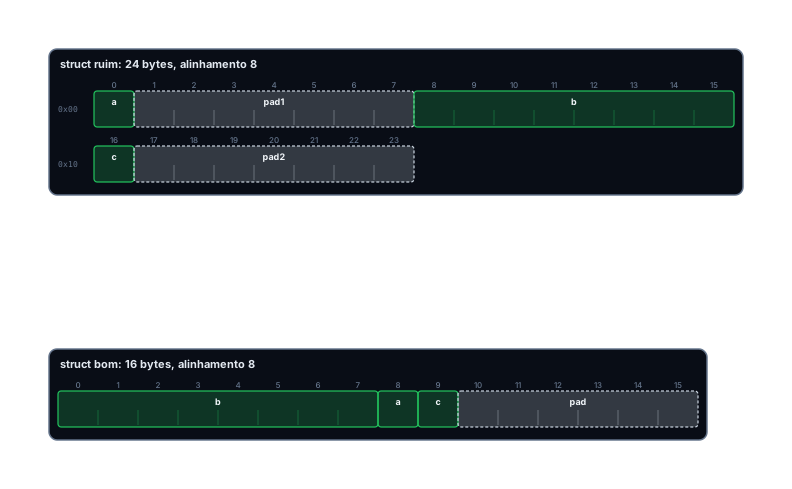
Na struct da primeira linha, o bool a ocupa o byte 0, e o int64 b precisa começar num múltiplo de 8. Por isso sete bytes ficam vazios antes dele. O bool c cai no byte 16, e mais sete bytes fecham o tamanho em 24, que é múltiplo de 8. Na segunda linha, o int64 vem primeiro, e os dois bools se encaixam nos bytes 8 e 9. Sobram seis bytes de padding, e o tamanho cai para 16. O padding é um enchimento, como o isopor que o fabricante põe na caixa para o produto não balançar. Ele custa memória e não carrega dado útil, e num array de milhões de structs a diferença de oito bytes por objeto aparece no total.
As saídas abaixo vêm do programa Go da seção 5, rodado no alvo desta aula. Elas confirmam a conta da figura: a ordem ruim tem tamanho 24, e a ordem por tamanho tem tamanho 16. A especificação da linguagem garante o tamanho dos tipos numéricos e a regra de alinhamento de uma struct, que é o maior alinhamento entre os seus campos. O offset exato de cada campo, porém, depende da arquitetura, e por isso o programa o imprime no alvo.
4. O custo do acesso desalinhado
4.1 O que o hardware faz
Um acesso desalinhado nem sempre é um erro. Em x86-64 ele funciona, mas pode custar mais, e outras arquiteturas tratam o caso de outro jeito, como a tabela desta seção mostra. O manual da Intel explica o mecanismo na seção 4.1.1, e a citação é direta: “A word or doubleword operand that crosses a 4-byte boundary or a quadword operand that crosses an 8-byte boundary is considered unaligned and requires two separate memory bus cycles for access.” Ou seja, um operando que atravessa a fronteira de 4 bytes precisa de dois ciclos de barramento, e um operando alinhado precisa de um só.
Isso se conecta à hierarquia de memória. Quando o desalinhado cruza a fronteira de uma linha de cache, a CPU precisa obter as duas linhas. Se as duas estiverem no L1, a diferença costuma ser pequena, e a medição da seção 4.2 mostra isso nesta máquina. Se alguma não estiver, a parte que falta sai para a RAM, como na aula Hierarquia de memória e localidade. A figura abaixo mostra as duas situações sobre duas linhas de 64 bytes, a linha que a referência da trilha usa.
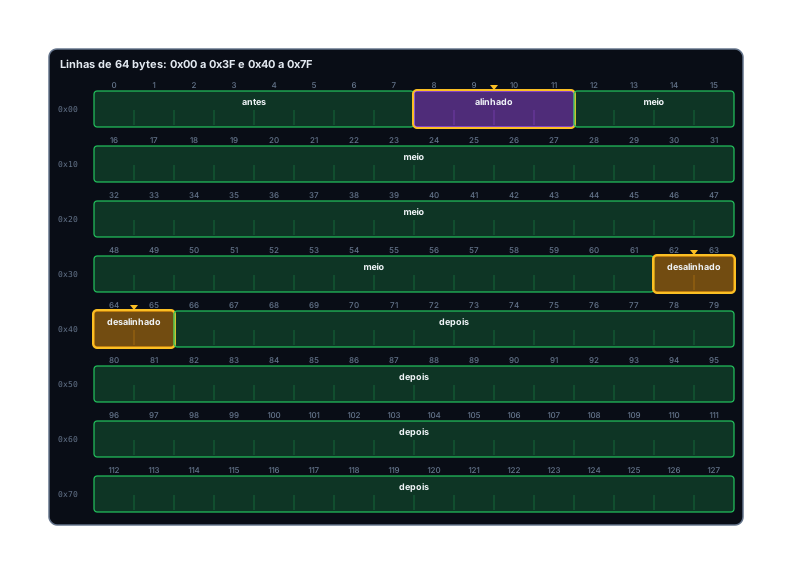
Na figura, o inteiro alinhado começa em 0x08 e cabe inteiro dentro da primeira linha. Um único acesso resolve. O inteiro desalinhado começa em 0x3E. Os bytes 0x3E e 0x3F estão na primeira linha, e os bytes 0x40 e 0x41 estão na segunda, que começa onde o cabeçalho de linha marca 0x40. O hardware precisa tratar as duas linhas e juntar os quatro bytes antes de entregá-los ao registrador. A figura mostra o caminho, e não o custo em nanossegundos, que é medido na seção 4.2.
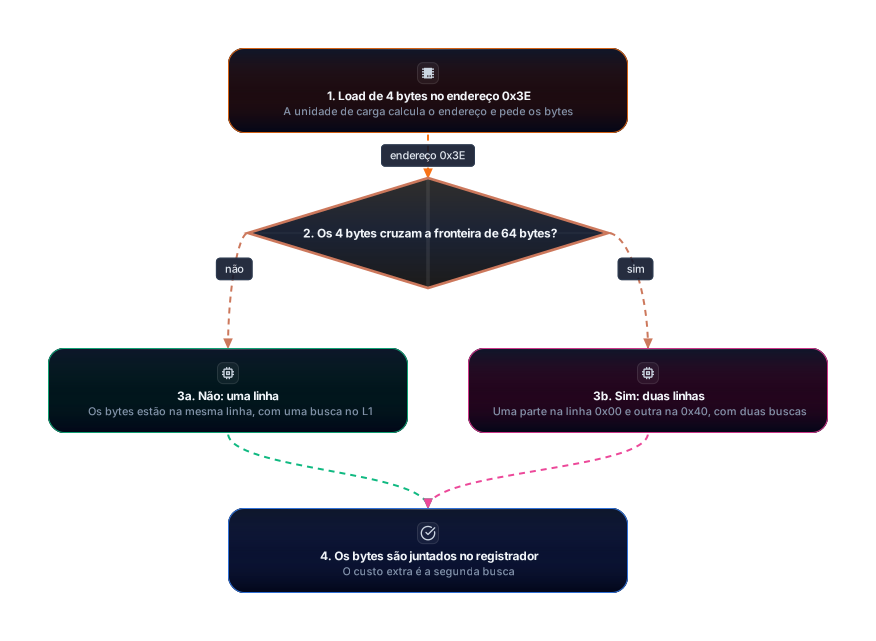
O fluxo mostra a decisão que o hardware toma em cada leitura. Ele começa pelo endereço, pergunta se os quatro bytes atravessam a fronteira e segue por um dos dois ramos. No caso em que não há cruzamento, uma busca no L1 basta. No caso do cruzamento, são duas buscas, e a segunda é o custo extra. Nas duas situações os bytes acabam juntos no registrador. A diferença entre os ramos é uma busca a mais, e o cálculo do endereço é igual nos dois.
O comportamento muda de arquitetura para arquitetura, e a tabela resume o que cada uma diz, com o que foi confirmado na documentação lida.
| Arquitetura | O que a documentação lida diz | Situação |
|---|---|---|
| x86-64 (Intel) | Operandos desalinhados são permitidos. Um operando que cruza a fronteira precisa de dois ciclos de barramento. Algumas instruções SSE com operandos de 16 bytes geram falha de proteção geral (#GP) quando o operando não está alinhado. | Confirmado no SDM, volume 1, seção 4.1.1 |
| RISC-V | A extensão Zicclsm exige suporte a acessos desalinhados à memória principal, mas diz que eles podem ser muito lentos. A especificação deixa aberta a possibilidade de a base não tratar desalinhados, e de o ambiente de execução tratar os desalinhados de ponto flutuante como exceção. | Confirmado na especificação não privilegiada, com a ressalva de que cada implementação escolhe |
| AArch64 (Arm) | Fontes secundárias afirmam que acessos desalinhados a memória Normal podem ser permitidos e que memória Device falha, mas o manual primário não foi lido. | Não confirmado, ver a seção final |
Para AArch64 a tabela deixa a regra em aberto. Não consegui ler o manual da Arm nesta consulta. As fontes que encontrei são mensagens de listas, um patch do QEMU e uma discussão de bug do GCC que cita o manual, mas não o texto exato da regra. Para instruções exclusivas, como as que implementam travas, a regra pode ser outra, e também não foi confirmada aqui. Por isso a aula só afirma o que foi medido na máquina, na seção 4.2.
4.2 Medição neste Mac
Para ver o efeito, escrevi um programa em C que lê inteiros de 4 bytes em quatro offsets: 0, que está alinhado; 1, que é desalinhado mas não cruza linha; 61, que cruza a fronteira de 64 bytes; e 125, que cruza a fronteira de 128 bytes, a linha desta máquina. O programa tem dois modos. No modo independente, cada leitura não depende da anterior, e o processador pode sobrepor várias delas, então o número é de vazão. No modo encadeado, o endereço da próxima leitura é o valor que acabou de ser lido, numa ordem aleatória fixa, então nenhuma leitura começa antes da anterior terminar, e o número é de latência.
O conjunto de 64 nós espaçados de 256 bytes ocupa 16 KiB e cabe no L1 de dados. Para ver o efeito fora do cache, usei o mesmo programa com 1 Mi nós, um conjunto de 256 MiB. A leitura é feita com memcpy de 4 bytes. Em C, um ponteiro uint32_t desalinhado é comportamento indefinido, e o memcpy é a forma portátil de dizer “leia 4 bytes deste endereço”. Numa versão anterior do mesmo laço, conferi no assembly que o compilador transformou esse memcpy numa instrução de carga de 32 bits, sem leitura byte a byte. A versão final mudou só a leitura de parâmetros e a impressão, e o laço de leitura é o mesmo; o assembly dela não foi conferido de novo.
A máquina é um Apple M1 Max, com 10 núcleos, 32 GB de memória, macOS 27.0.1 (sw_vers), linha de cache de 128 bytes (sysctl hw.cachelinesize = 128) e página de 16 KiB (getconf PAGESIZE). O compilador foi o Apple clang 21.0.0. As execuções foram feitas em 2 de novembro de 2026, entre 22:11 e 22:13 (horário de Brasília), com carga média entre 12 e 30 durante o teste, porque a máquina rodava outros processos. Essa carga é alta, e ela explica parte da variação entre execuções. O código completo está abaixo.
/*
 * alinhamento.c: custo de ler um inteiro de 32 bits em offsets alinhados
 * e desalinhados, dentro e através de linhas de cache.
 *
 *   clang -O2 -Wall -Wextra -o alinhamento alinhamento.c
 *   ./alinhamento
 *
 * Dois modos, sobre o mesmo conjunto de N nós espaçados de STRIDE bytes
 * (N * STRIDE = 16 KiB, que cabe no L1D da máquina):
 *
 *   independente: cada leitura usa só o índice do laço. O processador pode
 *                 sobrepor várias leituras, então o número é de vazão.
 *   encadeado:    cada leitura usa como endereço o valor da anterior, em
 *                 uma ordem de visita aleatória fixa (permutação de Sattolo).
 *                 Nenhuma leitura começa antes da anterior terminar, então o
 *                 número é de latência.
 *
 * A leitura é um memcpy de 4 bytes. Em C, ponteiro uint32_t desalinhado é
 * comportamento indefinido, e o memcpy é a forma portátil de pedir "4 bytes
 * deste endereço". Os tempos incluem o laço, igual em todos os offsets.
 */
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>

#define N_PADRAO 64
static size_t N = N_PADRAO;
#define STRIDE 256
#define PASSAGENS 1000000
#define PASSOS_ENCADEADOS 4000000
#define REPETICOES 5

static volatile uint64_t sumidouro;

static double agora(void) {
    struct timespec ts;
    clock_gettime(CLOCK_MONOTONIC, &ts);
    return (double)ts.tv_sec + (double)ts.tv_nsec * 1e-9;
}

static uint32_t ler32(const uint8_t *p) {
    uint32_t v;
    memcpy(&v, p, sizeof v);
    return v;
}

static void gravar32(uint8_t *p, uint32_t v) {
    memcpy(p, &v, sizeof v);
}

/* Vazão: leituras independentes, N por passagem. */
static double medir_independente(const uint8_t *base, size_t off) {
    uint64_t soma = 0;
    double t0 = agora();
    for (size_t p = 0; p < PASSAGENS; p++) {
        for (size_t i = 0; i < N; i++)
            soma += ler32(base + i * STRIDE + off);
        /* Barreira: o compilador precisa reler a memória em cada passagem. */
        __asm__ volatile("" ::: "memory");
    }
    double t1 = agora();
    sumidouro = soma;
    return (t1 - t0) * 1e9 / ((double)PASSAGENS * N);
}

/* Latência: cada leitura depende da anterior. */
static double medir_encadeado(const uint8_t *base, size_t off) {
    uint32_t idx = 0;
    double t0 = agora();
    for (size_t s = 0; s < PASSOS_ENCADEADOS; s++)
        idx = ler32(base + (size_t)idx * STRIDE + off);
    double t1 = agora();
    sumidouro = idx;
    return (t1 - t0) * 1e9 / (double)PASSOS_ENCADEADOS;
}

/* Permutação de Sattolo: um único ciclo que passa por todos os nós. */
static void montar_ciclo(uint8_t *base, size_t off) {
    uint32_t *perm = malloc(N * sizeof *perm);
    for (uint32_t i = 0; i < N; i++) perm[i] = i;
    uint64_t estado = 0x9E3779B97F4A7C15ull; /* semente fixa: a visita é a mesma em todas as execuções */
    for (uint32_t i = N - 1; i > 0; i--) {
        estado ^= estado << 13; estado ^= estado >> 7; estado ^= estado << 17;
        uint32_t j = (uint32_t)(estado % i);
        uint32_t t = perm[i]; perm[i] = perm[j]; perm[j] = t;
    }
    /* perm[i] é o próximo nó depois de i, com um único ciclo. */
    for (uint32_t i = 0; i < N; i++)
        gravar32(base + (size_t)i * STRIDE + off, perm[i]);
    free(perm);
}

static int cmp(const void *a, const void *b) {
    double x = *(const double *)a, y = *(const double *)b;
    return (x > y) - (x < y);
}

static int linhas(size_t off, size_t tam) {
    return (int)((off + 3) / tam - off / tam) + 1;
}

int main(int argc, char **argv) {
    if (argc > 1) N = (size_t)strtoull(argv[1], NULL, 10);
    size_t tamanho = ((size_t)N * STRIDE + 256 + 4095) / 4096 * 4096;
    uint8_t *base = aligned_alloc(4096, tamanho);
    if (!base) return 1;

    /* 0 é alinhado. 1 é desalinhado sem cruzar linha. 61 cruza a fronteira
     * de 64 bytes. 125 cruza a de 128 bytes (e também a de 64). */
    size_t offsets[] = {0, 1, 61, 125};
    int n = (int)(sizeof offsets / sizeof offsets[0]);

    printf("N=%zu STRIDE=%d PASSAGENS=%d PASSOS_ENCADEADOS=%d REPETICOES=%d\n",
           N, STRIDE, PASSAGENS, PASSOS_ENCADEADOS, REPETICOES);
    printf("conjunto=%zu KiB\n", N * STRIDE / 1024);

    int modos = (argc > 2) ? 1 : 2; /* com 2º argumento: só encadeado */
    for (int modo = modos == 1 ? 1 : 0; modo < 2; modo++) {
        printf("\nmodo: %s (ns por leitura; mínimo, mediana e máximo de %d execuções)\n",
               modo == 0 ? "independente (vazão)" : "encadeado (latência)", REPETICOES);
        printf("%-8s %-14s %-10s %-10s %-10s %-10s %-10s\n",
               "offset", "tipo", "linhas64", "linhas128", "min", "mediana", "max");
        for (int k = 0; k < n; k++) {
            size_t off = offsets[k];
            double r[REPETICOES];
            if (modo == 0) {
                memset(base, 0xA5, tamanho);
                for (int j = 0; j < REPETICOES; j++) r[j] = medir_independente(base, off);
            } else {
                montar_ciclo(base, off);
                for (int j = 0; j < REPETICOES; j++) r[j] = medir_encadeado(base, off);
            }
            qsort(r, REPETICOES, sizeof r[0], cmp);
            const char *tipo = (off % 4 == 0) ? "alinhado" : "desalinhado";
            printf("%-8zu %-14s %-10d %-10d %-10.3f %-10.3f %-10.3f\n",
                   off, tipo, linhas(off, 64), linhas(off, 128),
                   r[0], r[REPETICOES / 2], r[REPETICOES - 1]);
        }
    }
    free(base);
    return 0;
}
Compilei sem avisos e rodei assim: ./alinhamento para o conjunto de 16 KiB, e ./alinhamento 1048576 x para o conjunto de 256 MiB, com o segundo argumento limitando a execução ao modo encadeado. Repeti cada comando três vezes. A saída abaixo é a primeira execução do conjunto de 16 KiB, e a primeira do conjunto de 256 MiB.
N=64 STRIDE=256 PASSAGENS=1000000 PASSOS_ENCADEADOS=4000000 REPETICOES=5
conjunto=16 KiB

modo: independente (vazão) (ns por leitura; mínimo, mediana e máximo de 5 execuções)
offset   tipo           linhas64   linhas128  min        mediana    max
0        alinhado       1          1          0.345      0.380      0.421
1        desalinhado    1          1          0.357      0.375      0.381
61       desalinhado    2          1          0.360      0.380      0.416
125      desalinhado    2          2          0.360      0.375      0.392

modo: encadeado (latência) (ns por leitura; mínimo, mediana e máximo de 5 execuções)
offset   tipo           linhas64   linhas128  min        mediana    max
0        alinhado       1          1          2.075      2.127      2.663
1        desalinhado    1          1          2.100      2.513      3.409
61       desalinhado    2          1          2.084      2.277      2.681
125      desalinhado    2          2          2.151      2.228      2.270
N=1048576 STRIDE=256 PASSAGENS=1000000 PASSOS_ENCADEADOS=4000000 REPETICOES=5
conjunto=262144 KiB
modo: encadeado (latência) (ns por leitura; mínimo, mediana e máximo de 5 execuções)
offset tipo linhas64 linhas128 min mediana max
0 alinhado 1 1 145.984 152.953 190.137
1 desalinhado 1 1 170.151 180.567 227.868
61 desalinhado 2 1 180.550 185.538 197.498
125 desalinhado 2 2 289.563 371.348 477.313 A tabela a seguir reúne a mediana de cada uma das três execuções, em ns por leitura. Ela mostra a faixa dos valores, que é o que importa para comparar.
| Offset | Tipo | Conjunto de 16 KiB, encadeado (mediana de 3 execuções) | Conjunto de 256 MiB, encadeado (mediana de 3 execuções) |
|---|---|---|---|
| 0 | alinhado | 2,1 a 2,8 ns | 148 a 154 ns |
| 1 | desalinhado, sem cruzar | 2,1 a 3,7 ns | 147 a 181 ns |
| 61 | cruza a fronteira de 64 | 2,1 a 2,5 ns | 161 a 186 ns |
| 125 | cruza a fronteira de 128 | 2,2 a 2,3 ns | 250 a 371 ns |
Dentro do cache, a diferença entre alinhado e desalinhado fica abaixo da variação entre execuções. Fora do cache, a leitura que cruza a fronteira de 128 bytes é a que se destaca, com mediana perto de 273 ns contra 153 ns do alinhado. A figura reúne as medianas centrais das três execuções.
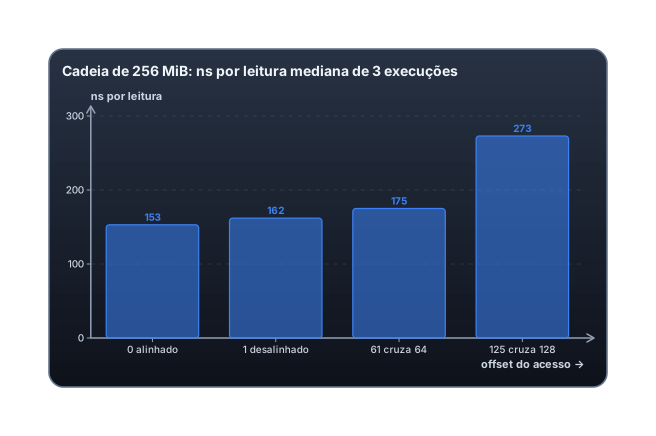
Leia as barras da esquerda para a direita. A primeira é o acesso alinhado, e as três seguintes são os desalinhados, cada uma com um offset diferente. A segunda barra fica tão perto da primeira que está dentro do ruído das execuções. A terceira, que cruza a fronteira de 64 bytes, é um pouco mais alta. A quarta, que cruza a fronteira de 128 bytes, é quase o dobro da primeira. Essa é a linha desta máquina, e a leitura que a atravessa precisa de duas linhas, cada uma buscada na memória principal.
A medição confirma o que a Intel descreve, mas com ressalvas. Fora do cache, o acesso que cruza a linha custa mais, como esperado para duas buscas. O aumento para o offset 61 não tem explicação fechada: ele cruza a fronteira de 64 bytes, que não é a linha desta máquina, e o programa não mediu contadores de hardware para dizer o que acontece. Os números valem para um Apple M1 Max com carga alta e para este programa. Eles não são latências da referência Zen 4, e não servem para dizer quanto custa um desalinhado em outra máquina.
5. Endianness: little-endian e big-endian
Quando um valor ocupa mais de um byte, falta ainda uma decisão: qual byte vai para o menor endereço. Na convenção little-endian, o byte menos significativo fica no menor endereço. Na convenção big-endian, é o mais significativo que fica lá. O nome vem de um livro. Em As viagens de Gulliver, de Jonathan Swift, dois povos brigam sobre por qual ponta quebrar um ovo cozido. Em 1980, Danny Cohen usou os nomes em uma nota técnica, o IEN 137, para descrever a disputa entre os dois jeitos de guardar bytes, e o título, “On Holy Wars and a Plea for Peace”, já avisava que a briga era mais de tradição do que de engenharia.
Tomemos o inteiro 0x12345678 guardado no endereço 0x1000. Ele tem quatro bytes: 0x12, 0x34, 0x56 e 0x78, de mais significativo a menos significativo. A figura mostra as duas formas de guardá-lo.
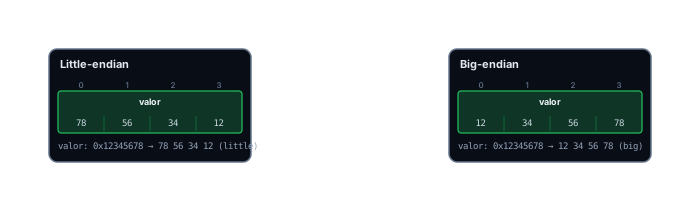
Os dois quadros têm os mesmos quatro bytes, em ordens opostas. No little-endian, o 0x78 está no endereço 0x1000 e o 0x12 no 0x1003. No big-endian, é o contrário. Os números dos bytes são os mesmos. O que muda é a posição de cada um. A ordem trata dos bytes dentro de um valor, e não dos bits dentro de um byte, que a aula não trata.
O manual da Intel descreve a convenção da família x86 na seção 1.3.1: “Intel 64 and IA-32 processors are ‘little endian’ machines; this means the bytes of a word are numbered starting from the least significant byte.” Os processadores da família x86-64 guardam os inteiros em little-endian. A especificação RISC-V também define o sistema de memória básico como little-endian. Na seção 6, a aula trata das outras ordens e de quem as usa.
O programa abaixo mostra as duas ordens, a ordem do host e o padding, e lê de volta um inteiro desalinhado. Ele roda em Go 1.27.2 e não lê os dados com ponteiro desalinhado, porque a documentação do pacote unsafe não lista esse padrão como válido. A leitura desalinhada passa por encoding/binary, que aceita qualquer endereço.
// enderecos.go: ordem de bytes, padding e acesso desalinhado em Go.
//
// Execute com: go run .
// Não há entrada. A saída mostra a ordem dos bytes do host, a mesma
// palavra de 32 bits escrita em little-endian e big-endian, o layout
// de duas structs com os mesmos campos e a leitura de um inteiro que
// começa num endereço ímpar.
package main

import (
	"encoding/binary"
	"fmt"
	"runtime"
	"unsafe"
)

// ruim: o bool entre dois int64 obriga o compilador a inserir padding.
type ruim struct {
	a bool
	b int64
	c bool
}

// bom: os campos maiores vêm primeiro, e o padding some quase todo.
type bom struct {
	b int64
	a bool
	c bool
}

func main() {
	fmt.Printf("GOARCH=%s\n", runtime.GOARCH)

	// 1. Ordem dos bytes do host, vista pela própria memória.
	var x uint32 = 0x12345678
	memoria := *(*[4]byte)(unsafe.Pointer(&x))
	fmt.Printf("host: %T; bytes de 0x12345678 na memória: % x\n", binary.NativeEndian, memoria)

	// 2. A mesma palavra escrita com ordem explícita.
	le := make([]byte, 4)
	be := make([]byte, 4)
	binary.LittleEndian.PutUint32(le, 0x12345678)
	binary.BigEndian.PutUint32(be, 0x12345678)
	fmt.Printf("LittleEndian.PutUint32: % x\n", le)
	fmt.Printf("BigEndian.PutUint32:    % x\n", be)
	fmt.Printf("lendo os bytes big-endian como little-endian: 0x%08x\n", binary.LittleEndian.Uint32(be))

	// 3. Padding: o mesmo conjunto de campos em duas ordens.
	fmt.Printf("ruim: tamanho=%d alinhamento=%d  a@%d b@%d c@%d\n",
		unsafe.Sizeof(ruim{}), unsafe.Alignof(ruim{}),
		unsafe.Offsetof(ruim{}.a), unsafe.Offsetof(ruim{}.b), unsafe.Offsetof(ruim{}.c))
	fmt.Printf("bom:  tamanho=%d alinhamento=%d  b@%d a@%d c@%d\n",
		unsafe.Sizeof(bom{}), unsafe.Alignof(bom{}),
		unsafe.Offsetof(bom{}.b), unsafe.Offsetof(bom{}.a), unsafe.Offsetof(bom{}.c))

	// 4. Um inteiro de 32 bits que começa no endereço 1, ou seja, desalinhado.
	buf := make([]byte, 8)
	binary.LittleEndian.PutUint32(buf[1:], 0xCAFEBABE)
	fmt.Printf("buf: % x\n", buf)
	fmt.Printf("uint32 lido no endereço 1 (desalinhado): 0x%08x\n", binary.LittleEndian.Uint32(buf[1:5]))
}
O comando foi go vet ./... && go run ., e a saída foi esta:
GOARCH=arm64
host: binary.nativeEndian; bytes de 0x12345678 na memória: 78 56 34 12
LittleEndian.PutUint32: 78 56 34 12
BigEndian.PutUint32:    12 34 56 78
lendo os bytes big-endian como little-endian: 0x78563412
ruim: tamanho=24 alinhamento=8  a@0 b@8 c@16
bom:  tamanho=16 alinhamento=8  b@0 a@8 c@9
buf: 00 be ba fe ca 00 00 00
uint32 lido no endereço 1 (desalinhado): 0xcafebabe
A primeira linha confirma que o alvo é arm64, e a segunda mostra a memória desta máquina com os bytes 78 56 34 12, ou seja, little-endian. O tipo binary.nativeEndian é o que o pacote usa para a ordem do host. A terceira e a quarta linhas mostram que encoding/binary escreve a ordem que você pedir, e que ler big-endian como little-endian troca o número por completo: 0x78563412. A saída do padding é a mesma da seção 3. A última linha lê o inteiro desalinhado sem falha, com o valor 0xcafebabe, que foi gravado no endereço 1.
Esse último caso é o que costuma pegar quem vem de um protocolo. Um receptor que lê o pacote com a ordem errada não falha. Ele produz um número, e o número parece plausível. A figura seguinte mostra exatamente isso, com o número 300.
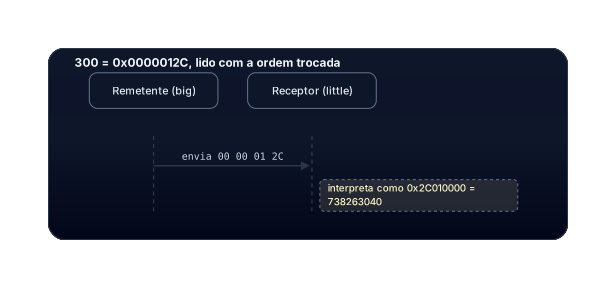
O número 300 é 0x0000012C. O remetente o grava em big-endian, e os quatro bytes que vão para o fio são 00 00 01 2C. O receptor, que interpreta a mesma sequência como little-endian, trata o primeiro byte, 00, como o menos significativo, e o último, 2C, como o mais significativo. O resultado é 0x2C010000, que vale 738263040. Nenhum byte se perdeu, e o protocolo não quebrou em nenhum momento. Só o significado mudou.
6. Onde a ordem aparece na prática
A figura abaixo organiza as áreas em que a ordem de bytes aparece, em três colunas: formatos e redes, processadores e linguagens. O texto a seguir traz a fonte de cada afirmação.
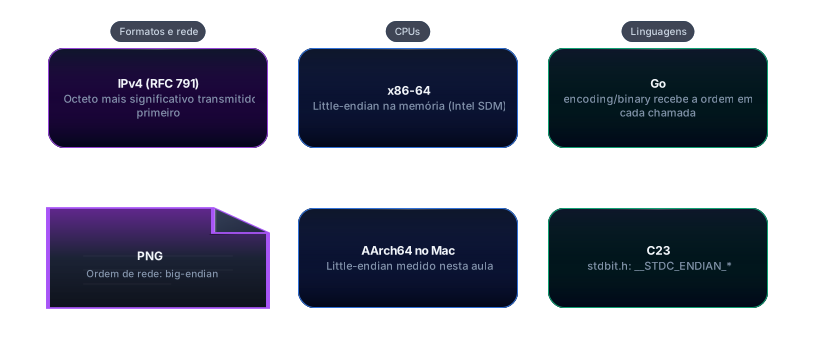
Na primeira coluna estão os formatos que fixam uma ordem. No apêndice B do RFC 791, a seção “Data Transmission Order” diz: “When a multi-octet quantity is transmitted the most significant octet is transmitted first.” O cabeçalho IPv4 segue essa regra, e por isso a ordem de rede é big-endian. O RFC não usa o termo “network byte order”, que aparece em outras documentações para a mesma regra. O formato PNG segue o mesmo caminho: na seção 7.1, o texto diz que “All integers that require more than one byte shall be in network byte order”. Os arquivos .class da JVM também são big-endian, e a especificação diz: “Multibyte data items are always stored in big-endian order, where the high bytes come first.” Um programa que lê PNG com ordem little-endian produz comprimentos de bloco errados, e perde a posição dos blocos logo no início do arquivo.
Na coluna do meio estão os processadores. A família x86-64 é little-endian, como mostrou o manual da Intel. A especificação RISC-V define o sistema de memória básico como little-endian, e as variantes big-endian ou bi-endian são tratadas como exceções. O Apple M1 Max desta aula é little-endian na prática, e o programa em Go confirma isso ao imprimir 78 56 34 12. Não confirmei a regra geral para a família AArch64, que tem as duas ordens possíveis na arquitetura. A afirmação de que quase todos os sistemas AArch64 comuns são little-endian é de conhecimento geral, e não foi conferida em documento primário.
Na última coluna estão as linguagens. A especificação da linguagem Go não menciona ordem de bytes, e o layout de memória depende do alvo. Por isso o pacote encoding/binary oferece a ordem como argumento de cada chamada. A lista de alvos de go tool dist list inclui linux/s390x e linux/ppc64, e o pacote tem binary.BigEndian para formatos que pedem a outra ordem. O C deixa a ordem para cada implementação, e o padrão C23 incluiu, no cabeçalho <stdbit.h>, as macros __STDC_ENDIAN_LITTLE__, __STDC_ENDIAN_BIG__ e __STDC_ENDIAN_NATIVE__. A macro NATIVE vale igual a uma das outras duas quando todos os tipos escalares da plataforma têm a mesma ordem, e vale diferente das duas quando a plataforma não tem ordem única.
7. Erros comuns e boas práticas
Erro 1: ler ou gravar dados binários sem declarar a ordem
Quem escreve um arquivo binário com a ordem do próprio processador tem um arquivo que só se lê direito na mesma família de processadores. Em Go, binary.Write e binary.Read pedem a ordem como argumento, e o erro está em passar a ordem errada. Em C, o fwrite de um inteiro grava a ordem do host sem avisar. O valor lido em outra máquina sai com ordem de grandeza plausível, e por isso o erro demora a aparecer.
- Boa prática: declare a ordem no formato. Use
binary.BigEndianpara redes e formatos como PNG, ebinary.LittleEndianquando o formato disser que é little-endian. Usebinary.NativeEndiansó para dados que o mesmo programa, na mesma máquina, vai ler de volta.
Erro 2: gravar uma struct inteira
Gravar a struct de uma vez, com unsafe.Sizeof ou memcpy, leva o padding para o arquivo. Os bytes de padding não são dado do programa, e o valor deles não é definido. O tamanho também muda de arquitetura para arquitetura, e a ordem dos campos vira parte do formato sem que ninguém tenha decidido isso.
- Boa prática: serialize campo por campo com a ordem explícita, como fez o programa da seção 5 com
binary.LittleEndianebinary.BigEndian. A saída fica igual em qualquer alvo, e o tamanho do formato deixa de depender do compilador.
Erro 3: converter um endereço desalinhado em ponteiro
Em C, criar um uint32_t * que aponta para um endereço desalinhado é comportamento indefinido. O código pode funcionar num processador e falhar em outro, ou funcionar hoje e quebrar com outro compilador. Em Go, a documentação do pacote unsafe não lista a leitura por ponteiro desalinhado como padrão válido. O teste da seção 4 usa memcpy, e nele nada falhou no Apple M1 Max. Isso não diz que um ponteiro desalinhado funcionaria nessa máquina, nem em outra.
- Boa prática: use
memcpyem C, ouencoding/binaryem Go, para ler dado de um buffer que pode estar desalinhado. Se o endereço vem de um pacote, leia a partir do buffer e não converta o ponteiro. Teste o código em pelo menos dois alvos de arquiteturas diferentes antes de dizer que ele é portátil.
8. Exercícios
Os exercícios usam as contas e as saídas desta aula. As respostas de referência vêm logo depois de cada um.
Exercício 1. Uma struct em C tem os campos int8_t a; int32_t b; int16_t c; int64_t d;, nessa ordem, num alvo que alinha cada campo ao próprio tamanho. Qual é o offset de cada campo e o tamanho total? Depois, calcule o tamanho se os campos forem reordenados como d, b, c, a.
Resposta de referência. Na ordem original, a fica em 0, b em 4 (alinhado a 4), c em 8 (alinhado a 2), d em 16 (alinhado a 8). O tamanho sem arredondamento seria 24, e como o alinhamento da struct é 8, o tamanho é 24. Na ordem reordenada, d fica em 0, b em 8, c em 12 e a em 14, e o total é 15, arredondado para 16. Rodei essa conta com unsafe.Offsetof e unsafe.Sizeof em Go no mesmo alvo, e a saída foi original: tamanho=24 a@0 b@4 c@8 d@16 e reordenada: tamanho=16 d@0 b@8 c@12 a@14. Um detalhe: em C o layout depende do compilador e da ABI, e a conta vale para as regras de alinhamento usuais do alvo.
Exercício 2. Escreva o inteiro 0xDEADBEEF em little-endian e em big-endian, byte a byte.
Resposta de referência. Little-endian: EF BE AD DE. Big-endian: DE AD BE EF. Conferi com int.to_bytes do Python nas duas ordens.
Exercício 3. Um protocolo grava o número 300 em big-endian. Um receptor que lê os quatro bytes como little-endian obtém qual valor? Por que o erro não gera exceção?
Resposta de referência. Os bytes são 00 00 01 2C. Lidos como little-endian, dão 0x2C010000, que é 738263040 em decimal. O erro não gera exceção porque o valor é um inteiro válido, dentro da faixa de 32 bits, e nenhuma etapa do protocolo verifica se ele faz sentido.
Exercício 4. Em uma linha de 64 bytes, um inteiro de 4 bytes começa no offset 60 e outro no offset 61. Qual dos dois cruza a fronteira da linha? E, numa linha de 128 bytes, qual dos offsets 124 e 125 cruza?
Resposta de referência. O offset 60 ocupa os bytes 60 a 63, todos na primeira linha, então não cruza. O offset 61 ocupa os bytes 61 a 64, e o byte 64 pertence à segunda linha, então cruza. Na linha de 128 bytes, o offset 124 ocupa os bytes 124 a 127 e não cruza. O offset 125 ocupa os bytes 125 a 128, e cruza. A regra geral é que um acesso de k bytes cruza a fronteira quando o offset módulo a linha é maior que tamanho da linha menos k.
Exercício 5. Na medição, o acesso desalinhado não aparece no conjunto de 16 KiB, mas aparece no conjunto de 256 MiB. Explique a diferença com base no que a seção 4 diz sobre a busca de duas linhas.
Resposta de referência. Com 16 KiB, as duas linhas cabem no L1, e a busca da segunda linha custa pouco. O processador ainda gasta ciclos extras, mas esse custo fica abaixo do ruído das execuções. Com 256 MiB, as duas linhas precisam vir da memória principal, e cada busca de linha leva da ordem de 150 ns, como a medição da seção 4.2 mostra. Quando a leitura cruza a linha de 128 bytes, o programa espera duas buscas em sequência, e a diferença entre as medianas (273 ns contra 153 ns) aparece com clareza. O valor exato depende da máquina, e a aula mediu só uma.
9. Glossário
Byte: unidade de oito bits, a menor parcela endereçável da memória nas arquiteturas de uso geral.
Endereço: número de ordem de um byte dentro do espaço de endereços da memória.
Palavra: largura natural de dado de uma arquitetura. O sentido exato muda de manual para manual, e a aula usa o termo só quando diz o tamanho.
Barramento: conjunto de fios em paralelo que leva endereços ou dados entre a CPU e a memória.
Alinhamento natural: regra em que um acesso de k bytes começa num endereço múltiplo de k.
Desalinhado: acesso cujo endereço não é múltiplo do seu tamanho. Pode ou não gerar custo, conforme a arquitetura e a posição dos bytes.
Padding: bytes vazios que o compilador insere numa struct para manter os campos alinhados.
Linha de cache: bloco de bytes que o cache transfere de uma vez. Tem 64 bytes na referência Zen 4 da trilha e 128 bytes no Apple M1 desta aula.
Little-endian: convenção em que o byte menos significativo de um valor fica no menor endereço.
Big-endian: convenção em que o byte mais significativo de um valor fica no menor endereço.
Ordem de rede: big-endian, a ordem que os protocolos da Internet usam para os campos de cabeçalho.
Latência encadeada: medida em que cada acesso depende do resultado do anterior, e o tempo mostra o atraso de uma leitura.
Vazão: medida em que os acessos são independentes e o processador pode sobrepô-los, e o tempo mostra quantos acessos cabem por unidade de tempo.
O que não foi confirmado
Estas afirmações não têm fonte primária nem medição nesta aula. Elas aparecem no texto marcadas como tal, e aqui está o motivo de cada uma.
- Regras de alinhamento da arquitetura AArch64: o comportamento de acessos desalinhados a memória Normal, o efeito da configuração do bit A do SCTLR, a regra de alinhamento das instruções exclusivas (LDXR e STXR) e a falha em memória Device. Não consegui ler o manual da Arm. As fontes secundárias encontradas são um patch do QEMU, uma discussão de bug do GCC que cita o manual sem o texto da regra, e uma resposta no Stack Overflow.
- Ordem de bytes da família AArch64 em geral: a aula confirmou que o Apple M1 Max é little-endian, pelo programa em Go. A afirmação de que os sistemas AArch64 comuns são little-endian é de conhecimento geral, e a arquitetura aceita as duas ordens.
- Largura efetiva de endereço em x86-64 e AArch64: a aula não leu a configuração de paginação que define quantos bits de endereço são usados, nem o valor típico.
- Largura dos registradores de uso geral em x86-64 e AArch64 (64 bits): conhecimento geral, não lido na documentação nesta consulta.
- Largura do canal de memória e tamanho da rajada em DDR: a afirmação de que um canal tem 64 bits de dados e que uma rajada leva 64 bytes é conhecimento geral sobre DDR, e a especificação JEDEC não foi consultada.
- Linha de 64 bytes da referência Zen 4: a aula usa esse valor como convenção da trilha. A seção 4.3 da aula de hierarquia já registra que o número não foi lido em documentação da AMD.
- Comportamento RISC-V de cada implementação: a especificação deixa a escolha de tratar o desalinhado em hardware ou com exceção ao projetista. Não há uma implementação específica aqui.
- Causa do aumento de custo no offset 61 da medição: o programa não mediu contadores de hardware, e a explicação não está fechada. Também não está confirmado que, no offset 125, o aumento venha exatamente de duas buscas sequenciais na memória principal, embora seja a explicação mais simples e combine com a descrição da Intel.
- Validade dos números da medição: os valores valem para um Apple M1 Max com carga média entre 12 e 30 e para este programa. Não são latências da referência Zen 4, e outra máquina pode dar outro valor.
- Arquiteturas big-endian do Go:
go tool dist listconfirma os nomeslinux/s390xelinux/ppc64, mas a ordem de bytes desses alvos não foi lida em documentação. - Ordem de bytes no padrão C: a aula afirma que a ordem é definida pela implementação, como conhecimento geral. A cláusula do padrão não foi lida. As macros de C23 foram conferidas numa página de referência, não no texto do padrão.
- Nota de Danny Cohen (IEN 137, 1980): foi lida numa cópia publicada no tuhs.org, e não no original.
- Data e hora das execuções: os horários vêm do relógio da máquina na data de consulta, e não de um servidor de referência.
Fontes
Consultadas em 2 de novembro de 2026.
- Intel. Intel 64 and IA-32 Architectures Software Developer’s Manual, Volume 1: Basic Architecture, ordem 253665-084US. Seções 1.3.1 (bit e ordem de bytes), 4.1 e 4.1.1 (alinhamento e custo de duas buscas), e figura 4-2. Disponível em: https://cdrdv2-public.intel.com/825744/253665-sdm-vol-1.pdf
- IETF. RFC 791, Internet Protocol, apêndice B, “Data Transmission Order”. Disponível em: https://www.rfc-editor.org/rfc/rfc791
- W3C. Portable Network Graphics (PNG) Specification, seção 7.1, “Integers and byte order”. Disponível em: https://www.w3.org/TR/png/
- Oracle. The Java Virtual Machine Specification, Java SE 25 Edition, capítulo 4, “The class File Format”. Disponível em: https://docs.oracle.com/javase/specs/jvms/se25/html/jvms-4.html
- RISC-V International. The RISC-V Instruction Set Manual, Volume I: Unprivileged ISA, com os arquivos fonte do repositório oficial, em particular os capítulos de introdução e de memória, a extensão Zicclsm, e o texto de RV32I sobre acessos desalinhados. Disponível em: https://github.com/riscv/riscv-isa-manual/tree/main/src/unpriv
- cppreference. “Endianness” (C23,
<stdbit.h>). Disponível em: https://en.cppreference.com/w/c/numeric/endian - Go. Especificação da linguagem, seção “Size and alignment guarantees”, lida na cópia local da toolchain go1.27.2 (
$(go env GOROOT)/doc/go_spec.html). Tambémgo doc encoding/binaryego doc unsafe, na mesma toolchain. - Cohen, Danny. On Holy Wars and a Plea for Peace, IEN 137, 1980. Lido numa cópia de tuhs.org: https://www.tuhs.org/Usenet/comp.sys.sgi/1991-April/009071.html
- Medições desta aula: programas C e Go rodados em 2 de novembro de 2026 no Apple M1 Max, com
sysctl,getconf PAGESIZE,sw_verseuptime. Os códigos e as saídas estão acima.
Relacionados
- Bits e binário: base 2, hexadecimal e a representação dos bytes que esta aula usa.
- Ciclo de instrução e unidade de controle: a CPU que busca e executa as instruções que leem a memória.
- Hierarquia de memória e localidade: a linha de cache, a latência de cada nível e a origem da busca fora do cache.
- SRAM, DRAM e armazenamento: por que a RAM responde em dezenas a centenas de nanossegundos, o que pesa nas medições da seção 4.2.
- ISA, CISC e RISC: as diferenças de conjunto de instruções entre x86 e RISC, que explicam a tabela de alinhamento.
- Assembly na prática: como um load aparece em instruções reais.
- Inteiros, complemento de dois e overflow: a representação dos inteiros cujos bytes esta aula ordena.
- Texto, ASCII, Unicode e UTF-8: a codificação dos bytes da figura 01, que são códigos ASCII.
- A aula de cache, na fase 4 da trilha, ainda não foi escrita. Ela deve explicar as linhas de 64 bytes com mais detalhe.
- Trilha de Hardware: o mapa de estudo em que esta aula se encaixa.