Hardware e sistemas operacionais · parte 20 de 27
Cache: linhas, associatividade e o que acontece num miss
Como o cache encontra um dado por tag, índice e deslocamento, o que acontece num miss e como associatividade e substituição mudam a taxa de acerto.
intermediárioPublicada em · 39 min de leitura
Imagine a prateleira da frente de um mercado. Ela fica na altura da mão, guarda só o que costuma sair rápido e, quando um produto acaba, o funcionário vai ao depósito buscar uma caixa inteira, e não uma unidade. Um cache funciona quase do mesmo jeito. É uma memória pequena, feita de SRAM, colocada entre a CPU e a RAM, que guarda cópias de dados usados há pouco ou que devem ser usados logo. Quando a CPU pede um dado que está ali, a resposta sai em poucos ciclos. Quando não está, há um miss, e o dado precisa vir de um nível mais lento.
A aula Hierarquia de memória e localidade mostrou por que existem vários níveis e por que a localidade faz o cache funcionar. Esta aula entra no nível L1 e pergunta como ele faz o trabalho: como acha um dado sem varrer tudo, o que guarda junto com cada dado, quem sai quando o espaço acaba e o que acontece quando a CPU escreve. A física das células que formam o cache está em SRAM, DRAM e armazenamento, e não é repetida aqui.
Mapa da aula
| Seção | Pergunta que responde |
|---|---|
| 1. O que é um cache e por que ele guarda linhas | Por que o cache não copia um byte por vez? |
| 2. Para que serve | Qual problema de desenho o cache precisa resolver? |
| 3. Exemplos em contextos diferentes | Onde a mesma lógica aparece fora da CPU? |
| 4. Como funciona por dentro | Como um endereço vira tag, índice e deslocamento, e o que acontece num hit e num miss? |
| 5. Detalhes e bordas | Quanto a associatividade custa, e como ela interage com a localidade da aula 4.1? |
| 6. Erros comuns e boas práticas | Quais decisões de código dependem do cache? |
| 7. Simulação e medição | Quantos misses cada organização faz num padrão de acesso conhecido? |
| 8. Exercícios | Questões de cálculo e de projeto, com resposta de referência |
| 9. Glossário | Termos técnicos desta aula |
| O que não foi confirmado | Quais números e afirmações são modelo, e não medição ou fonte primária? |
| Fontes | De onde vêm os fatos, e quando foram consultados |
1. O que é um cache e por que ele guarda linhas
A CPU de referência desta trilha responde em 4 ciclos quando o dado está na L1. A RAM leva cerca de 496 ciclos para responder. Ter uma memória rápida perto do núcleo é ótimo, mas ela só serve se guardar o que a CPU vai pedir em seguida, e isso depende de a localidade do programa ser boa.
Repare numa coisa que quase ninguém espera. O cache não guarda bytes soltos. Quando a CPU pede um único byte que não está na L1, o hardware traz um bloco inteiro de bytes, alinhado a um endereço múltiplo do tamanho do bloco. Esse bloco é a linha de cache (cache line), e na referência desta aula ela tem 64 bytes. A linha é a unidade de transferência entre a RAM e o cache. Ninguém compra um ovo na granja; compra-se a caixa. O cache também funciona assim, porque a viagem até a RAM já é cara, e aproveitá-la para trazer os vizinhos costuma valer a pena, desde que o programa use esses vizinhos.
Cada linha guarda, além dos 64 bytes de dados, algumas informações de controle: se a linha está em uso, se foi alterada e de qual bloco da RAM ela veio. A seção 4 mostra cada uma delas. Por enquanto basta saber que a unidade do cache é a linha, e não o byte.
2. Para que serve
Imagine um cache sem nenhum método de busca. Para saber se um endereço está guardado, a CPU teria de comparar o endereço com cada uma das 512 linhas da L1 de 32 KB. Fazer 512 comparações em 4 ciclos não cabe no hardware. O cache precisa responder com uma conta direta, que diz em qual lugar procurar, e com poucas comparações ali.
Essa exigência obriga o desenho a responder quatro perguntas. A primeira é onde um bloco pode morar, e a resposta define a organização do cache: direta, associativa por conjunto ou totalmente associativa. A segunda é como achar o bloco, e a resposta é a divisão do endereço em tag, índice e deslocamento. Cada um desses campos é uma parte dos bits do endereço: a tag identifica o bloco, o índice escolhe o conjunto e o deslocamento escolhe o byte. A seção 4.1 explica os três com a conta completa. A terceira é quem sai quando o espaço acaba, e isso é a política de substituição. A quarta é o que fazer quando a CPU escreve, e isso é a política de escrita. Cada resposta tem um custo em área, em energia e em tempo, e nenhuma delas é grátis. A seção 4 percorre as quatro, começando pela organização, que é a que mais muda o hardware.
3. Exemplos em contextos diferentes
A mesma lógica aparece em estruturas que não têm nada de hardware.
O primeiro exemplo é uma tabela hash de tamanho fixo, com 64 baldes e espaço para dois itens em cada balde. A função de hash escolhe o balde, que faz o papel do índice. Dentro do balde, a busca compara as chaves, e essas chaves fazem o papel das tags. Quando o balde enche, um item precisa sair para caber o novo. Essa é a imagem mais próxima de um cache associativo por conjunto, e ela vale como modelo mental, não como descrição do hardware.
O segundo exemplo é um estacionamento. Se cada placa tem uma vaga fixa, dois carros com a mesma vaga disputam o mesmo lugar, e o segundo não entra enquanto o primeiro estiver lá, mesmo que o pátio inteiro esteja vazio. Esse é o mapeamento direto. Se a vaga for escolhida entre as da mesma fileira, a disputa só acontece dentro da fileira. Se qualquer vaga servir, o carro só não entra quando o pátio lota.
O terceiro exemplo vem direto da aula 4.1. Um vetor de inteiros de 4 bytes lido do começo ao fim gera um miss a cada 16 leituras, porque a linha de 64 bytes traz 16 inteiros de uma vez. Essa taxa de 6,25% aparece na seção 7 mesmo quando o vetor é maior que a cache, porque a localidade espacial sustenta o padrão. O que muda entre os exemplos é a regra de escolha, e a conta por trás de cada um é a mesma: quantas vagas existem, e quantas coisas disputam cada vaga.
4. Como funciona por dentro
4.1 Endereço partido em tag, índice e deslocamento
Quando o núcleo calcula um endereço, o cache trata os bits dele em três campos. O deslocamento (offset) são os bits menos significativos, que escolhem o byte dentro da linha. Com linhas de 64 bytes, são 6 bits, porque 2 elevado a 6 é 64. O índice são os bits logo acima do deslocamento, e eles escolhem o conjunto de linhas onde o bloco pode estar. A tag são os bits que sobram no topo, e eles dizem qual bloco da RAM está guardado naquela linha.
Na L1 de referência, de 32 KB com 8 vias e linhas de 64 bytes, há 32 KB dividido por 64 bytes, ou seja, 512 linhas. Como cada conjunto tem 8 vias, são 512 dividido por 8, ou seja, 64 conjuntos. Então o índice tem 6 bits, porque 2 elevado a 6 é 64. Num endereço de 32 bits, a tag tem o que sobra: 32 menos 6 do deslocamento e menos 6 do índice, o que dá 20 bits.
A figura mostra os 32 bits do endereço 0x12345678, pintados pelo campo a que cada um pertence.
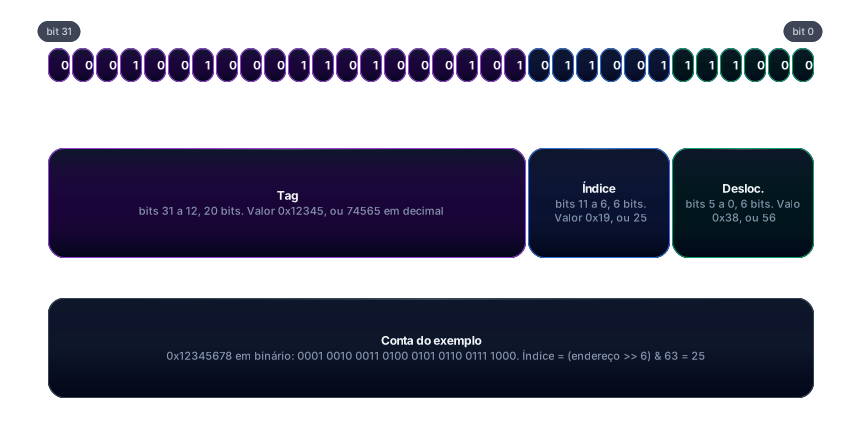
Leia a figura da esquerda para a direita. Os 20 bits da tag formam 0x12345. Os 6 bits do índice são 011001, que dá 25 em decimal. Os 6 bits do deslocamento são 111000, que dá 56. Esse endereço, portanto, procura o conjunto 25 e o byte 56 da linha. Se alguma via desse conjunto estiver válida e tiver a tag 0x12345, temos um hit. Caso contrário, temos um miss.
Repare que o índice só decide onde procurar. Ele não identifica o bloco. Dois endereços com o mesmo índice e tags diferentes disputam o mesmo conjunto, e os que diferem só na tag são exatamente os que se atrapalham. Esse detalhe é a chave para entender os conflitos da seção 5.
A aula usa endereços de 32 bits para que as contas caibam na tela. Um processador real tem endereços físicos maiores, e a tag cresce com eles. Com um endereço físico de 48 bits, por exemplo, a mesma L1 teria tag de 36 bits, pela mesma conta: 48 menos 6 menos 6. Quantos bits de endereço físico cada processador usa não foi confirmado nesta aula.
4.2 A linha de cache: bits de controle, tag e dados
Cada entrada do arranjo guarda quatro coisas. O bit V (válido) diz se a entrada tem dados de verdade. Quando o cache acaba de ser ligado, todas as entradas têm V igual a 0, porque ainda não há nada guardado. O bit D (sujo), usado só na escrita, marca que a linha foi alterada desde que chegou da RAM. A tag identifica o bloco. Os 64 bytes são os dados propriamente ditos.
A figura segue o caminho de uma leitura de um byte que não está na linha.
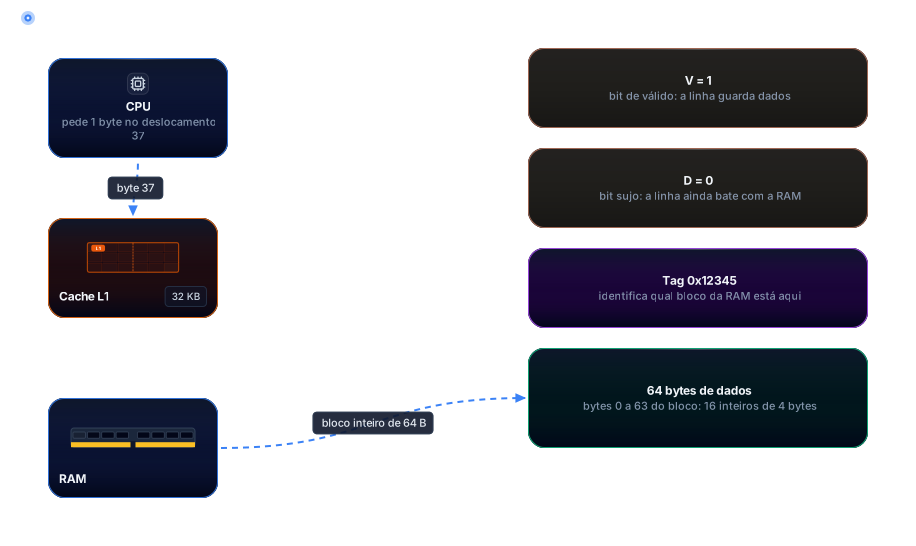
A CPU pede o byte 37, mas o que sai da RAM é o bloco inteiro, de 64 bytes, e ele fica guardado na L1. Como os 64 bytes equivalem a 16 inteiros de 4 bytes, uma única transferência atende as 16 leituras seguintes desses inteiros. É aqui que a localidade espacial da aula 4.1 vira um ganho concreto.
Esse tamanho de 64 bytes não é universal, e vale qualificar de onde vem o número. Nas máquinas x86 de referência desta aula, a linha costuma ser de 64 bytes. A fonte secundária consultada, o WikiChip, descreve o L1 de dados do Zen 4 com linhas de 64 bytes, mas a documentação da própria AMD não foi lida nesta consulta. O Apple M1 Max desta aula informa 128 bytes no sysctl (seção 7). Os POWER7 a POWER9 também usam 128 bytes, segundo as fontes secundárias citadas na aula 4.1. Não dá para generalizar: a escolha depende do processador, e esta aula não levantou outros projetos.
Linhas maiores aproveitam melhor a localidade espacial, porque cada miss traz mais vizinhos. Em compensação, um miss traz mais bytes que talvez nunca sejam usados, e cada entrada do arranjo fica maior. A troca é a mesma que a aula 4.1 descreveu na seção de linhas de cache.
4.3 Mapeamento direto, associativo por conjunto e totalmente associativo
A organização responde à pergunta de onde um bloco pode morar. No mapeamento direto, cada bloco da RAM tem exatamente uma entrada possível, escolhida pelo índice. Se dois blocos com tags diferentes caem na mesma entrada, cada troca expulsa o outro. A busca é barata, porque há um único comparador, mas os conflitos são frequentes.
No associativo por conjunto de N vias, o índice escolhe um conjunto, e o bloco pode ocupar qualquer uma das N vias daquele conjunto. A busca compara a tag com as N vias em paralelo, e isso custa N comparadores. A L1 de referência tem 8 vias, então são 8 comparadores por acesso. No totalmente associativo há um único conjunto, com todas as linhas. Não há índice, e o bloco pode ir para qualquer entrada. Para achar um dado, seria preciso comparar a tag com todas as linhas da cache. Por isso esse desenho só cabe em estruturas pequenas.
Para uma mesma capacidade, o número de linhas é o mesmo nas três organizações. O que muda é quantos conjuntos existem e quantas vias cada um tem. Na L1 de 32 KB com linhas de 64 bytes, a conta fica assim:
| Organização | Conjuntos | Vias por conjunto | Comparadores por acesso |
|---|---|---|---|
| Mapeamento direto | 512 | 1 | 1 |
| Associativa por conjunto de 2 vias | 256 | 2 | 2 |
| Associativa por conjunto de 8 vias (a L1 de referência) | 64 | 8 | 8 |
| Totalmente associativa | 1 | 512 | 512 |
A figura mostra uma miniatura com 4 conjuntos e 2 vias, para caber na página. A regra é a mesma da L1 real: o índice escolhe a linha horizontal, e as duas colunas são as vias.
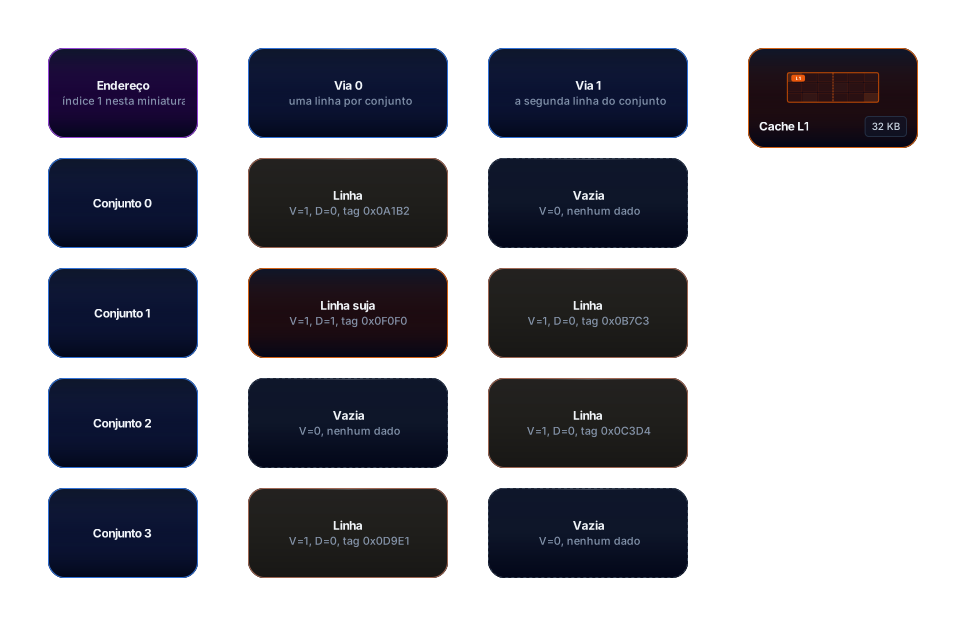
O endereço da seção 4.1 cai no conjunto 1 desta miniatura, porque 25 dividido por 4 deixa resto 1. Isso é só uma coincidência de desenho, já que a L1 real tem 64 conjuntos, e não 4. A linha laranja é suja, e as linhas tracejadas estão vazias. Os conjuntos 0, 2 e 3 têm espaço, mas um endereço que cai no conjunto 1 só pode usar as duas vias dele. É esse limite que produz os conflitos da seção 5.
4.4 Hit e miss percorrendo o arranjo
Uma leitura segue quatro passos. O índice escolhe o conjunto. A tag do endereço é comparada com a tag de cada via válida desse conjunto, em paralelo. Se alguma via bate e tem V igual a 1, temos um hit: o deslocamento escolhe o byte, e ele vai para a CPU. Se nenhuma via bate, temos um miss.
No hit, o caminho é curto e não envolve a RAM. A figura mostra o endereço 0x12345678 procurando o conjunto 1 da miniatura.
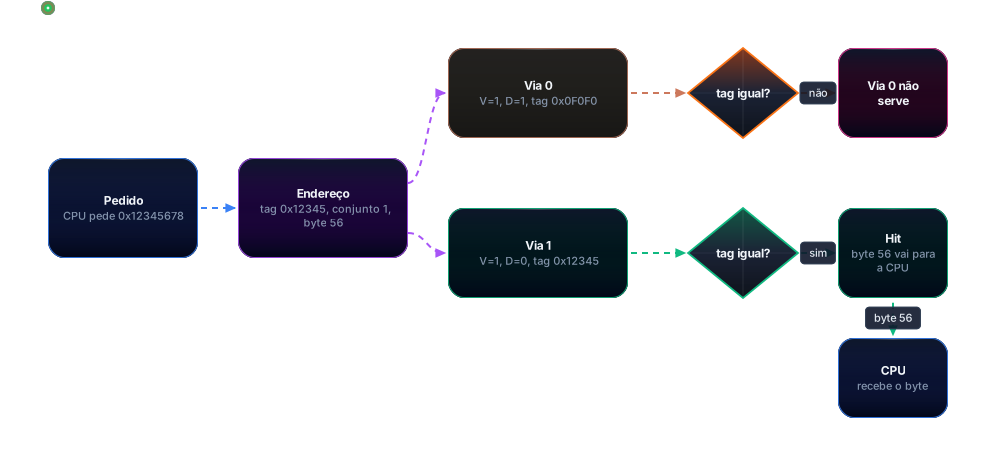
A via 0 tem a tag 0x0F0F0, que não serve. O comparador da via 0 diz não. A via 1 tem a tag 0x12345, que é a do endereço, e o comparador diz sim. Esse sim é o hit, e o byte 56 sai da linha direto para a CPU. O custo é o tempo de acerto do L1, de 4 ciclos na referência.
No miss, nenhuma via bate, e o hardware precisa escolher uma vítima entre as vias do conjunto. A escolha depende da política de substituição, que a seção 4.6 explica. Se a vítima estiver suja, ela precisa ser gravada na RAM antes de a linha nova ocupar o lugar dela. A penalidade do miss, portanto, pode ser a ida à RAM mais o despejo de uma linha suja, e por isso um miss com vítima suja custa mais que um miss com vítima limpa. Uma leitura num cache de write-back pode exigir duas transferências com a memória, segundo a página da Wikipedia citada nas fontes.
A figura segue um miss, com a vítima suja.
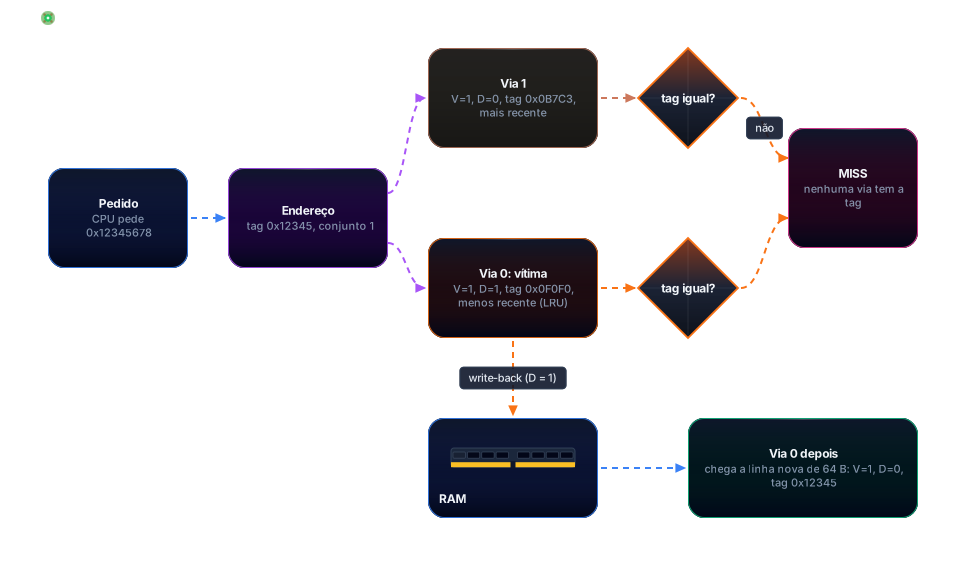
Os dois comparadores dizem não. A via 0 é a vítima, porque é a menos recente, e como tem D igual a 1 ela grava a linha inteira na RAM antes de sair. Depois disso, a linha nova chega e ocupa a via 0 com a tag 0x12345, com V igual a 1 e D igual a 0. A CPU só recebe o byte depois desse preenchimento. Por isso o tempo do miss é a soma das etapas, e não só o tempo da RAM.
4.5 Os três tipos de miss
Nem todo miss tem a mesma causa, e separar as causas mostra qual conserto funciona. O modelo dos três Cs classifica cada miss com uma pergunta de cada vez.
A primeira pergunta é se o bloco já apareceu antes na execução. Se nunca apareceu, o miss é compulsório, ou de primeira referência. Nenhuma organização evita esse miss, porque ninguém poderia ter guardado um dado que nunca foi lido. Só prefetch ou linhas maiores reduzem esse tipo.
Se o bloco já apareceu, a segunda pergunta é se uma cache totalmente associativa do mesmo tamanho também erraria. Se errar, o miss é de capacidade: o conjunto de dados que o programa usa é maior que a cache, e o bloco saiu porque o espaço acabou. Aumentar a associatividade não resolve esse caso, só aumentar a capacidade.
Se a cache totalmente associativa acertaria, o miss é de conflito. A cache real tinha espaço no total, mas o bloco caiu num conjunto cheio. Esse é o tipo que a associatividade combate, e é o que a seção 7 mede.
A definição é operacional. O simulador da seção 7 faz exatamente essa comparação, com uma referência totalmente associativa de mesmo tamanho. A figura põe os três casos lado a lado.
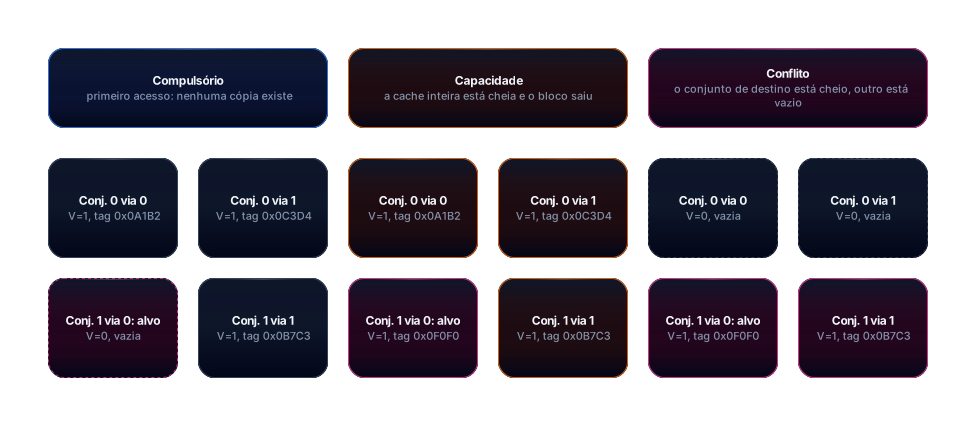
Os três casos se distinguem pelo que há ao redor do alvo. No compulsório, a linha nunca existiu. No de capacidade, todos os conjuntos estão cheios. No de conflito, o conjunto do alvo está cheio, enquanto o conjunto 0 tem duas vagas vazias. A associatividade mexe só no último caso, e por isso é tão tentador confundir os três. Um cache de 8 vias troca muitos conflitos por hits, mas não encolhe o conjunto de dados que o programa precisa.
4.6 Política de substituição: LRU e pseudo-LRU
Quando o conjunto está cheio e há miss, uma via precisa sair. A regra mais intuitiva é o LRU (least recently used), que expulsa o bloco usado há mais tempo. A ideia se apoia na localidade temporal da aula 4.1: um bloco que não é usado há muito tempo tem menos chance de ser usado logo. O LRU exato guarda, para cada conjunto, a ordem completa de uso das vias. A página da Wikipedia sobre políticas de substituição diz que essa ordenação se torna cara quando a associatividade cresce, e que por isso ela costuma ser evitada acima de quatro vias.
A figura acompanha a pilha LRU de um conjunto de 4 vias ao longo de uma sequência de acessos. Depois de A, B, C e D, a ordem do mais recente ao menos recente é D, C, B, A, e A é a vítima. O acesso a A é um hit, e leva A para o topo. Agora a vítima é B. Quando E chega, há um miss: B sai e E entra no topo.
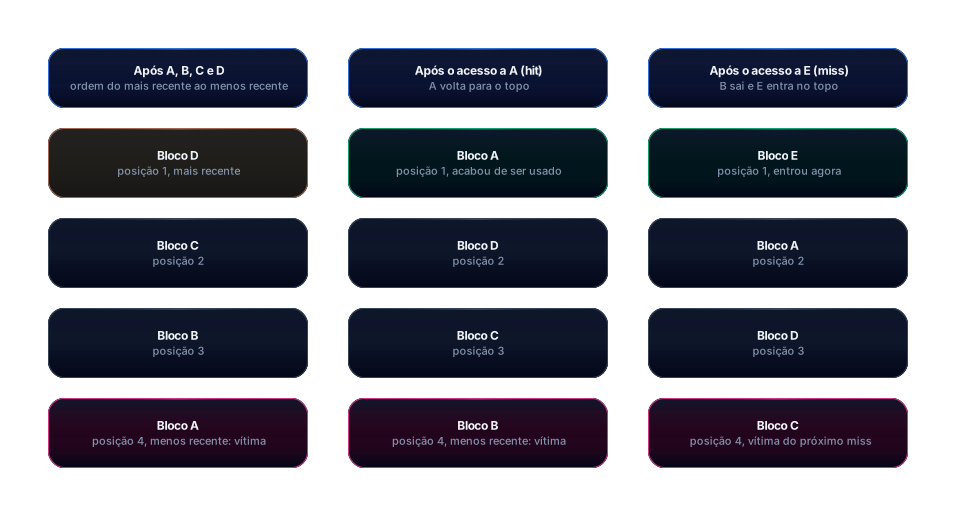
Como o LRU exato é caro, a maioria dos projetos usa uma aproximação. O pseudo-LRU em árvore usa uma árvore binária de bits com um bit por nó interno. Cada bit aponta para o lado menos recentemente usado daquele nó. Um acesso desvia os bits do próprio caminho para longe da via acessada. Para escolher a vítima, basta seguir os bits da raiz até uma folha. Numa árvore de N vias há N menos 1 nós internos, então são 3 bits para 4 vias e 7 bits para 8 vias. Essa contagem sai da estrutura da árvore, e não de uma fonte específica.
A figura usa a sequência de acessos 0, 1, 2, 3 e 0 em 4 vias. Os bits finais são b0 igual a 1 na raiz, b1 igual a 1 no nó esquerdo e b2 igual a 0 no nó direito.
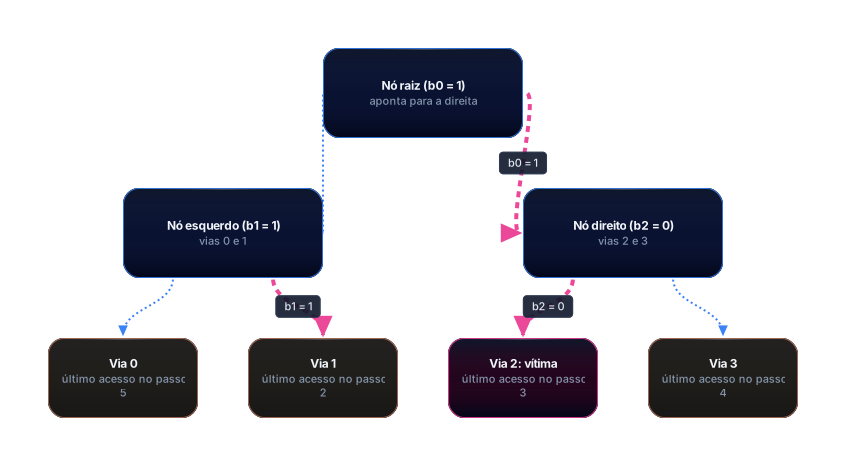
A conta, feita passo a passo, segue esta convenção: bit 0 aponta para o filho esquerdo, bit 1 aponta para o filho direito, e um acesso desvia os bits do caminho para o lado oposto ao acessado. Começamos com todos os bits em 0. O acesso à via 0 coloca a raiz em 1 (longe da esquerda) e o nó esquerdo em 1 (longe da via 0). O acesso à via 1 mantém a raiz em 1 e põe o nó esquerdo em 0 (longe da via 1). O acesso à via 2 põe a raiz em 0 (longe da direita) e o nó direito em 1 (longe da via 2). O acesso à via 3 põe a raiz em 0 de novo e o nó direito em 0 (longe da via 3). O último acesso, à via 0, deixa a raiz em 1 e o nó esquerdo em 1. Os bits finais são raiz 1, esquerdo 1 e direito 0.
Para escolher a vítima, seguimos os bits. A raiz vale 1, então a busca vai para a metade direita. O nó direito vale 0, então a vítima é a via 2. Já o LRU exato escolheria a via 1, que foi usada pela última vez no passo 2, enquanto a via 2 foi usada no passo 3. A árvore não guarda a ordem completa, só qual metade é mais antiga e qual via é a mais antiga dentro de cada metade. É uma aproximação, e ela erra de propósito para economizar bits e lógica.
A Wikipedia descreve o PLRU como uma escolha que usa só um bit por item da cache, com uma taxa de miss um pouco pior que a do LRU, uma latência um pouco menor e um custo de hardware menor. Essa é a troca que o exemplo mostra. Algumas arquiteturas usam substituição aleatória, que não guarda histórico nenhum. A mesma página cita o uso desse método em processadores ARM.
4.7 Escrita: write-through e write-back
Ler é simples, porque a cópia na cache é só uma cópia. Escrever exige uma decisão, porque agora existem duas versões do dado: a da cache e a da RAM. A política de escrita define quando a RAM fica sabendo da mudança.
No write-through, toda escrita na cache também é enviada ao nível de baixo. A RAM fica sempre atualizada, e nenhuma linha precisa de um bit extra. No write-back, a escrita fica só na cache. A linha recebe o bit D igual a 1, e a RAM só recebe a linha inteira quando ela é despejada. A página da Wikipedia resume a diferença: no write-through, cada escrita na cache causa uma escrita na memória principal, e no write-back as escritas não vão imediatamente para a memória, e as posições alteradas são marcadas como sujas.
Cada uma tem seu lado. O write-through é mais simples e mantém a RAM sempre igual à cache, o que facilita a vida de outros agentes que leem a memória. O write-back gasta menos transferências quando a mesma linha recebe muitas escritas, mas exige o bit D e um caminho de despejo, e o despejo pode acontecer longe da escrita original.
A figura mostra três stores de 4 bytes na mesma linha, nas duas políticas.
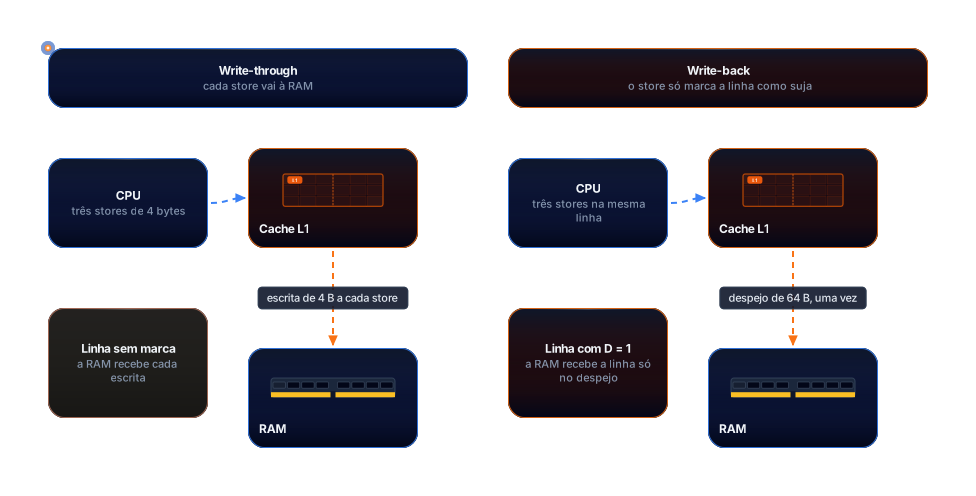
No write-through, cada store vira uma escrita de 4 bytes na RAM, e as três escritas aparecem como três transferências. No write-back, os três stores só mudam a linha da L1 e deixam D igual a 1. Quando a linha sai, a RAM recebe 64 bytes, de uma vez. Com três escritas, a diferença é pequena, e o exercício 4 da seção 8 mostra o ponto em que a conta se inverte.
Há ainda a escolha do que fazer num miss de escrita: trazer a linha para a cache antes de escrever, o que se chama write-allocate, ou escrever direto na RAM sem trazê-la. Essa parte não foi lida nas fontes desta consulta, e está registrada em “O que não foi confirmado”.
5. Detalhes e bordas
A associatividade tem custo. Cada via a mais é um comparador a mais em cada acesso, e isso gasta energia e área, e pode alongar o caminho do hit. Por isso, existe um ponto em que aumentar as vias deixa de compensar. A conta abaixo mostra o trade-off com o modelo de tempo médio de acesso (AMAT), com 4 ciclos de acerto e 14 ciclos de penalidade, os números da L1 e da L2 da referência:
AMAT = tempo de acerto + taxa de miss × penalidade de miss
No mapeamento direto da seção 7, a taxa de miss do padrão de passo de 4 KB é de 30%. A conta fica 4 + 0,30 × 14 = 8,2 ciclos. Na organização de 8 vias, a mesma sequência tem taxa de 100%, e a conta fica 4 + 1,00 × 14 = 18 ciclos. O exemplo supõe que o tempo de acerto é o mesmo nas duas organizações, o que costuma não ser verdade: uma cache de 8 vias tem comparação mais larga. Esse número não foi medido nesta aula, e aparece em “O que não foi confirmado”. O exemplo é extremo de propósito. Mostra o que acontece quando o padrão de acesso cai no pior caso da organização.
A figura 10 mostra por que esse padrão de 4 KB é tão ruim para 8 vias.
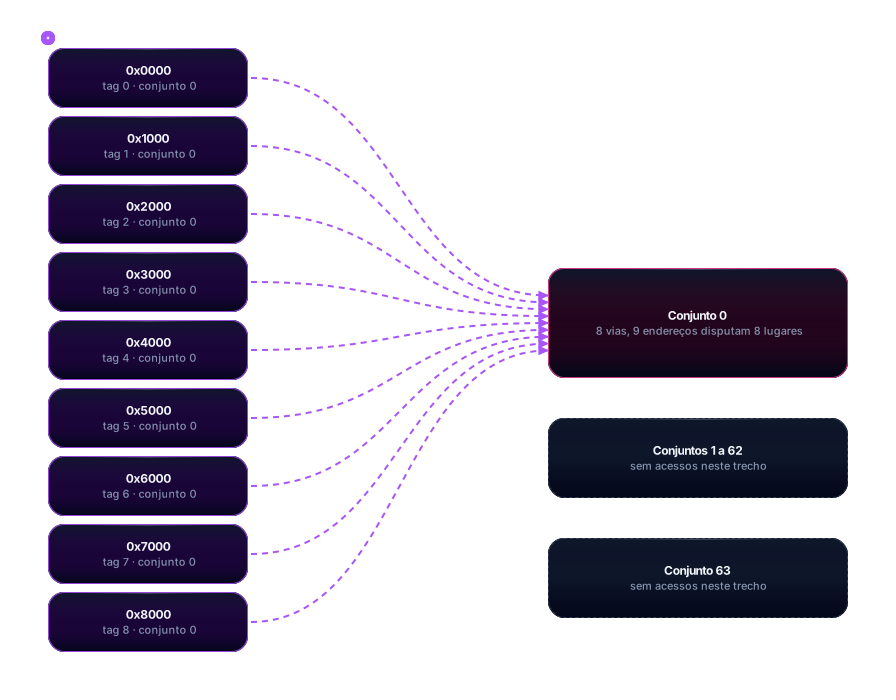
Com 64 conjuntos, o índice são os bits de 6 a 11. Um passo de 4096 bytes é igual a 2 elevado a 12, então só muda o bit 12 em diante, e o índice de todos os endereços continua 0. Os nove endereços caem no conjunto 0 e disputam 8 vias. Com LRU, percorrer nove blocos em ciclo num conjunto de 8 vias faz cada acesso ser um miss, porque o bloco que sai é justamente o que será lido em seguida. É o caso típico em que o LRU erra: o resultado depende do padrão de acesso, e não só do número de vias.
A mesma capacidade, com outra organização, muda o resultado. No mapeamento direto, há 512 conjuntos, e o índice passa a usar os bits de 6 a 14. Os endereços de passo de 4 KB ainda se repetem a cada 8 passos, então só os blocos 0 e 8 caem no mesmo lugar. Por isso a organização direta erra menos que a de 8 vias nesse padrão, e a seção 7 mostra os números. Associatividade maior é melhor quando os conflitos são o problema, mas o padrão do programa decide se eles existem.
A localidade espacial é a propriedade que a associatividade menos afeta. Na varredura de 64 KB da seção 7, a taxa de miss é de 6,25% nas quatro organizações, porque não há conflitos a resolver, só capacidade e miss compulsório. A figura 11 mostra as duas taxas lado a lado.
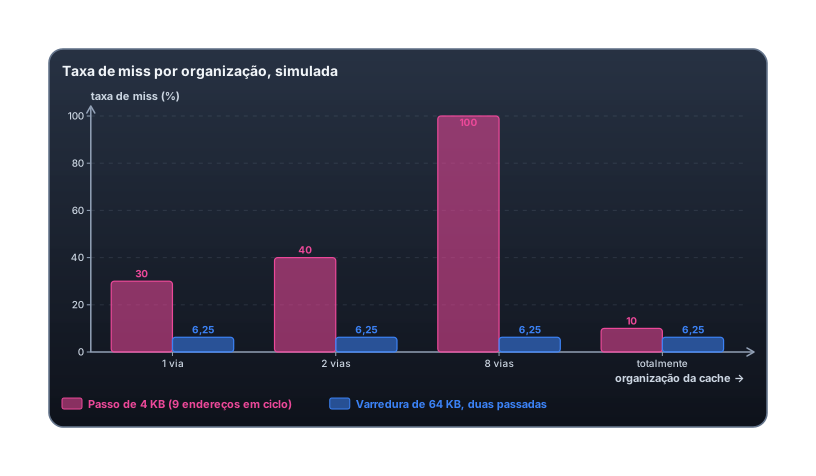
A conclusão prática é que a associatividade protege a localidade temporal dos conflitos, mas nenhuma organização protege um padrão que não cabe no cache. A simulação usa LRU exato, e um processador com pseudo-LRU pode errar de forma diferente. Esta aula não mediu nenhum processador real com esse padrão.
Alguns pontos de borda merecem uma menção, mesmo sem aprofundamento. Os níveis L2 e L3 também têm linhas, vias e políticas, e as regras desta aula valem para eles com outros números. A relação de inclusão entre os níveis está na aula 4.1. Na prática, a L1 pode ser indexada com endereço virtual, para não esperar a tradução de endereço, e isso muda quais bits entram no índice. Esta aula usa endereço físico para simplificar, e o assunto não foi aprofundado.
6. Erros comuns e boas práticas
Erro 1: achar que o cache guarda só o que foi pedido. Um byte pedido traz uma linha inteira de 64 bytes, e quem acessa um byte por vez de um dado espalhado paga pela linha toda e usa só uma fração dela. Quem pede um ovo e recebe a caixa de doze descobre que a caixa também cobra. Boa prática: organize os dados que são lidos juntos em áreas contíguas, para que cada linha trazida seja aproveitada.
Erro 2: achar que mais vias é sempre melhor. A seção 5 mostra o contrário para o padrão de passo de 4 KB, em que a organização direta faz menos misses que a de 8 vias. Mais vias custam comparadores e tempo de acerto, e o ganho depende do padrão. Boa prática: medir com o padrão real do programa antes de escolher uma organização, e não com a intuição de que “mais” é “melhor”.
Erro 3: montar matrizes e vetores com passos de potência de dois. Um passo de 4 KB ou de 16 KB cai sempre no mesmo conjunto, como a seção 5 mostra, e a matriz de 4096 por 4096 da aula 4.1 sofre exatamente isso quando percorrida por coluna. Boa prática: se o tamanho da linha for uma folga, a conta do próprio modelo mostra o efeito. Com uma linha de 4096 inteiros mais 16 inteiros de folga, cada linha ocupa 4160 bytes, e 4160 dividido por 64 é 65, de modo que o índice avança 1 a cada linha e os conjuntos são distribuídos. Essa conta é do modelo, e não foi medida neste texto.
Erro 4: tratar miss como defeito. Um miss é o cache fazendo a parte dele, que é trazer o bloco certo quando ainda não está lá. O problema é um miss desnecessário, ou um miss caro, com vítima suja e fila de despejo. Boa prática: distinguir os três tipos da seção 4.5 antes de decidir o que mudar. Um miss compulsório pede outro algoritmo, e um de conflito pede outra forma de acessar os dados.
Erro 5: esquecer o custo do despejo na escrita. Um write-back parece barato porque as escritas somem dentro da cache, mas a linha suja ainda sai um dia, e sai inteira. Um programa que escreve de forma espalhada, tocando uma linha diferente a cada escrita, pode gerar muito mais despejos que um programa que escreve em sequência. Boa prática: agrupar escritas que caem na mesma linha, em vez de espalhá-las.
Erro 6: assumir 64 bytes em toda máquina. A seção 4.2 mostrou que o Apple M1 Max desta aula tem linhas de 128 bytes, e que o mesmo código pode ter comportamento diferente nessas máquinas. Boa prática: consultar o tamanho da linha da máquina onde o código vai rodar, e não supor um valor universal. No macOS, o sysctl informa isso, como a seção 7 mostra.
7. Simulação e medição
Esta seção não mede hardware. Ela roda um simulador de cache com LRU exato, nas regras da seção 4, sobre dois padrões de acesso, e conta hits e misses por tipo. O simulador é determinístico, então o resultado se repete em qualquer máquina com Python 3. O modelo não representa pseudo-LRU, prefetch nem a L1 real de nenhum processador, e os números valem para o modelo.
O simulador está abaixo, e foi executado sem alterações.
"""cache_sim.py: simula uma cache com LRU e conta hits e misses por tipo.

Não mede hardware. Simula a organização (conjuntos, vias, linha) sobre uma
sequência de endereços, para comparar configurações com a mesma capacidade.

Classificação dos misses (modelo dos 3 Cs):
  compulsório: primeira vez que a linha aparece no trace
  capacidade:  a cache totalmente associativa, com a mesma capacidade, também erra
  conflito:    a totalmente associativa acerta, mas a cache real erra

Uso: python3 cache_sim.py
"""
from collections import OrderedDict

LINHA = 64            # bytes por linha
CAPACIDADE = 32 * 1024  # 32 KB
LINHAS = CAPACIDADE // LINHA  # 512 linhas


def simular(trace, vias):
    conjuntos = LINHAS // vias
    cache = [OrderedDict() for _ in range(conjuntos)]  # tag -> True, mais antigo primeiro
    ref = OrderedDict()                                 # referência totalmente associativa
    vistos = set()
    hits = comp = cap = conf = 0
    for end in trace:
        bloco = end // LINHA
        idx = bloco % conjuntos
        tag = bloco // conjuntos
        ref_acerto = bloco in ref
        if ref_acerto:
            ref.move_to_end(bloco)
        else:
            if len(ref) >= LINHAS:
                ref.popitem(last=False)
            ref[bloco] = True
        conj = cache[idx]
        if tag in conj:
            conj.move_to_end(tag)  # LRU: o acerto vira o mais recente
            hits += 1
        else:
            if bloco not in vistos:
                comp += 1
            elif not ref_acerto:
                cap += 1
            else:
                conf += 1
            if len(conj) >= vias:
                conj.popitem(last=False)  # remove o menos recentemente usado
            conj[tag] = True
        vistos.add(bloco)
    total = len(trace)
    return {"acessos": total, "hits": hits, "misses": total - hits,
            "compulsorio": comp, "capacidade": cap, "conflito": conf,
            "taxa_miss": (total - hits) / total}


def trace_passo_4kb(passadas=10):
    # 9 endereços separados por 4 KB, percorridos em ciclo
    base = [k * 4096 for k in range(9)]
    return base * passadas


def trace_varredura(tamanho=64 * 1024, passadas=2):
    # vetor de int de 4 bytes lido em ordem, duas vezes
    seq = [i * 4 for i in range(tamanho // 4)]
    return seq * passadas


CONFIGS = [("direto (1 via)", 1), ("2 vias", 2), ("8 vias", 8), ("totalmente (512 vias)", 512)]

if __name__ == "__main__":
    for nome, trace in [("A) passo de 4 KB, 9 endereços em ciclo, 10 passadas", trace_passo_4kb()),
                        ("B) varredura de 64 KB em ordem, 2 passadas", trace_varredura())]:
        print(nome)
        print(f"{'configuração':<24}{'conjuntos':>10}{'acessos':>9}{'misses':>8}{'taxa':>9}"
              f"{'comp.':>7}{'cap.':>7}{'conf.':>7}")
        for rotulo, vias in CONFIGS:
            r = simular(trace, vias)
            print(f"{rotulo:<24}{LINHAS // vias:>10}{r['acessos']:>9}{r['misses']:>8}"
                  f"{r['taxa_miss'] * 100:>8.2f}%{r['compulsorio']:>7}{r['capacidade']:>7}{r['conflito']:>7}")
        print()
O comando usado foi este, e a saída veio sem edição.
python3 cache_sim.pyA) passo de 4 KB, 9 endereços em ciclo, 10 passadas
configuração conjuntos acessos misses taxa comp. cap. conf.
direto (1 via) 512 90 27 30.00% 9 0 18
2 vias 256 90 36 40.00% 9 0 27
8 vias 64 90 90 100.00% 9 0 81
totalmente (512 vias) 1 90 9 10.00% 9 0 0
B) varredura de 64 KB em ordem, 2 passadas
configuração conjuntos acessos misses taxa comp. cap. conf.
direto (1 via) 512 32768 2048 6.25% 1024 1024 0
2 vias 256 32768 2048 6.25% 1024 1024 0
8 vias 64 32768 2048 6.25% 1024 1024 0
totalmente (512 vias) 1 32768 2048 6.25% 1024 1024 0Os números batem com a conta da estrutura. No padrão A, a organização direta tem 512 conjuntos, e os blocos de índice 0 e 8 caem no mesmo conjunto. Os blocos 0 e 8 disputam uma via e erram a cada passada depois da primeira. A conta é 9 misses compulsórios, mais 2 por passada em 9 passadas, o que dá 9 mais 18, ou 27 misses. Na organização de 2 vias, os blocos 0, 4 e 8 caem no mesmo conjunto de 256, e são 3 blocos para 2 vias: 9 mais 3 vezes 9, ou 36 misses. Na de 8 vias, os 9 blocos caem no mesmo conjunto de 8 vias: 9 mais 9 vezes 9, ou 90 misses. A totalmente associativa tem 512 vias, e os 9 blocos cabem: só os 9 misses compulsórios.
No padrão B, o vetor tem 16384 inteiros de 4 bytes, ou 2048 linhas. Cada passada faz 1024 misses, porque 2048 linhas não cabem em 512 entradas, e a segunda passada encontra as linhas já expulsas. Isso dá 2048 misses em 32768 acessos, ou 6,25%, em todas as organizações. Os 1024 compulsórios são da primeira passada, e os 1024 de capacidade são da segunda. Não há conflito, porque o padrão é sequencial.
A máquina desta aula foi consultada com o comando abaixo. Ele mostra a geometria que a seção 4.2 usa para o Apple M1 Max.
sysctl hw.perflevel0.l1icachesize hw.perflevel0.l1dcachesize hw.perflevel0.l2cachesize hw.perflevel1.l1dcachesize hw.perflevel1.l2cachesize hw.cachelinesize hw.cachesizehw.perflevel0.l1icachesize: 196608
hw.perflevel0.l1dcachesize: 131072
hw.perflevel0.l2cachesize: 12582912
hw.perflevel1.l1dcachesize: 65536
hw.perflevel1.l2cachesize: 4194304
hw.cachelinesize: 128
hw.cachesize: 3370532864 65536 4194304 0 0 0 0 0 0 0O sysctl confirma o tamanho da linha, que é de 128 bytes, e os tamanhos de cache dos dois tipos de núcleo: 128 KB de L1 de dados e 12 MB de L2 no núcleo de desempenho, e 64 KB de L1 de dados e 4 MB de L2 no núcleo de eficiência. Ele não informa a associatividade, e por isso esse número fica fora da conta.
8. Exercícios
Pratique com as questões abaixo. As resoluções vêm logo depois, com a conta à mão.
Questão 1
Na L1 de 32 KB, com 8 vias e linhas de 64 bytes, calcule a tag, o índice e o deslocamento do endereço 0xBEEF. Lembre que 0xBEEF vale 48879 em decimal.
Questão 2
Um cache de 256 KB, com 4 vias e linhas de 128 bytes, serve um processador de endereços de 32 bits. Quantos bits tem cada campo: tag, índice e deslocamento?
Questão 3
Um conjunto de 4 vias recebe, nesta ordem, os acessos A, B, C, D, A e E. Qual bloco sai da cache com a política LRU exata? Depois, refaça a conta para a árvore de pseudo-LRU com a sequência de acessos 0, 1, 2, 3 (sem o último acesso à via 0). Qual via a árvore escolhe?
Questão 4
Um laço escreve 10 vezes em 4 bytes da mesma linha, e a linha sai da cache depois disso. Compare o número de bytes transferidos com write-through e com write-back, no modelo simples desta aula. Depois, descubra a partir de quantas escritas na mesma linha o write-back passa a transferir menos bytes.
Resoluções
Resolução da Questão 1
O deslocamento são os 6 bits menores. Como 0xBEEF vale 48879, e 48879 dividido por 64 dá 763 com resto 47, o deslocamento é 47. Esse é o resto da divisão, que equivale aos 6 bits baixos do endereço.
O índice são os 6 bits seguintes, que são o quociente 763 com a máscara de 6 bits. Temos 763 módulo 64, que dá 59. Logo, o índice é 59, e o endereço procura o conjunto 59.
A tag são os bits que sobram, ou seja, o endereço dividido por 4096, que é 48879 dividido por 4096, com quociente 11. Em hexadecimal, 11 é 0xB. Logo, a tag é 0xB.
Resumindo: tag 0xB, índice 59 e deslocamento 47.
Resolução da Questão 2
Primeiro, o número de linhas: 256 KB dividido por 128 bytes dá 2048 linhas. Depois, o número de conjuntos: 2048 dividido por 4 vias dá 512 conjuntos.
O índice precisa de 9 bits, porque 2 elevado a 9 é 512. O deslocamento precisa de 7 bits, porque 2 elevado a 7 é 128. A tag recebe o resto: 32 menos 9 menos 7, o que dá 16 bits.
Resolução da Questão 3
Com LRU exato, a ordem após A, B, C e D é D, C, B, A, de modo que A é a vítima. O acesso a A é um hit, e a ordem vira A, D, C, B, com B como vítima. O miss em E expulsa B. A resposta é B.
Com pseudo-LRU, siga a convenção da seção 4.6. Após os acessos 0, 1, 2 e 3, a raiz vale 0, porque o último acesso foi à direita, e o nó esquerdo vale 0, porque o acesso à via 1 o deixou apontando para a via 0. A conta fica: o acesso à via 0 põe a raiz em 1 e o nó esquerdo em 1; o acesso à via 1 põe o nó esquerdo em 0; o acesso à via 2 põe a raiz em 0 e o nó direito em 1; o acesso à via 3 põe o nó direito em 0. Com a raiz em 0, a busca vai à esquerda, e o nó esquerdo em 0 aponta para a via 0. A árvore escolhe a via 0. O LRU exato também escolheria a via 0, porque ela foi usada pela primeira vez no passo 1 e nunca mais. Nesse caso, a aproximação acerta.
Resolução da Questão 4
Com write-through, cada uma das 10 escritas de 4 bytes vai à RAM, o que dá 10 vezes 4, ou 40 bytes transferidos.
Com write-back, as 10 escritas ficam na cache, e a linha suja sai uma vez, com 64 bytes. O total é 64 bytes.
Nesse caso, o write-through transfere menos bytes. O ponto de virada acontece quando o número de escritas, n, faz 4 vezes n igualar 64. Então n vale 16. A partir de 17 escritas na mesma linha, o write-back passa a transferir menos bytes. Esse é um modelo simples, em que as escritas são todas do mesmo tamanho, a linha sai uma só vez e não há leituras no meio. Com write-through combinado em buffers, a conta muda, e isso não foi medido nesta aula.
9. Glossário
Tag: parte alta do endereço, guardada em cada linha para dizer qual bloco da RAM ela contém.
Índice: campo do endereço que escolhe o conjunto onde o bloco pode estar.
Deslocamento (offset): campo de bits menos significativos do endereço, que escolhe o byte dentro da linha.
Linha de cache (cache line): unidade de transferência entre a RAM e o cache. Tem 64 bytes na referência desta aula.
Conjunto: grupo de linhas que compartilham o mesmo índice.
Via: posição de uma linha dentro de um conjunto. Um conjunto de N vias tem N posições possíveis para um bloco.
Bit V (válido): indica se a entrada guarda dados válidos.
Bit D (sujo): indica que a linha foi alterada desde que chegou da RAM, e precisa ser gravada ao sair (write-back).
Hit (acerto): acesso em que o dado está no nível consultado.
Miss (falha): acesso em que o dado não está no nível consultado, e precisa vir do nível de baixo.
Miss compulsório: primeiro acesso a um bloco, em que nenhuma cópia existe.
Miss de capacidade: miss que também ocorreria numa cache totalmente associativa do mesmo tamanho.
Miss de conflito: miss que não ocorreria numa cache totalmente associativa do mesmo tamanho, causado por um conjunto cheio.
Vítima: linha escolhida para sair quando um conjunto cheio precisa receber um bloco novo.
LRU (least recently used): política que expulsa o bloco usado há mais tempo.
PLRU (pseudo-LRU): aproximação do LRU com bits numa árvore, usada para economizar hardware.
Write-through: política em que cada escrita na cache também vai ao nível de baixo.
Write-back: política em que a escrita fica na cache, e a linha suja só é gravada no despejo.
Write-allocate: política em que um miss de escrita traz a linha para a cache antes de escrever.
Associatividade: número de vias por conjunto. Com 1 via, a organização é direta; com todas as linhas em um conjunto, é totalmente associativa.
Stride (passo): distância entre dois acessos sucessivos a um vetor ou matriz.
AMAT (tempo médio de acesso à memória): tempo de acerto mais a taxa de miss vezes a penalidade de miss.
O que não foi confirmado
Esta seção lista o que a aula afirma sem fonte primária ou medição própria.
A geometria do L1 de dados do Zen 4 (32 KB, 8 vias, linhas de 64 bytes e write-back) vem do WikiChip e de um resumo de busca do Chips and Cheese. O guia de otimização da AMD, documento 56665, não foi aberto nesta consulta.
A associatividade da L1 do Apple M1 Max não foi consultada. O sysctl confirma o tamanho da linha e da L1, mas não o número de vias.
As linhas de 128 bytes dos POWER7 a POWER9 vêm do WikiChip e da discussão do LLVM, citadas na aula 4.1. Não foram lidas no manual da IBM.
O tempo de acerto de 8 vias no exemplo da seção 5 é uma suposição de igualdade com o mapeamento direto. Esse tempo não foi medido.
O exemplo de AMAT usa 14 ciclos de penalidade para o L2, com a referência desta trilha. Ele é modelo, e não medição de um miss real, que também depende de vítimas sujas.
A taxa de miss de 30% para a organização direta e de 100% para 8 vias, no padrão de passo de 4 KB, é do simulador com LRU exato. Não é medição de hardware. Um processador com pseudo-LRU pode dar outro número.
O write-allocate, a política de escrita em miss, não foi lido nas fontes desta consulta. A página da Wikipedia consultada foi cortada antes dessa parte. A descrição desta aula é conceitual.
A taxonomia dos três Cs é atribuída a Mark Hill e a Hill e Smith, em trabalhos de 1987 e 1989. Esses trabalhos não foram lidos nesta consulta, e a atribuição vem da bibliografia citada abaixo, sem conferência direta.
A aula não verificou qual árvore de pseudo-LRU cada processador real usa. O exemplo da seção 4.6 segue uma árvore de convenção própria, que ilustra o mecanismo.
A indexação da L1 por endereço virtual ou físico, o número de bits de endereço físico de cada processador e a relação de inclusão entre níveis não foram confirmados para as máquinas citadas. O endereço de 48 bits da seção 4.1 é só uma conta de exemplo.
O efeito do padding de 4160 bytes na seção 6 é conta do modelo, e não foi medido.
Nenhuma latência ou taxa de miss de hardware real foi medida nesta aula. Os números de latência da L1, da L2 e da L3 vêm da aula 4.1, e são de uma CPU de referência convertida a 4,0 GHz, como aquela aula explica.
Fontes
Consultadas em 2 de novembro de 2026.
- Wikipedia (em inglês). “Cache replacement policies”. LRU com custo crescente, “generally > four ways”; PLRU com um bit por item e árvore de ponteiros; substituição aleatória e seu uso em processadores ARM. Disponível em: https://en.wikipedia.org/wiki/Cache_replacement_policies
- Wikipedia (em inglês). “CPU cache”. Write-through e write-back, bit dirty, mapeamento direto, associativo e totalmente associativo, decomposição do endereço em tag, índice e deslocamento. Leitura parcial, até cerca de 100 mil dos 178 mil caracteres da página. Disponível em: https://en.wikipedia.org/wiki/CPU_cache
- WikiChip. “Zen 4”, com L1 de dados de 32 KiB, 8 vias, linha de 64 bytes e write-back. Lido pelo resumo de busca. Disponível em: https://en.wikichip.org/wiki/zen_4
- Chips and Cheese. “Details on the Gigabyte Leak”, com L1 de dados de 32 KB e 8 vias para Zen 3 e Zen 4. Lido pelo resumo de busca. Disponível em: https://chipsandcheese.com/p/details-on-the-gigabyte-leak
- Chips and Cheese. “AMD’s Mild Hybrid Strategy: Ryzen Z1 in ASUS’s ROG Ally”, 12 de fevereiro de 2024. Latências de L1, L2, L3 e memória principal reaproveitadas da aula 4.1. Disponível em: https://chipsandcheese.com/p/amds-mild-hybrid-strategy-ryzen-z1-in-asuss-rog-ally
- Medição local: sysctl em um MacBook Pro com Apple M1 Max, macOS 27.0.1, executado em 2 de novembro de 2026. A saída está na seção 7.
- Bibliografia citada sem leitura nesta consulta: HENNESSY, John L.; PATTERSON, David A. Computer Architecture: A Quantitative Approach. 6. ed. Cambridge: Morgan Kaufmann, 2017. Capítulo sobre hierarquia de memória. HILL, Mark D.; SMITH, Alan J. “Evaluating Associativity in CPU Caches”. IEEE Transactions on Computers, 1989.
Relacionados
- Trilha de Hardware
- Hierarquia de memória e localidade
- SRAM, DRAM e armazenamento
- Pipeline, cache e paralelismo
- ULA e registradores
- Aula 4.4, Endereçamento, alinhamento e endianness, ainda não escrita.